انویدیا مدل GR00T 2 را منتشر کرد که کنترل ربات را با پیشبینی چند ثانیهای از نمای دوربین بهجای صدور مستقیم فرمانهای موتور انجام میدهد. این مدل جهان-عمل (WAM) بر روی بیش از ۱۰۰۰ چیپ GB300 و با ۴۰۰٬۰۰۰ ساعت ویدیوی اولشخص آموزش دیده است. این رویکرد با نسخه قبلی که ۴۰ درصد موفقیت Zero-shot در ۵۰ وظیفه جدید داشت متفاوت است. نتایج این مدل در مقایسه با ۹۶ درصد موفقیت جیمینی رباتیکس در خط تولید مرسدس قابل توجه است. عدم دسترسی به ورودی لمسی مشابه چالشهایی است که مدل Neuron AI با اضافه کردن حس لامسه به رباتها سعی در حل آن دارد.
GR00T 2 انویدیا: پیشبینی ویدیو بهجای تلفنعملیات
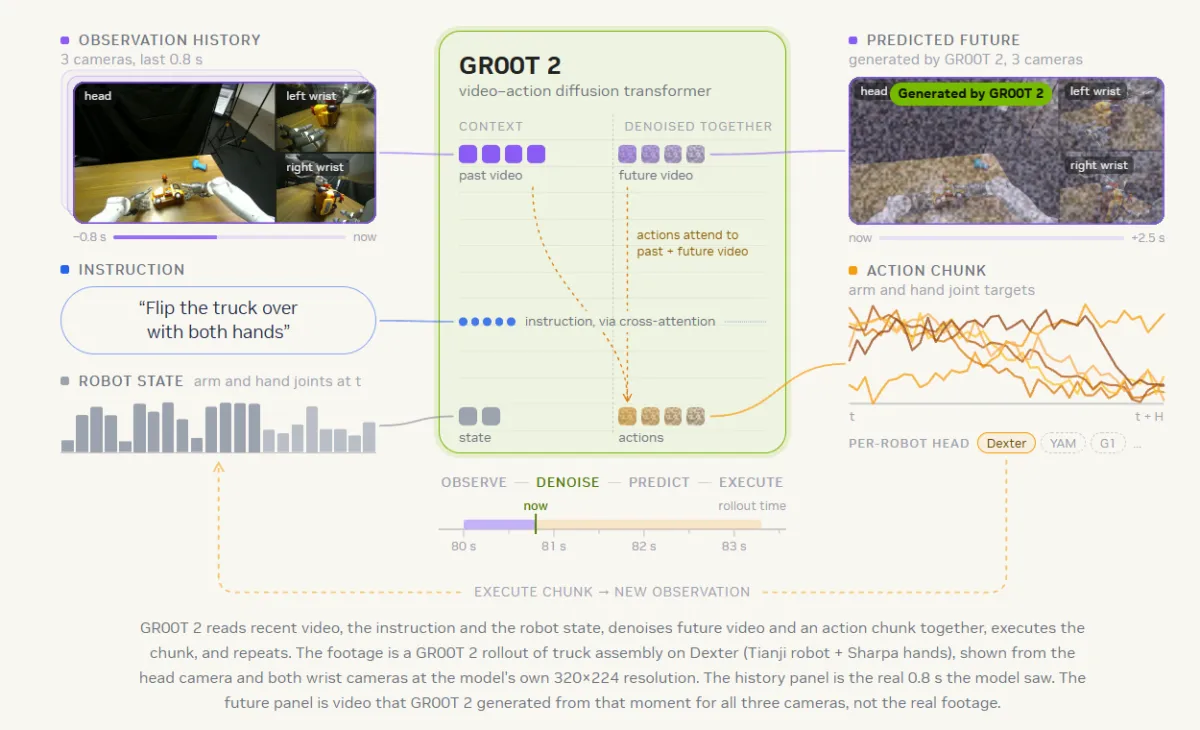
تلفنعملیات — راهنمایی از راه دور ربات توسط اپراتور انسانی — سالها مانع مقیاسدهی رباتیک بوده است. هر مدل رباتی جدید دادههای اختصاصی خود را میطلبد. GR00T 1 تصاویر دوربین و دستورات زبانی را مستقیماً به حرکات موتور ترجمه میکرد. GR00T 2 این لولهخط را با یک مدل جهان-عمل (World-Action Model) جایگزین کرد که از طریق مدل انتشار (Diffusion) ویدیوی آینده را تولید میکند و از همان ویدیو فرمان کنترل را استخراج میکند.
مکانیزم آموزش و انتقال
- مجموعه آموزشی: حدود ۴۰۰٬۰۰۰ ساعت ویدیو از دید اول شخص (Egocentric) از دوربینهای سر.
- محاسبات: بیش از ۱۰۰۰ چیپ GB300 در یک خوشه واحد.
- خروجیهای WAM: حرکت بعدی + کلیپ کوتاه ویدیوی آینده (بر پایه انتشار).
- مسیر انتقال: ویدیوی دست انسان → شبیهسازی → دادههای حرکتی اختصاصی ربات → فرمانهای کنترل.
- یک ویدیوی انسانی واحد برای یادگیری میخکوبی از طریق شبیهسازی کفایت کرد.
- برای ۵۰ کار در آستانه تسلط، کمتر از ۳ دقیقه تنظیم دقیق (Fine-tuning) موفقیت را از ۴۰٪ به ۹۵٪ رساند.
نتایج کلیدی تستها
- روشن کردن کبریت، برش موز، پرتاب بسته: ۱۰ تا ۸۰٪ موفقیت بدون تلفنعملیات.
- میخکوبی از یک ویدیو انسانی از طریق شبیهسازی.
- ۵۰ کار به ۹۵٪ موفقیت پس از زیر ۳ دقیقه تنظیم دقیق.
- مونتاژ ماشین اسباببازی: ۲۳٪ تنها، ۹۷٪ با برنامهریز GPT-6 Astra.
- GR00T 2 Turbo دوپا روی Jetson Thor: جمعآوری پاپکورن، خالی کردن میز، خشک کردن مایع با حوله زیر پا (نزدیک ۵۰٪ موفقیت).
- کارهای دقتطلب (کابل شبکه، شارژر) از طریق تلاش و خطای تکراری روی دستگاه واقعی آموزش دیدهاند.
ادغام مدل زبانی
برنامهریز سطح بالا (مانند GPT-6 Astra) کارهای طولانی را به مراحل میشکند، نقاط گیر را در تصویر دوربین رنگآمیزی میکند و وقتی قطعهای میریزد روتینهای کمکی را صدا میزند. قطعات پراکنده روی میز: سیستم ترکیبی در ۹۷٪ یا بیشتر از آزمایشها مونتاژ کرد. بدون برنامهریز و تنظیم دقیق تنها ۲۳ از ۱۰۰ مونتاژ موفق بود. هزینه تأخیر برنامهریز: در جدا کردن زباله، ربات تقریباً یکسوم کل زمان بیکار ماند، بهمیانگین بیش از ۷ ثانیه برای هر گام برنامهریزی منتظر ماند.
GR00T 2 Turbo برای انساننماها
نسخه سبکشده GR00T 2 Turbo جزئیات تصویری کمتری را پردازش میکند و مستقیماً روی کامپیوتر بورد Jetson Thor اجرا میشود. کارهای تست شده: جمعآوری پاپکورن، خالی کردن میز، خشک کردن مایع با حوله زیر پا. نرخ موفقیت حولهکشی: تازه زیر ۵۰٪.
محدودیتها و چالشهای باز
- هیچ ورودی مستقیم سنسور لمسی (Force-Torque) وجود ندارد؛ خطاهای ظریف مانند پیچهای نیمچرخه از بین میروند.
- برنامهریز زبانی تأخیر قابلتوجهی ایجاد میکند (بیش از ۷ ثانیه در هر گام).
- محققان هر دو شکاف را پیششرط استقرار قابلاعتماد در دنیای واقعی میدانند.
- آزمایشگاههای دیگر نیز در حال پیگیری کاهش تلفنعملیات هستند (مراجعه به AI Radar #5 درباره Neolabs).
گفتگو