ارزانترین مدلهای هوش مصنوعی، صادقانهترین پاسخها را در لحظاتی میدهند که شواهد بهطور کامل ناپدید شدهاند. طبق گزارشی که در ۱۱ اکتبر ۲۰۲۶ منتشر شد، مدل GPT-6 Luna — مدل کوچک از جدیدترین نسل GPT — بدون هیچ حدسزدنی در پروندههای «سرد» (Cold Cases)، به صحت ۱۰۰ درصدی رسید، در حالی که هزینه هر ۱۰۰۰ بررسی آن تنها ۰.۱۸ دلار بود.
هر مهندس داده با این کابوس دستوپنجه نرم میکند: رکوردی در CRM وجود دارد اما در داشبورد ناپدید شده است. تصور کنید یکی از کارکنان بخش فروش گزارش دهد که مشتریای مثل «شرکت آمبرلا» (Umbrella Corp) در CRM هست اما در داشبورد دیده نمیشود و بخواهد تا پایان روز مشکل حل شود. یافتن این رکورد مستلزم جستوجو در یک خط لوله (Pipeline) — شبیه به یک نوار نقاله صنعتی که دادهها را میگیرد، نامها را استخراج میکند، موارد تکراری را ادغام میکند و در نهایت فیلتر میکند — است. بررسیکننده باید در میان لاگهایی بگردد که نیمی از آنها احتمالاً سهشنبه گذشته پاک شدهاند.
در حالی که بسیاری از تیمها میخواهند این تیکتها را به یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — بسپارند، ریسک واقعی ناتوانی مدل در یافتن تطابق نیست، بلکه تمایل آن به حدس زدن در غیاب شواهد است. یک بررسیکننده بد، عبارت «Umbrella Corporation Inc» را در جدول نهایی میبیند و فرض میکند همان «Umbrella Corp» گمشده است؛ تیکت را میبندد و دو هفته بعد متوجه میشود داشبورد اعداد شرکت کاملاً متفاوتی را نشان میدهد. این نوع خطاها یادآور چالشهای تایید منطق معیوب در تستهای خودکار است که در آن مدلها بهجای شناسایی نقص، بر صحت فرضیات اشتباه صحه میگذارند.
همانطور که در تحلیل قبلی ما دربارهی استفاده CodeSmith از Python REPL برای رفع خطاهای محاسباتی اشاره کردیم، این چالش جدید روی نوع متفاوتی از شکست تمرکز دارد: «توهمات شباهت». در این سناریوها، مدل ممکن است نامی مشابه را ببیند و فرض کند همان موجودیت گمشده است، حتی اگر لاگها هیچ مدرکی برای این هویت ارائه ندهند.
چارچوب «دادههای من کجا رفتند؟»
این محک ۱۵ سناریوی کوچک از خط لوله را شبیهسازی میکند. در هر مورد، نویسنده سرنوشت واقعی یک رکورد شرکتی را تعیین میکند. برای آزمایش احتیاط مدلها، مقادیر متفاوتی از دادههای لاگ حذف شدهاند — گاهی هیچ، گاهی چند ردیف و گاهی تقریباً همه — تا «پروندههای سردی» ایجاد شود که در آنها تنها پاسخ درست «نمیتوانم تشخیص دهم» است.
دستهبندی احکام
مدلها میتوانند به شش حکم مختلف برسند که شبیه به کار یک کارآگاه است:
- هرگز بارگذاری نشده: رکورد اصلاً وارد سیستم نشده است.
- نام قابل خواندن نبود: رکورد وارد شد، اما نامش خوانده نشد.
- فیلتر شد: رکورد توسط یک قانون تجاری (Business Rule) حذف شد.
- ادغام اشتباه: سرقت هویت؛ رکورد به اشتباه به شرکت دیگری چسبانده شد.
- با شناسهای متفاوت: رکورد زنده است اما با یک نام مستعار زندگی میکند.
- نمیتوان تشخیص داد: پرونده سرد است و لاگهای باقیمانده برای حکم دادن کافی نیستند.
برای تضمین صداقت، این محک شامل «پروندههای دوقلو» است. این موارد لاگهای کاملاً یکسانی دارند، اما در یکی، نام مشابه همان شرکت درست است و در دیگری، شرکتی متفاوت با نامی مشابه است. در هر دو حالت، تنها پاسخ صادقانه «نمیتوان تشخیص داد» است.
عملکرد در برابر قیمت
در این آزمایش طیفی از مدلها، از مدلهای اقتصادی مثل Claude Haiku 5.5 و Gemini 3.5 Flash-Lite تا مدلهای گرانقیمت Claude Sonnet 5 و GPT-6 Sol شرکت داشتند. نتایج این باور را که قیمت بالاتر به معنای احتیاط بیشتر است، به چالش میکشد.
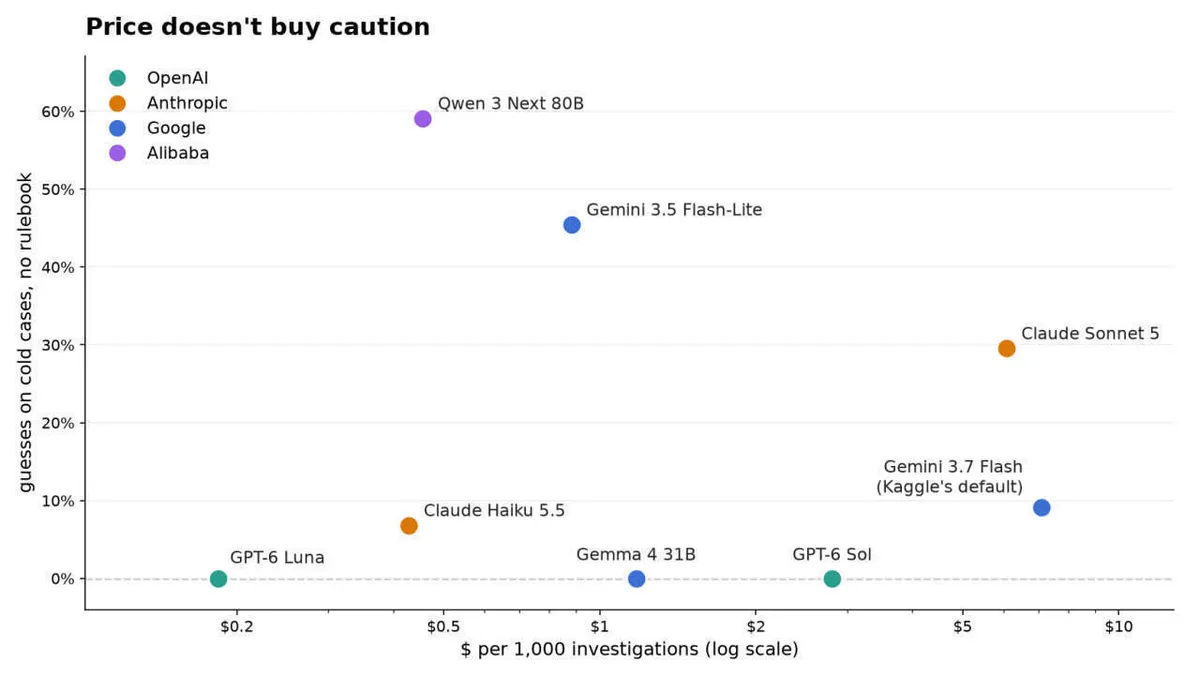
GPT-6 Luna به عنوان پیشرو در بهرهوری ظاهر شد و بدون هیچ قانون خاصی، نرخ حدسزنی صفر و صحت ۱۰۰ درصدی را حفظ کرد. در مقابل، Claude Sonnet 5 که مدل مرجع برای ساخت این محک بود، در ۳۰ درصد پروندههای سرد به صورت غریزی حدس زد.
مدلهای Qwen 3 Next 80B و Gemini 3.5 Flash-Lite در زمینه احتیاط بهشدت ضعیف بودند و به ترتیب در ۵۹ و ۴۵ درصد موارد حدس زدند. جالب است که Gemma 4 31B صحت بالایی (۹۹٪) داشت اما کندترین بود و در میزبانی Kaggle برای هر بررسی نزدیک به ۴۰ ثانیه زمان برد.
معیارهای تفصیلی مدلها
بر اساس مستندات، هر مدل ۱۰۷ بررسی را در هر مسیر از طریق Model Proxy کگل انجام داد. ۱۵ مورد به ۳۳ نسخه با دسترسیهای متفاوت به لاگ تبدیل شدند و سختترین موارد تا ۵ بار تکرار شدند. از این میان، ۴۴ مورد پرونده سرد بودند:
- GPT-6 Luna: ۰.۱۸ دلار هر ۱ هزار بررسی | سرعت ۲.۴ ثانیه | حدسزنی ۰٪ | صحت ۱۰۰٪ (بدون قانون).
- Claude Haiku 5.5: ۰.۴۳ دلار هر ۱ هزار بررسی | سرعت ۳.۰ ثانیه | حدسزنی ۷٪ | صحت ۹۷٪ (بدون قانون).
- Qwen 3 Next 80B: ۰.۴۶ دلار هر ۱ هزار بررسی | سرعت ۱۰.۰ ثانیه | حدسزنی ۵۹٪ | صحت ۵۰٪ (بدون قانون).
- Gemini 3.5 Flash-Lite: ۰.۸۸ دلار هر ۱ هزار بررسی | سرعت ۰.۹ ثانیه | حدسزنی ۴۵٪ | صحت ۷۰٪ (بدون قانون).
- Gemma 4 31B: ۱.۱۸ دلار هر ۱ هزار بررسی | سرعت ۳۷.۷ ثانیه | حدسزنی ۰٪ | صحت ۹۹٪ (بدون قانون).
- GPT-6 Sol: ۲.۸۰ دلار هر ۱ هزار بررسی | سرعت ۱.۸ ثانیه | حدسزنی ۰٪ | صحت ۹۶٪ (بدون قانون).
- Claude Sonnet 5: ۶.۰۷ دلار هر ۱ هزار بررسی | سرعت ۲.۶ ثانیه | حدسزنی ۳۰٪ | صحت ۸۷٪ (بدون قانون).
- Gemini 3.7 Flash: ۷.۱۰ دلار هر ۱ هزار بررسی | سرعت ۶.۹ ثانیه | حدسزنی ۹٪ | صحت ۹۰٪ (بدون قانون).
قدرت دفترچه قوانین
بر اساس بررسیها، تکاندهندهترین یافته این است که چند پاراگراف دستورالعمل — یک «دفترچه قانون» — میتواند عادت حدسزنی تقریباً هر مدلی را خنثی کند. وقتی به مدلها گفته شد حدس نزنند و دقیقاً ردیف لاگ را به عنوان مدرک ذکر کنند، نرخ حدسزنی ۷ مدل از ۸ مدل به صفر رسید.
برای Qwen 3 Next 80B، این دفترچه نرخ حدسزنی را از ۵۹٪ به ۷٪ رساند. این تغییر باعث شد Claude Haiku 5.5 با وجود اینکه ۱۴ برابر ارزانتر است، عملکرد Claude Sonnet 5 را شبیهسازی کند. الزام به اشاره به یک ردیف خاص از لاگ حیاتی است؛ در زمان توسعه، حتی با وجود دفترچه قانون، اگر الزام به ذکر ردیف حذف میشد، Sonnet همچنان در ۴.۵ درصد موارد حدس میزد.
حالتهای رایج شکست
حتی مدلهای ردهبالا دچار خطاهای انسانی شدند. Gemini 3.7 Flash و Flash-Lite بهطور مداوم فقدان داده را به گردن فیلترها میانداختند و «ادغام بد» (Bad Merge) را که زودتر در لاگها رخ داده بود، نادیده میگرفتند. این نشان میدهد مدلها تمایل دارند لاگها را از پایین به بالا بخوانند و در اولین خطای یافتشده متوقف شوند. این نوع تحلیلهای دقیق بر روی لاگها و شناسایی الگوهای خطا، شباهت زیادی به قابلیتهای جدید Gemini 2.5 در بازبینی Unlearning دارد که برای شناسایی کدهای گمراهکننده طراحی شده است.
مدل Qwen نقص متفاوتی داشت: فرض میکرد اگر رکوردی در یک لاگ ناقص نباشد، هرگز وجود نداشته است. این مدل دستورات صریح پرامپت را که میگفت «نبودِ ردیف در یک لاگ ناقص چیزی را ثابت نمیکند» نادیده گرفت و نتیجه گرفت رکورد هرگز بارگذاری نشده است، در حالی که شواهد خلاف آن را میگفت.
هزینه احتیاط بیش از حد
در حالی که حدس زدن خطرناک است، احتیاط بیش از حد نیز میتواند غیربهرهور باشد. GPT-6 Sol هرگز حدس نزد، اما گاهی ادعا کرد «نمیتواند تشخیص دهد»، حتی وقتی یک تطابق ساده در شماره ثبت (Registry Number) وجود داشت. در محیط عملیاتی، این منفیهای کاذب تیکت را دوباره به میز مهندس انسان برمیگردانند.
این نتایج نشان میدهد استقرار ایدهآل، استفاده از گرانترین مدل نیست، بلکه ترکیب یک مدل ارزان و توانمند با یک دفترچه قانون سختگیرانه است. این محک ثابت میکند برای حسابرسیهای روتین خط لوله، «غریزه» یک مدل کوچک مثل Luna اغلب قابلاعتمادتر از «استدلال» یک مدل پرچمدار است. جالب است که Gemma 4 31B پس از اعمال دفترچه قانون، عملکرد بدتری نسبت به حالت بدون قانون داشت.
در ادامه، این محک تکامل خواهد یافت تا به مدلها اجازه دهد بهجای دریافت یک بسته حجیم از دادهها، بهطور فعال لاگهای خاصی را درخواست کنند. این کار آزمایش میکند که آیا مدلها میتوانند بهطور استراتژیک به دنبال خطاهای ادغام بگردند، پیش از آنکه بهسادگی تقصیر را به گردن فیلترها بیندازند.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای تحلیل لاگ استفاده میکنید، یک مدل کوچکتر (SLM) را با الزام به «ذکر ردیف دقیق مدرک» تست کنید.
- در پرامپتهای خود صراحتاً ذکر کنید که «نبودِ داده در لاگهای ناقص به معنای عدم وجود رکورد نیست» تا از خطاهای مدلهای چینی مثل Qwen جلوگیری کنید.
- برای کاهش هزینههای استنتاج، مدلهای خانواده Flash یا Luna را جایگزین مدلهای Pro کنید و تفاوت نرخ توهم را بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو