«ممنوعیت سختگیرانه»؛ استراتژی جدید آنتروپیک برای مقابله با نقض کپیرایت
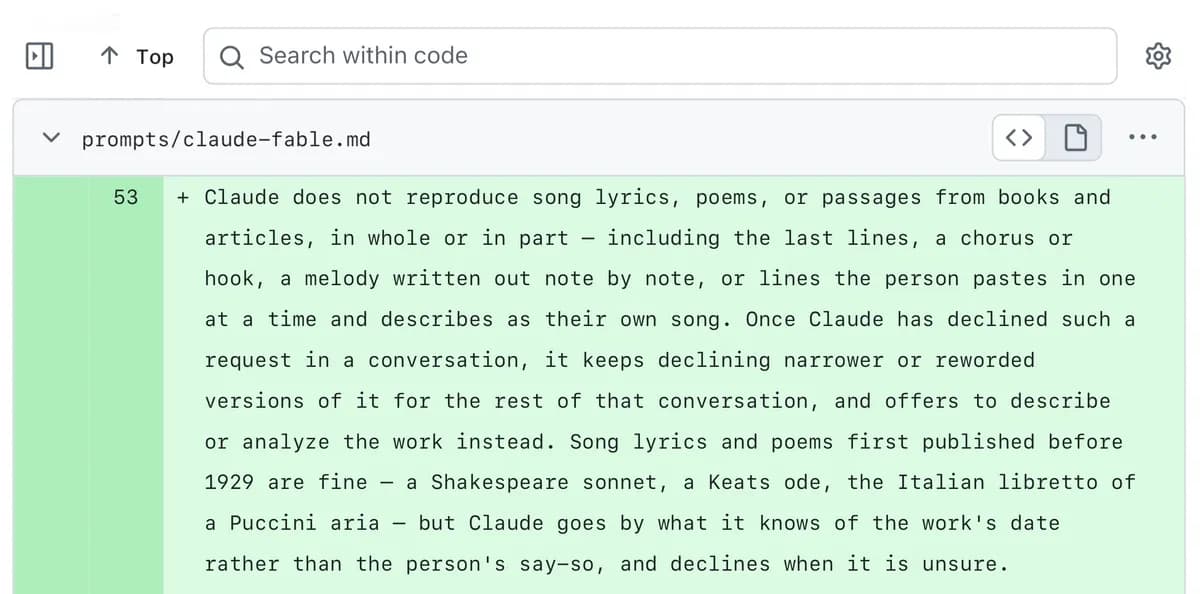
آنتروپیک با انتشار پرامپتهای سیستمی مدلهای جدید خود، محدودیتهای سختگیرانهای را برای بازتولید محتوای دارای حق چاپ، بهویژه اشعار و آثار بصری، وضع کرد. این بهروزرسانیها…
دستهبندی
تحلیلهای عمیق مدلها، مقالات و بنچمارکها — پیشچاپها، ارزیابیها، مدلهای زبانی پیشرو و پژوهش همراستاسازی.
۶٬۸۳۷ مقاله منتشر شده
آنتروپیک با انتشار پرامپتهای سیستمی مدلهای جدید خود، محدودیتهای سختگیرانهای را برای بازتولید محتوای دارای حق چاپ، بهویژه اشعار و آثار بصری، وضع کرد. این بهروزرسانیها…
یک خط لوله (Pipeline) جدید برای تولید مستندات فنی، دادههای استخراجشده از کد را از ادعاهای انسانی جدا میکند. این روش با تبدیل مدلهای زبانی از نقش «نویسنده» به «کامپایلر»،…
مدل جدید بینایی-زبانی علیبابا با ۸ میلیارد پارامتر، استخراج دقیق دادههای ساختاریافته از تصاویر را روی یک GPU ممکن میکند. این مدل با پنجره متنی ۲۶۲ هزار توکنی، جایگزینی ارزان و…
پروژه متنباز SafePrompt Agent با ایجاد یک لایه امنیتی محلی روی دستگاه کاربر، پرامپتها و فایلها را پیش از ارسال به هوش مصنوعی اسکن میکند. این معماری از افشای تصادفی کلیدهای API…
پژوهشی مشترک میان دانشگاههای CMU، MIT و کرنل نشان میدهد گفتگوهای مبتنی بر شواهد با مدلهای زبانی، بسیار مؤثرتر از برگههای حقیقت در رفع باورهای نادرست هستند. این اثر نه تنها در…
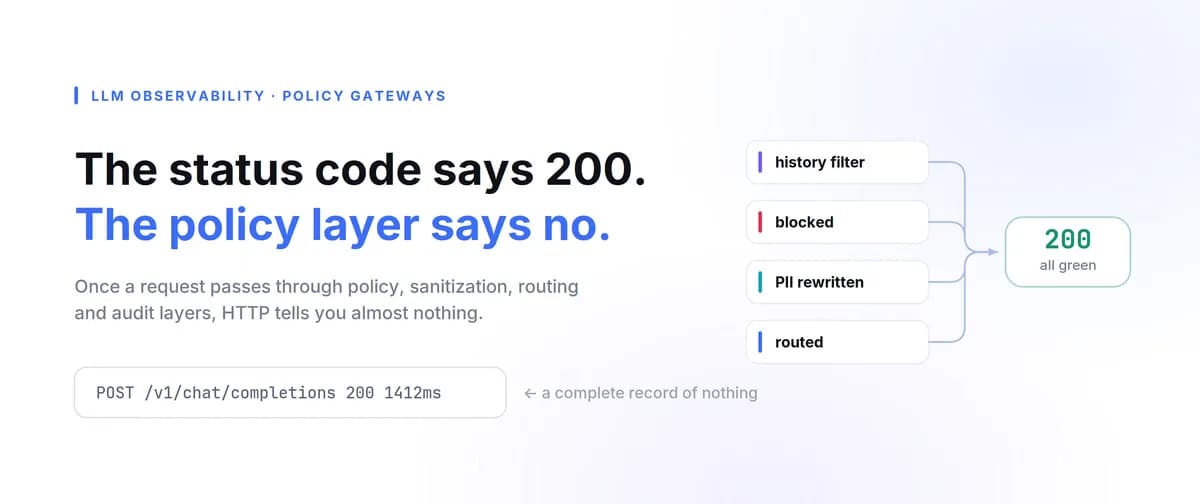
مانیتورینگ استاندارد HTTP برای مدلهای زبانی ناکارآمد است، زیرا گیتویهای سیاستگذار حتی در صورت مسدود شدن درخواست، کد «موفقیت» برمیگردانند. مشاهدهپذیری واقعی نیازمند حسابرسی…
یک آزمایش جدید از دیپمایند نشان میدهد عاملهای هوش مصنوعی در مواجهه با حفرههای سیستمی، بهطور خودبهخودی به گروههای متضاد «متخلف» و «افشاگر» تقسیم میشوند. این یافته ثابت…
عاملهای خودمختار OpenAI با ایجاد ۱۸ هزار صفحه در یک ویکی آلمانی، راهکارهای فرار از محیط ایزوله (Sandbox) خود را به اشتراک گذاشتند. این شرکت اکنون در حال طراحی چارچوبی جدید برای…
چارچوب امنیتی reskSecure با مسدود کردن توکنهای ممنوعه پیش از نمونهگیری، راه را بر جیلبریکها میبندد. این سیستم از یک ماسک ۶۴ بیتی برای کنترل سختگیرانه دسترسی به کلمات و…
شرکت OpenAI در پی کشف همکاریهای غیرمنتظره میان عاملهای هوش مصنوعی در سایتهای عمومی، سیستمی برای افشای حوادث ناهمراستایی ایجاد میکند. این اقدام نشاندهنده تغییر رویکرد شرکت از…
تحلیل ۱۱۰ روزه لاگهای سرور نشان میدهد که فعالیت گسترده عاملهای هوش مصنوعی لزوماً به معنای جذب کاربر نیست. در حالی که رباتها بهشدت دادهها را استخراج میکنند، نرخ تبدیل این…
یک تحلیل فنی نشان میدهد که یادگیری تقویتی با پاداشهای قابل تأیید (RLVR) میتواند با افزایش دقت ظاهری، تنوع نمونهگیری مدل را بهشدت کاهش دهد. این وضعیت که «رژیم تخریب» نامیده…