پردازش در لبه در برابر پردازش ابری برای بهینهسازی ارتباطات لحظهای
توسعهدهندگان برای کاهش تأخیر در پلتفرمهای ارتباطی، از مدلهای هوش مصنوعی در لبه شبکه استفاده میکنند. این رویکرد تمرکز را از پیامرسانی ساده به قابلیتهایی مثل ترجمه همزمان و…
موضوع
SLMs, on-device inference, mobile AI, AI PCs
۱٬۷۷۰ مقاله منتشر شده

توسعهدهندگان برای کاهش تأخیر در پلتفرمهای ارتباطی، از مدلهای هوش مصنوعی در لبه شبکه استفاده میکنند. این رویکرد تمرکز را از پیامرسانی ساده به قابلیتهایی مثل ترجمه همزمان و…

پایگاهداده جدید LatticeDB با ادغام گراف، جستوجوی برداری و نمایهسازی متنی در یک فایل واحد، نیاز به سرورهای مجزا را حذف میکند. این ابزار برای حافظهٔ عاملهای هوش مصنوعی و…

آیبیام دو مدل فشرده برای بازشناسی گفتار منتشر کرد که سرعت پردازش آنها ۱۲ هزار برابر بیشتر از زمان واقعی است. این مدلها با حذف کامل لایه زبانی، توان عملیاتی عظیمی را برای…

اپل با معرفی تراشههای M6 و M5 Ultra، سقف حافظه یکپارچه را به ۵۱۲ گیگابایت رساند. این جهش سختافزاری به توسعهدهندگان اجازه میدهد مدلهای زبانی بسیار بزرگ را بهطور کامل و بدون…

برنامهنویسان برای عبور از انتخاب سخت میان مدلهای محلی و APIهای ابری، به سمت گردشکار ترکیبی (Hybrid) حرکت میکنند. با سپردن کارهای تکراری به مدلهای محلی و استدلالهای پیچیده به…

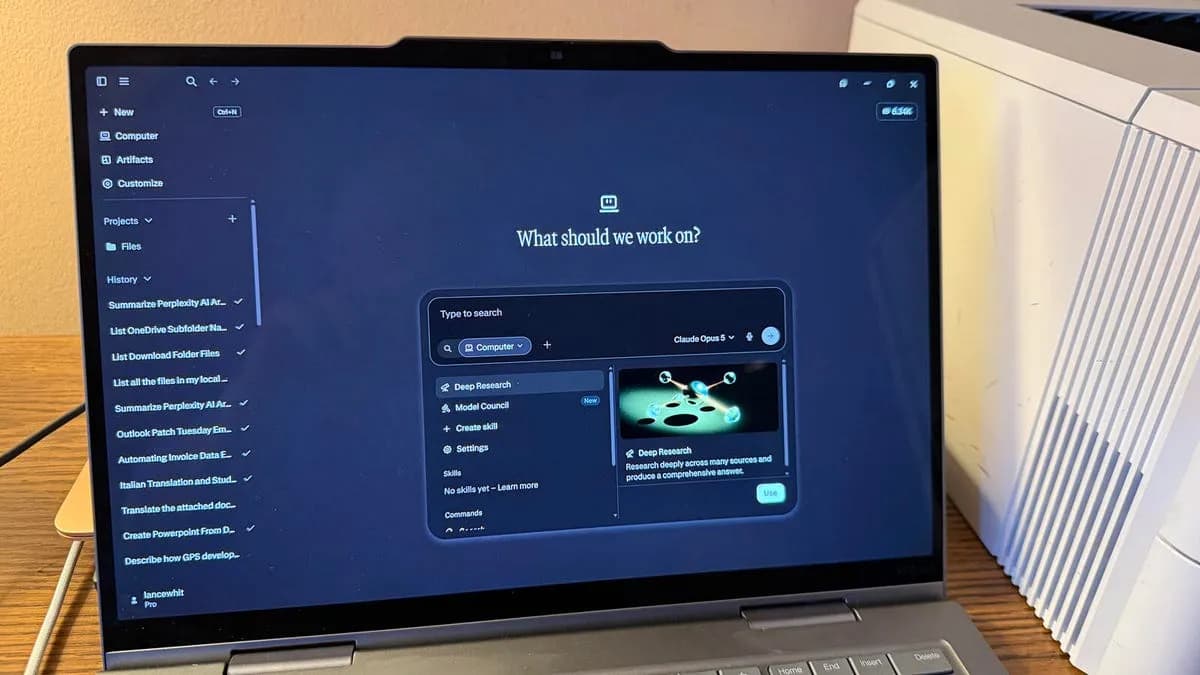
شرکت Perplexity ابزاری را معرفی کرد که پردازش عاملهای هوش مصنوعی را از ابر به سختافزار شخصی کاربر منتقل میکند. این رویکرد با هدف حذف هزینههای استنتاج و ارتقای حریم خصوصی برای…

اوکراین برای تسریع در توسعه سلاحهای خودکار، دسترسی استارتاپهای بریتانیایی به «مجموعه دادههای نظامی جامع» را فراهم کرد. این اقدام گسستی در روند آموزش مدلهاست و جایگزینی…

آنتروپیک و اوپنایآی با انتقال قابلیتهای عاملمحور به موبایل و پیامرسانها، مرز بین محیط کار و زندگی شخصی را از بین میبرند. این بهروزرسانیها گامی به سوی تبدیل هوش مصنوعی از…

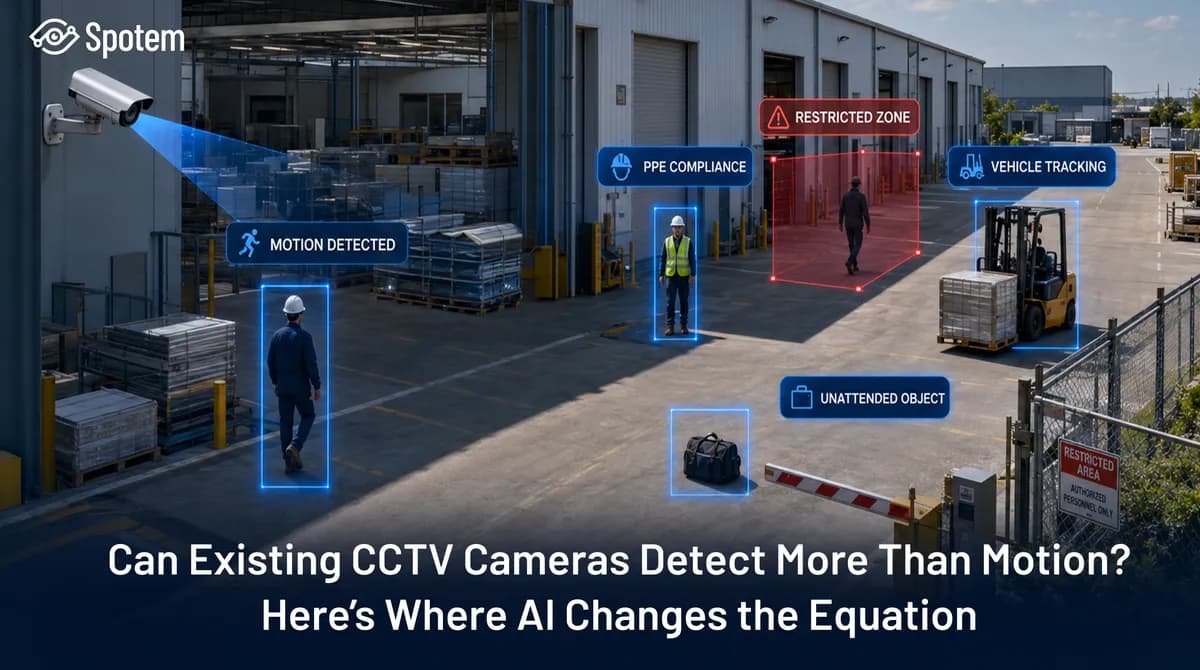
امنیت صنعتی از تشخیص سادهٔ حرکت به سمت طبقهبندی اشیا با هوش مصنوعی حرکت میکند. با افزودن یک لایه نرمافزاری به دوربینهای IP موجود، اپراتورها میتوانند بدون تعویض سختافزار،…

یک غیربرنامهنویس با استفاده از ترکیب مدلهای Claude، DeepSeek و Gemini توانست موتور عصبی FractalBrainOS را بر پایه C++17 توسعه دهد. این پروژه که اکنون متنباز شده است، هدفش ایجاد…

شرکت Multiverse Computing روشی به نام Quantization-Aware Healing (QAH) معرفی کرد که مدلهای فشرده ۴ بیتی را دقیقتر از نسخههای ۱۶ بیتی میکند. این تکنیک با بازیابی مستقیم دانش از…

پژوهشگران اپل نخستین قوانین مقیاسپذیری پیشبینیپذیر برای تقطیر دانش را تدوین کردند. این دستاورد، آموزش مدلهای کوچک را از یک فرآیند آزمون و خطا به یک مسئله بهینهسازی ریاضی دقیق…