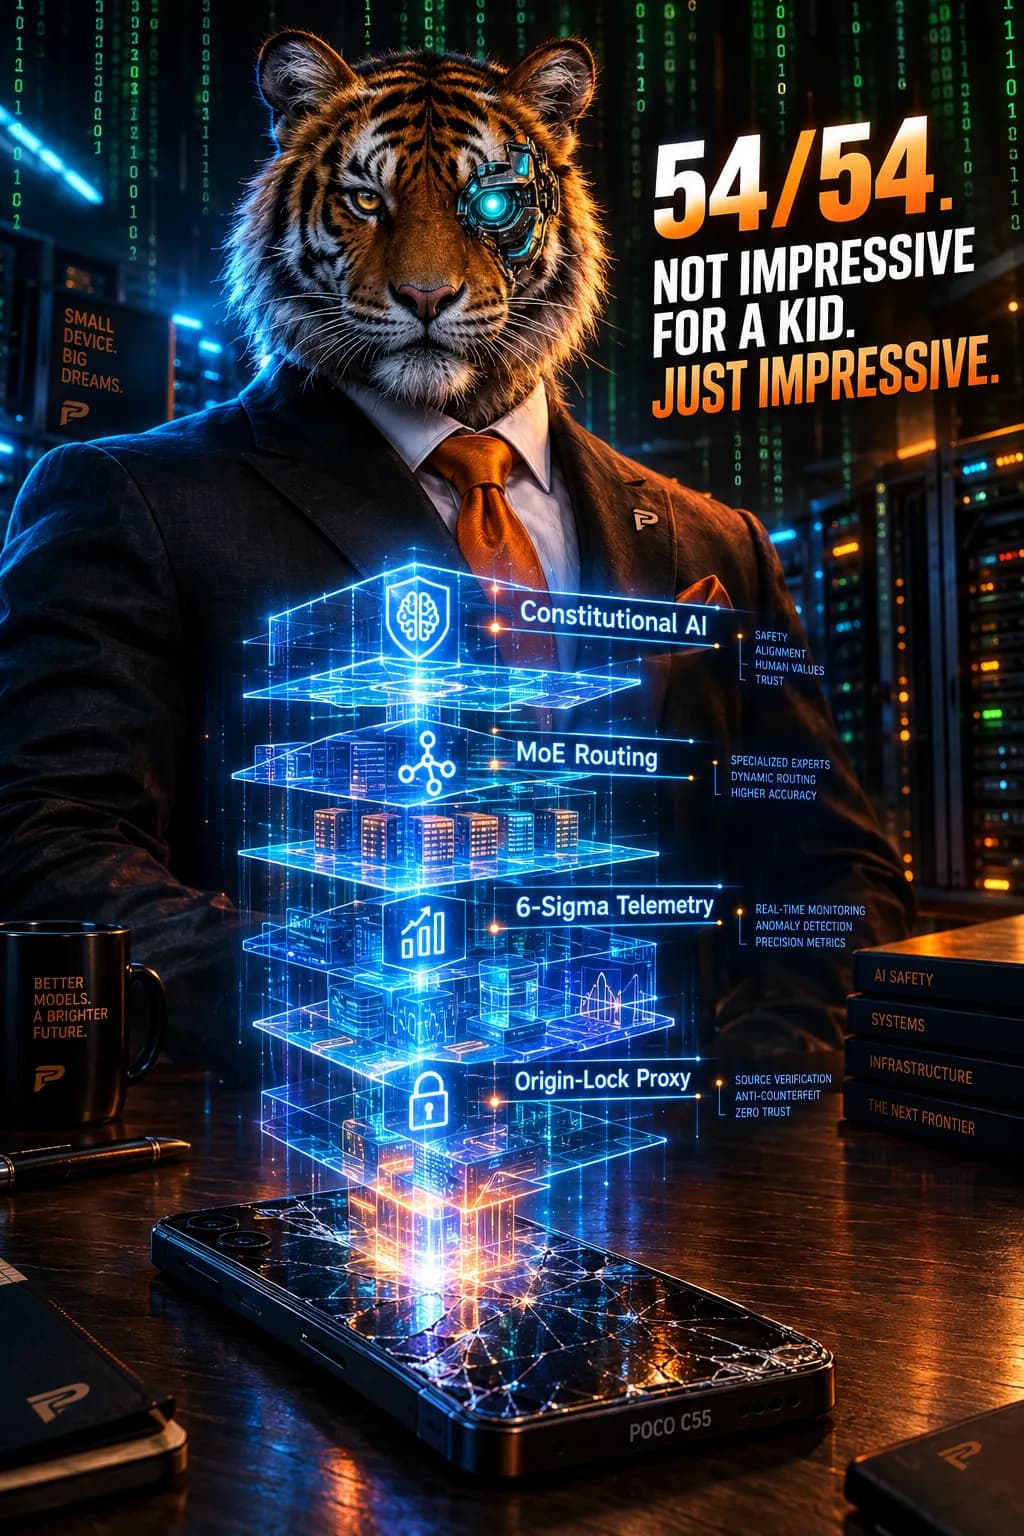
تصور کنید یک گوشی اندرویدی ارزانقیمت که برای کارهای ساده است، حالا به یک منتور کدنویسی سطح ارشد تبدیل شده باشد. این اتفاق برای توسعهدهندهای رخ داده که تنها ۱۲ سال دارد و توانسته است سختافزاری را به حداکثر بهرهوری برساند.
به نقل از گزارش dev.to، این نوجوان در ۳۰ سپتامبر ۲۰۲۶ اعلام کرد که سیستم او با نام KODA، در ۹ آزمون استرس صنعتی از آزمایشگاههای Anthropic، OpenAI و DeepSeek امتیاز کامل ۵۴ از ۵۴ را به دست آورده است. این پروژه روی یک گوشی POCO C55 با قیمت ۱۵۰ دلار اجرا میشود.
این دستاورد در حالی رخ میدهد که صنعت به سمت بهینهسازیهای افراطی حرکت میکند. همانطور که در تحلیل قبلی ما دربارهی نبرد هزینه هر وظیفه بین GPT-6.1 Sol و Claude Sonnet 5.5 اشاره کردیم، غولهای فناوری در حال رقابت بر سر هزینه هستند، اما KODA ثابت میکند که با مهندسی سختگیرانه، ابزارهای سطح بالا را میتوان روی سختافزارهای مصرفی پیاده کرد. این رویکرد یادآور الگوهای سادهسازی API برای توسعهدهندگان غیرمتخصص است که امکان ساخت ابزارهای پیچیده را بدون نیاز به دانش عمیق ریاضی فراهم میکند.
KODA برای جلوگیری از کندی، از سیستمهای کلی فاصله گرفته و روی ابزارهای تخصصی تمرکز کرده است. طبق مستندات فنی، معماری این سیستم شامل موارد زیر است:
- دفاع در برابر تزریق پرامپت (Prompt Injection): یک سیستم چهارلایه از عبارتهای منظم (regex) که در حدود ۱ میکروثانیه اجرا میشود.
- هوش مصنوعی قانونمدار (Constitutional AI) — شبیه به داشتن یک دفترچه قوانین سختگیرانه که مدل قبل از هر جواب، آن را چک میکند — با محدودیت زمانی ۲۰۰ میلیثانیه برای جلوگیری از مصرف منابع.
- تلهمتری آنی: تشخیص ناهنجاریهای شش-سیگما که ۱۰۰۰ بسته داده را در کمتر از ۵۰ میلیثانیه پردازش میکند.
- مسیریابی ترکیب خبرهها (MoE Routing): انتخاب دو خبره برتر با استفاده از شباهت کسینوسی (Cosine Similarity).
- مدیریت تأخیر: منطق تخصصی برای مدیریت تأخیرهای ۱۳ دقیقهای ارتباطات بین زمین و مریخ.
مدل Claude متعلق به شرکت Anthropic پس از بررسی کامل این معماری، اشاره کرد که ساختار KODA حتی از کارهای برخی مهندسان ارشد نیز تمیزتر است. توسعهدهنده برای کاهش هزینهها از Groq API استفاده کرده است؛ سرویسی که هزینه استنتاج (Inference) — یعنی همان لحظه تولید جواب توسط مدل — را به ۰.۱۰ تا ۰.۵۰ دلار به ازای هر میلیون توکن میرساند. این رقم در مقایسه با بازه ۳ تا ۱۵ دلاری Claude بسیار ارزانتر است و تأخیر را به زیر ۱۰۰ میلیثانیه میبرد. این تمرکز بر کاهش تأخیر، مشابه تلاشات زیرساختی در Preterview برای بهینهسازی استریم است که سرعت پاسخدهی عاملهای صوتی را به شدت افزایش داد.
این تغییر مسیر نشان میدهد که دموکراتیزه شدن هوش مصنوعی از دسترسی به ابر (Cloud) به سمت توسعه بهینهشده در لبه (Edge Computing) حرکت میکند. وقتی سرعت و هزینه بر تطبیقپذیری کلی اولویت یابد، دستیارهای کوچک و متمرکز میتوانند در محیطهای عملیاتی، مدلهای غولپیکر را شکست دهند.
برای یک برنامهنویس معمولی، این یعنی مانع ورود دیگر سختافزارهای گرانقیمت یا بودجههای عظیم محاسباتی نیست، بلکه توانایی پیادهسازی منطقهای ایمنی و مسیریابی بهینه است.
شرکت HYNAWEB قصد دارد در ۶ ماه آینده KODA را گسترش دهد. نقشه راه آنها شامل یک محیط اجرای ایزوله (Sandbox) در مرورگر، افزونه برای VS Code و یک اپلیکیشن دسکتاپ است تا این منتور از محیط گوشی به محیطهای حرفهای کدنویسی منتقل شود.
گام بعدی شما
- بررسی مدلهای کوچکتر و بهینهشده برای اجرا روی سختافزارهای لبه به جای تکیه بر مدلهای ابری گرانقیمت.
- مطالعه در مورد استفاده از Groq API برای کاهش تأخیر در پروژههای استنتاج سریع.
- تمرکز بر پیادهسازی حفاظهای (Guardrails) سبک برای افزایش امنیت مدلها بدون افزایش هزینه محاسباتی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو