تصور کنید یک سیستم هوش مصنوعی در محیط عملیاتی، تنها به دلیل رسیدن یک ارائهدهنده به سقف درخواستها (Rate Limit) یا یک قطعی ساده، بهطور کامل از کار بیفتد. برای حل این آسیبپذیری، تیم Maxim AI ابزار Bifrost را توسعه داد؛ یک درگاه (Gateway) متنباز که در زبان Go نوشته شده و در ترافیک ۵,۰۰۰ درخواست بر ثانیه، تنها ۱۱ میکروثانیه تأخیر به هر درخواست اضافه میکند.
بسیاری از تیمهای مهندسی پیش از این، SDKهای ارائهدهندگان را مستقیماً در کد خدمات خود قرار میدادند. این کار باعث ایجاد یک وابستگی خطرناک میشد؛ بهطوری که هر تغییر ساده در API یا قطعی یک ارائهدهنده، نیازمند بازنویسی کد، طی کردن مراحل CI/CD و استقرار مجدد اضطراری سرویس بود. برای مثال، یک سایت فروشگاهی در روزهای شلوغ سال (مانند Black Friday) را تصور کنید که بهدلیل خطای ۴۲۹ (Rate Limit) از سوی OpenAI، کل بات پشتیبانی مشتریانش از کار میافتد چون هیچ جایگزین خودکاری وجود ندارد.
ابزارهای مسیریابی مدل (Model Routing) مانند یک لایه زیرساختی واسط عمل میکنند. این ابزارها درخواستهای ورودی را بررسی کرده و بر اساس قوانین پیشفرض یا سیگنالهای لحظهای، تصمیم میگیرند کدام مدل، ارائهدهنده یا اعتبارنامه (Credential) باید وظیفه را بر عهده بگیرد. این سازوکار، منطق کسبوکار را از APIهای خاص هر ارائهدهنده جدا میکند و با مدلها بهجای وابستگیهای دائمی، مانند زیرساختهای قابل تعویض برخورد میکند. این ابزارها معمولاً یک نقطه ورود واحد و سازگار با استاندارد OpenAI API فراهم میکنند تا برنامههای بالادستی تنها با یک Endpoint ارتباط برقرار کنند.
چالشهای عملیاتی که با مسیریابی حل میشوند
طبق مستندات فنی، ابزارهای مسیریابی پنج چالش حیاتی در محیطهای عملیاتی هوش مصنوعی را برطرف میکنند:
- در دسترس بودن و تحمل خطا: اگر ارائهدهنده اصلی خطای 5xx یا محدودیت نرخ بدهد، درخواستها بهطور خودکار به جایگزینهای پیکربندیشده (Automatic Fallbacks) منتقل میشوند.
- کنترل هزینهها: پرسوجوهای ساده به مدلهای سبک و ارزان هدایت میشوند و پرامپتهای دشوار به مدلهای پیشرو (Frontier Models) میروند تا هزینه محاسباتی با پیچیدگی وظیفه متناسب شود.
- تجمیع سهمیه (Quota Aggregation): ترافیک از طریق توزیع بار (Load Balancing) بین چندین کلید API و حسابهای مختلف پخش میشود تا محدودیتهای هر کلید دور زده شود.
- کاهش تأخیر: درخواستها به سمت منطقهای یا نمونهای از مدل هدایت میشوند که در آن لحظه کمترین «زمان تا نخستین توکن» (Time to First Token - TTFT) را دارد.
- حذف وابستگی به ارائهدهنده (Lock-in): مهندسان پلتفرم میتوانند مدلها را تعویض کنند، ترافیک را جابهجا کنند یا بر سر قیمتهای حجیم مذاکره کنند، بدون اینکه حتی یک خط از کد برنامه تغییر کند.
همانطور که در تحلیلهای قبلی ما دربارهی زیرساختهای مدلهای زبانی اشاره کردیم، جداسازی لایه استنتاج از لایه منطق، کلید مقیاسپذیری در سازمانهای بزرگ است.
مکانیسمهای مسیریابی مدل
استراتژیهای مسیریابی عموماً در چهار دسته قرار میگیرند:
۱. مسیریابی مبتنی بر قانون و متادیتا: از موتورهای عبارتی مانند CEL گوگل (Common Expression Language) برای ارزیابی ویژگیهایی مثل سطح کاربر، محیطهای برنامه و طول پرامپت استفاده میکند. مثلاً مشتریان سازمانی به مدلهای پیشرو با توان عملیاتی بالا و کاربران رایگان به مدلهای وزنهای باز (Open Weights) هدایت میشوند. چون این عملیات در حافظه و با تطبیق قطعی رشتهها یا اعداد انجام میشود، تأخیری کمتر از ۵۰ میکروثانیه دارد.
۲. زنجیرههای جایگزین و بررسی سلامت: مانند یک تور نجات عمل میکند. وقتی یک فراخوانی بهدلیل Timeout، قطع شبکه یا فراتر رفتن از محدودیت پنجره متنی (Context Length) شکست میخورد، مسیریاب آن را روی یک جایگزین امتحان میکند. سیستمهای مدرن از «سجلات سلامت» (Health Registries) استفاده میکنند؛ اگر یک Endpoint بهطور مداوم خطای 503 (Service Unavailable) بدهد، یک «قطعکننده مدار» (Circuit Breaker) فعال میشود تا ترافیک را بدون اتلاف وقت روی هر درخواست، از مسیر آن ارائهدهنده آسیبدیده عبور دهد.
۳. طبقهبندی پیچیدگی با نگاه به هزینه: از یک مدل امتیازدهی سبک (مانند نسخهای تنظیمشده از BERT یا الگوریتم تجزیه ماتریسی) برای ارزیابی دشواری پرامپت استفاده میکند. بر اساس پژوهشهای چارچوب FrugalGPT از دانشگاه استنفورد، هدایت پرسوجوهای ساده به مدلهای ارزان میتواند تا ۹۸٪ در هزینهها صرفهجویی کند، هرچند تأخیری بین ۱۵ تا ۶۰ میلیثانیه اضافه میکند.
۴. مسیریابی معنایی و قصدی: بردار معنایی (Embedding) ورودی را با خوشههای پیشمحاسبهشده تطبیق میدهد. مثلاً سوالات مربوط به تولید SQL به مدلهای تخصصی کد هدایت میشوند و متون عمومی به مسیرهای دیگر. این روش در ترکیب با کشینگ معنایی، میتواند تأخیر را از صدها میلیثانیه به زیر ۵ میلیثانیه برساند، زیرا پاسخهای برداری کششده را از حافظه بازمیگرداند.
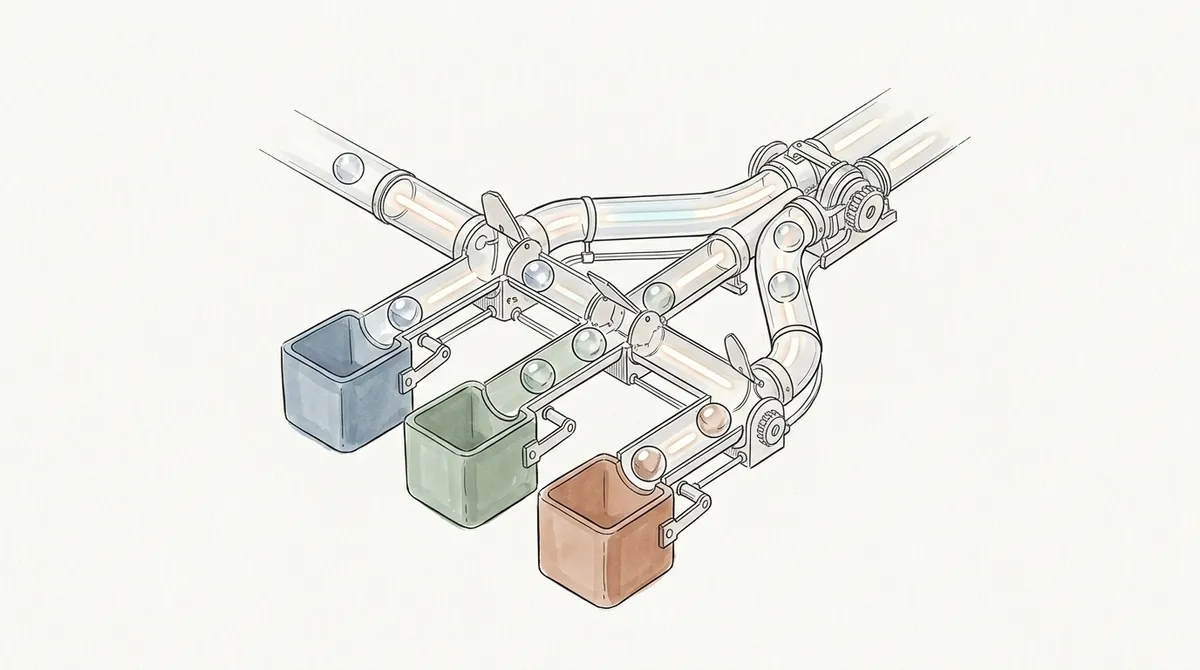
معیارهای ارزیابی ابزارهای مسیریابی
تیمهای پلتفرم هنگام انتخاب ابزار باید چهار ستون معماری را بررسی کنند:
- سربار سیستم و توان عملیاتی: هر گام اضافی تأخیر ایجاد میکند. در حالی که APIهای مدل بین ۳۰۰ تا ۲۰۰۰ میلیثانیه زمان میبرند، مسیریاب باید مینیمال باشد. موتورهای کامپایلشده در Go یا Rust در حد میکروثانیه عمل میکنند، اما پروکسیهای پایتونی (Interpreted) ممکن است ۱۰ تا ۴۰ میلیثانیه تأخیر به هر درخواست در بارهای ترافیکی بالا اضافه کنند. این تفاوت مستقیماً بر ظرفیت سرور، مصرف CPU و هزینههای محاسباتی اثر میگذارد.
- سازگاری پروتکل: مسیریاب باید جایگزینی مستقیم (Drop-in) باشد. این یعنی سازگاری کامل با طرحهای
/v1/chat/completionsو/v1/embeddingsدر OpenAI و همچنین مشخصات Messages در Anthropic. این امر تضمین میکند که تیمهای مهندسی فقط نیاز به بهروزرسانی URL پایه کلاینت و Header احراز هویت داشته باشند. - حاکمیت سازمانی: ابزار باید بتواند از طریق کلیدهای مجازی متمرکز، احراز هویت را اعمال کند. این شامل بودجه توکن در سطح مستاجر (Tenant)، محدودیت نرخ درخواست در دقیقه و لیست مدلهای مجاز برای جلوگیری از جهش ناگهانی هزینههاست. حاکمیت باید شامل مدیریت رمزهای رمزنگاریشده، ورود یکپارچه سازمانی (SSO) و کنترل دسترسی مبتنی بر نقش (RBAC) باشد.
- قابلیت گسترش: جریانهای کاری عاملمحور (Agentic) به پشتیبانی از استانداردهای فراخوانی ابزار (Tool-calling) نیاز دارند. بررسی کنید که آیا ابزار از پروتکل زمینهٔ مدل (MCP) پشتیبانی میکند یا خیر. داشتن یک درگاه MCP اجازه میدهد لایه مسیریابی، ابزارها را بهصورت امن در کنار مسیریابی مدلها شناسایی، فیلتر و اجرا کند.
مقایسه برترین ابزارهای مسیریابی
Bifrost برای مقیاسهای صنعتی طراحی شده است. این ابزار با استفاده از زبان Go، توقفهای مربوط به Garbage Collection و گلوگاههای زمان اجرای پایتون را حذف کرده و جایگزینی برای بیش از ۱,۰۰۰ مدل در OpenAI، Anthropic، AWS Bedrock، Google Vertex AI، Azure OpenAI، Groq، Mistral و موتورهای محلی مثل اولاما (Ollama) و vLLM است. این ابزار یک باینری کامپایلشده برای سرعت بالا را با پشتیبانی بومی از MCP ترکیب میکند و به مدیران اجازه میدهد سقف بودجه کلیدهای مجازی، سیاستهای RBAC و حفاظهای Endpoint را بهصورت متمرکز تنظیم کنند. جریان اجرای آن بسیار سختگیرانه است: اعتبارسنجی کلید مجازی $\rightarrow$ ارزیابی CEL پیش از مسیریابی $\rightarrow$ توزیع بار تطبیقی $\rightarrow$ ارسال به ارائهدهنده اصلی $\rightarrow$ خط لوله پس از درخواست (Prometheus/OpenTelemetry).
Bifrost منطق مسیریابی را از طریق پیکربندیهای اعلامی ارائهدهنده ساختار میدهد. اپراتورها با استفاده از CEL میتوانند نام مدل، تعداد توکنهای ورودی، تگهای متادیتا و هویت کلاینت را بررسی کنند. برای محیطهای حساس (Mission-critical)، این ابزار شامل خوشهبندی با بهروزرسانیهای Rolling بدون توقف، لاگهای حسابرسی تغییرناپذیر برای انطباق با SOC 2 و HIPAA، و ابزار دقیق بومی Prometheus و OpenTelemetry است. همچنین یک «حالت کد» (Code Mode) ارائه میدهد تا اجرای ابزارهای ارکسترهشده با پایتون را با ۵۰٪ توکن کمتر انجام دهد.
LiteLLM یک پروکسی محبوب مبتنی بر پایتون و کتابخانه کلاینت است. این ابزار فراخوانهای API را برای بیش از ۱۰۰ ارائهدهنده با استفاده از پیکربندی YAML به فرمت OpenAI تبدیل میکند. تیمها استقرار مدلها را با لایههای اولویت و توزیع بار وزنی پیکربندی میکنند. LiteLLM از یک مکانیسم Cooldown برای علامتگذاری استقرارهای شکستخورده به عنوان «غیرقابل دسترس» استفاده میکند. با وجود جامعه کاربری بزرگ، محیط اجرای Asynchronous پایتون در بارهای ترافیکی بالا، ۱۰ تا ۳۰ میلیثانیه تأخیر ایجاد میکند که برای برنامههای حساس به سرعت، یک گلوگاه است.
RouteLLM که توسط پژوهشگران UC Berkeley و LMSYS توسعه یافته و در ICLR ۲۰۲۵ مستند شده است، بر موازنه هزینه-کیفیت تمرکز دارد. این ابزار پرامپتها را بر اساس دادههای ترجیحی Chatbot Arena با چهار معماری ارزیابی میکند:
- تجزیه ماتریسی (MF): از بردارهای معنایی برای مدلسازی نرخ برد تاریخی بین خانوادههای مدل استفاده میکند.
- طبقهبند BERT: از یک طبقهبند توالی تنظیمشده برای پیشبینی پیچیدگی وظیفه استفاده میکند.
- مسیریاب Causal LLM: دشواری پرامپت را با استفاده از یک مدل زبانی کوچک ارزیابی میکند.
- تصادفی / خط پایه: به عنوان یک معیار آزمایشی عمل میکند.
این ابزار میتواند هزینهها را تا ۸۵٪ کاهش دهد در حالی که ۹۵٪ از عملکرد مدلهای قدرتمند را حفظ میکند. البته این ابزار بیشتر یک الگوریتم مسیریابی تخصصی است تا یک درگاه کامل و فاقد قابلیتهایی مثل محدودیت نرخ بومی یا لاگهای حسابرسی است.
OpenRouter یک تجربه SaaS مدیریتشده ارائه میدهد. این سرویس صدها مدل را پشت یک API جمع میکند و یک شناسه مسیریابی خودکار (openrouter/auto-beta) دارد که درخواستها را به حدود ۳۰ دسته عملکردی (مثل تحلیل ریاضی یا خلاصهسازی ساختاریافته) تقسیم میکند. این سرویس صورتحساب یکپارچه و جایگزینی بدون درز ارائهدهنده را فراهم میکند، اما ارسال دادهها به یک شخص ثالث، ممکن است با استانداردهای امنیتی محیطهای ایزوله (Air-gapped) یا قوانین سختگیرانه اقامت دادهها سازگار نباشد.
vLLM Semantic Router برای کسانی است که خوشههای GPU خصوصی را مدیریت میکنند. این ابزار که توسط Red Hat، IBM Research و Tencent آغاز شده، از ModernBERT برای تحلیل قصد کاربر و هدایت درخواستها به گرههای خاص در استقرار Mixture-of-Models (MoM) استفاده میکند. این سیستم پشتیبانی میکند از:
- مسیریابی تفکیکشده Prefill و Decode در میان مجموعههای GPU تخصصی.
- مسیریابی آگاه از LoRA برای گرههایی که آداپتورهای مدل کششده را نگه میدارند.
- یکپارچگی با Kubernetes و پروکسی Envoy برای استقرارهای Cloud-native.
این ابزار بهطور خاص برای وزنهای باز میزبانیشده ساخته شده تا وظایف ساده، منابع مدلهای استدلالی پرمصرف را اشغال نکنند.
حاکمیت سازمانی و لبه (Edge)
مسیریابی فقط مربوط به بکاند نیست. سازمانها اغلب با «هوش مصنوعی سایه» (Shadow AI) دستوپنجه نرم میکنند؛ جایی که کارکنان از ابزارهای بدون نظارت روی سیستمهای خود استفاده میکنند. Bifrost Edge سیاستهای درگاه را از طریق پلتفرمهای MDM مانند Jamf، Microsoft Intune، Kandji یا Workspace ONE به نقاط انتهایی گسترش میدهد.
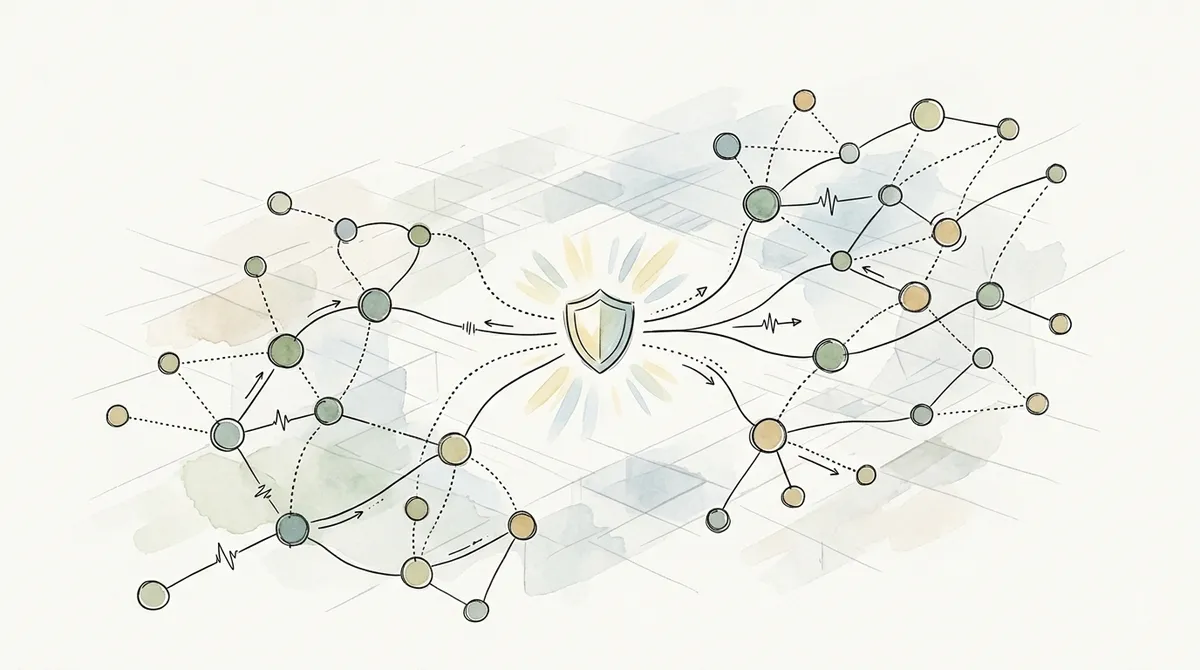
این معماری یکپارچه اجازه میدهد تا اطلاعات حساس (PII) و رمزها (با استفاده از شناسایی رمزهای Gitleaks) قبل از خروج پرامپت از شبکه داخلی، شناسایی و حذف شوند. همچنین تضمین میکند که لپتاپ یک توسعهدهنده و یک میکروسرویس ابری، از بودجه کلید مجازی یکسانی استفاده کنند تا از جهش ناگهانی هزینهها جلوگیری شود. Bifrost Edge ابزارهای AI فعال و سرورهای MCP را در کل شبکه شناسایی کرده و به مدیران امنیت اجازه میدهد آنها را بهصورت متمرکز تأیید یا مسدود کنند. این کار نقاط کور را از طریق اتصال ترافیک AI ورکاستیشنها به سیاستهای درگاه مرکزی از طریق SSO حذف میکند.
الگوهای پیادهسازی
پیادهسازی این ابزارها نیازمند پیکربندیهای اعلامی (Declarative) است. در Bifrost، یک تیم میتواند زنجیرهای به نام hybrid-claude-chain ایجاد کند که ۷۰٪ ترافیک را به Anthropic (claude-3-5-sonnet-20241022) و ۳۰٪ را به Azure OpenAI (gpt-4o) بفرستد و در صورت شکست هر دو، آخرین جایگزین را AWS Bedrock (anthropic.claude-3-5-sonnet-20241022-v2:0) قرار دهد.
در این حالت، برنامه فراخوان بدون اینکه بداند ارائهدهندهای شکست خورده، پاسخی استاندارد دریافت میکند. مسیریاب بهطور لحظهای Timeout را مدیریت کرده (مثلاً ۴۰۰۰ میلیثانیه برای اصلی و ۶۰۰۰ میلیثانیه برای جایگزین) و جابهجایی را انجام میدهد. همچنین قبل از هر تصمیم، بودجه کلید مجازی و محدودیت نرخ (مثلاً ۱,۰۰۰ درخواست در دقیقه) را تأیید میکند.
پرسشهای متداول
تفاوت درگاه AI و مسیریاب مدل چیست؟
مسیریاب بر انتخاب مدل یا ارائهدهنده هدف بر اساس هزینه، سرعت یا قوانین تمرکز دارد. درگاه (Gateway) زیرساخت گستردهتری شامل ترجمه پروتکل، کلیدهای مجازی، محدودیت نرخ، کشینگ معنایی و حفاظهای امنیتی را فراهم میکند. ابزاری مثل Bifrost هر دو را ترکیب کرده است.
ابزارهای مسیریابی چگونه پاسخهای استریم (Streaming) را مدیریت میکنند؟
آنها اتصالات HTTP Server-Sent Events (SSE) را بهصورت شفاف حفظ میکنند. مسیریاب درخواست را تأیید کرده، اتصال را با ارائهدهنده برقرار میکند و تکههای پاسخ را به مشتری میفرستد و همزمان متریکهای توکن را بهصورت ناهمگام جمعآوری میکند.
آیا مسیریابی میتواند هزینههای LLM را کاهش دهد؟
بله، بین ۴۰٪ تا ۸۵٪. این کار با هدایت پرسوجوهای روتین به مدلهای کوچک و استفاده از کشینگ معنایی برای حذف درخواستهای تکراری محقق میشود.
اگر تمام ارائهدهندگان در یک زنجیره جایگزین شکست بخورند چه میشود؟
ابزار زنجیره را متوقف کرده و یک کد خطای ساختاریافته (معمولاً HTTP 502 Bad Gateway یا 504 Gateway Timeout) را به همراه جزئیات تلاشهای صورتگرفته برمیگرداند.
آیا این ابزارها در VPCهای ایزوله قابل اجرا هستند؟
بله، ابزارهای میزبانی شخصی مثل Bifrost و LiteLLM را میتوان در محیطهای ابری خصوصی یا شبکههای Air-gapped مستقر کرد تا دادهها و اعتبارنامهها هرگز از محیط امن خارج نشوند.
تحلیل تحریریه
برای یک مهندس عملگرا، تغییر به سمت مسیریابی مدل نشاندهنده «صنعتی شدن» پشته AI است. ما در حال حرکت از فاز «مهندسی پرامپت» به فاز «مهندسی زیرساخت» هستیم. توانایی تعویض مدلها بدون تغییر حتی یک خط از کد برنامه، تنها راه اجتناب از بدهی فنی عظیم در دنیایی است که چشمانداز مدلها هر چند ماه یکبار تغییر میکند.
تمرکز Bifrost بر سربار زیر میلیثانیه حیاتی است. در جریانهای کاری عاملمحور با فرکانس بالا، جایی که یک درخواست کاربر ممکن است ۱۰ فراخوانی داخلی LLM را تحریک کند، تأخیر ۳۰ میلیثانیهای یک پروکسی به جریمه ۳۰۰ میلیثانیهای تبدیل میشود. درگاههای کامپایلشده دیگر یک کالای لوکس نیستند؛ آنها برای محصولات AI با تأخیر کم، یک ضرورت هستند.
در آینده، تکامل پروتکل زمینه مدل (MCP) را دنبال کنید. همانطور که لایههای مسیریابی شروع به مدیریت نه تنها مدلها، بلکه ابزارهایی میکنند که مدلها از آنها استفاده میکنند — مانند حالت Code Mode در Bifrost که اجرای ابزارهای ارکسترهشده با پایتون را با ۵۰٪ توکن کمتر انجام میدهد — درگاه تبدیل به مرز امنیتی اصلی برای تمام اقدامات مبتنی بر AI در سازمانها خواهد شد.
گام بعدی شما:
- اگر از چندین ارائهدهنده API استفاده میکنید، لایه مسیریابی را برای حذف وابستگی مستقیم به SDKها پیاده کنید.
- برای کاهش هزینهها، یک مدل امتیازدهی سبک برای تفکیک پرسوجوهای «ساده» از «پیچیده» تعریف کنید.
- استانداردهای MCP را بررسی کنید تا بتوانید ابزارهای خارجی را بهصورت متمرکز و امن به مدلهای خود متصل کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو