تصور کنید یک برنامهنویس ارشد در تیم شما تبدیل به یک «سرویس جستوجوی انسانی» شده است که هر لحظه با سوالات تکراری همکاران، تمرکزش را برای حل مسائل پیچیده از دست میدهد. در بسیاری از تیمها، تکیه بر یک متخصص واحد برای توضیح رفتار محصول، باعث میشود تمرکز عمیق او فدای شفافیت موقت دیگران شود. برای شکستن این چرخه، Braid در ۲۱ سپتامبر ۲۰۲۶ رویکردی جدید در مدلسازی دامنه معرفی کرد که حل اختلافات فنی را از پنجرههای چت به یک مدل بازبینیشده منتقل میکند.
اکثر تیمهای مهندسی امروز میان سه گزینه ناقص در نوسان هستند. آنها یا از یک همکار میپرسند، یا در مستندات مکتوب و قدیمی جستوجو میکنند، یا اجازه میدهند یک هوش مصنوعی کد منبع (Source Code) را بخواند. در حالی که امروزه هوش مصنوعی به گزینه پیشفرض تبدیل شده است، اما اغلب یک شکست بحرانی را پنهان میکند: وقتی کد (که حقیقت فیزیکی است) با اسناد نیازمندیهای محصول یا PRDها (که قصد تجاری هستند) تضاد دارد، هوش مصنوعی بیصدا یکی از این دو طرف را انتخاب میکند. خواننده هرگز متوجه نمیشود که تضادی وجود داشته است و مفیدترین تکه اطلاعات — یعنی خودِ آن اختلاف نظر — در پاسخ نهایی پاک میشود.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، شفافیت در منبع داده کلید اعتماد است. در Braid، این موضوع با ارائه چهارمین گزینه حل شده است: پرسوجو از مدلی که صراحتاً توسط انسان بازبینی و تأیید شده است. این رویکرد در واقع تکاملیافتهی مفاهیم اتصال به دادههای سازمانی است که پیشتر در بررسی راهکارهای RAG برای حذف توهمات AI به آن پرداختیم. در این سامانه، اگر کد و هدف تجاری با هم در تضاد باشند، یک انسان تصمیم میگیرد که مدل چه چیزی را گزارش کند. این تصمیم به همراه شواهد مورد استفاده و نام شخصی که تصمیم را گرفته است، روی گره (Node) ثبت میشود. این انتخاب یک بار، در فضای باز و پیش از آنکه کسی سوالی بپرسد، انجام میشود.
هزینهی گزینههای فعلی
- همکار: پاسخها دقیق هستند، اما به قیمت از دست رفتن تمرکز فردی تمام میشوند که احتمالاً در حال ساخت همان بخشی است که پاسخ به آن نیاز دارد. با گذشت زمان، این فرد به یک سرویس جستوجوی انسانی تبدیل میشود.
- مستندات مکتوب: بلافاصله در دسترس هستند، اما هیچ نشانهای ندارند که کدام بخشها پس از تغییرات کد هنوز معتبرند. اکثر خوانندگان در نهایت کد را چک میکنند و سند تبدیل به یک مسیر اضافی و وقتگیر میشود.
- هوش مصنوعی روی کد: پاسخها فوری و روان هستند. با این حال، هوش مصنوعی تضادها را از طرف شما و بدون اطلاع شما حل میکند. پاسخی که از فایلهای منبع جمعآوری شده، صرفاً گزارشی از آن فایلهاست؛ این موضوع به مهندس کمک میکند اما وضعیت مدیر محصول را هیچ تغییری نمیدهد.
کشف مبتنی بر معنا
جستوجوی سنتی در مستندات وقتی شکست میخورد که خواننده نتواند دقیقاً واژگان نویسنده را حدس بزند. Braid این مشکل را با رتبهبندی نتایج بر اساس معنا به جای کلمات کلیدی حل میکند. این متدولوژی شباهت زیادی به رویکردهای بازیابی ترکیبی دارد که برای پر کردن شکاف دقت در سیستمهای RAG توسعه یافتهاند. به عنوان مثال، یک پرسوجو درباره اینکه «چگونه یک پیام چت به یک پاسخ تبدیل میشود» میتواند گرههایی مانند «Run Turn» یا «Conversation Turn Lifecycle» را برگرداند، حتی اگر این کلمات خاص در سوال نباشند. مفهوم بر اساس آنچه «هست» پیدا میشود، نه بر اساس آنچه کسی «نام» آن را گذاشته است.
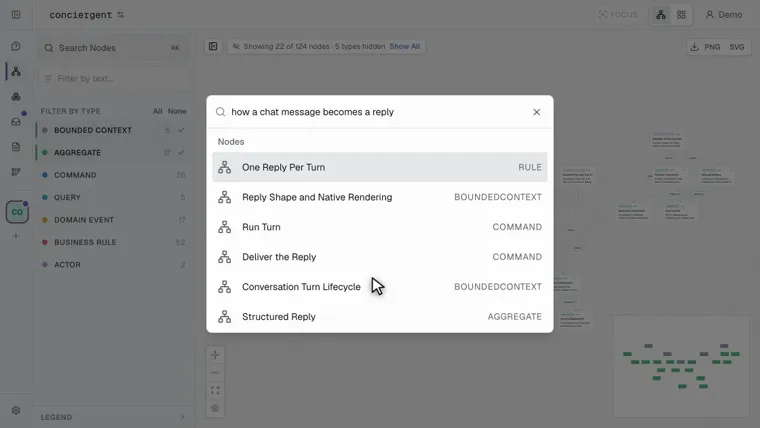
برای مهندسان، این گراف از طریق یک نقطه اتصال پروتکل زمینهٔ مدل (MCP) در حالت خواندنی ارائه میشود. این قابلیت به توسعهدهندگان اجازه میدهد تا با استفاده از توکنها و کلاینتهای خود با مدل تعامل داشته باشند و دانش دامنه را مستقیماً در جریان کاری فعلیشان ادغام کنند.
پاسخهای قابل راستیآزمایی و حسابرسی
برخلاف متون تولیدشده توسط LLMهای استاندارد که هیچ شفافیتی درباره منطق خود ندارند، قابلیت Ask در Braid یک ردپای کامل از حسابرسی (Audit Trail) ارائه میدهد. هر ادعایی در یک پاسخ به گره خاصی در مدل متصل است که پیش از پرسش، توسط یک انسان تأیید شده است.
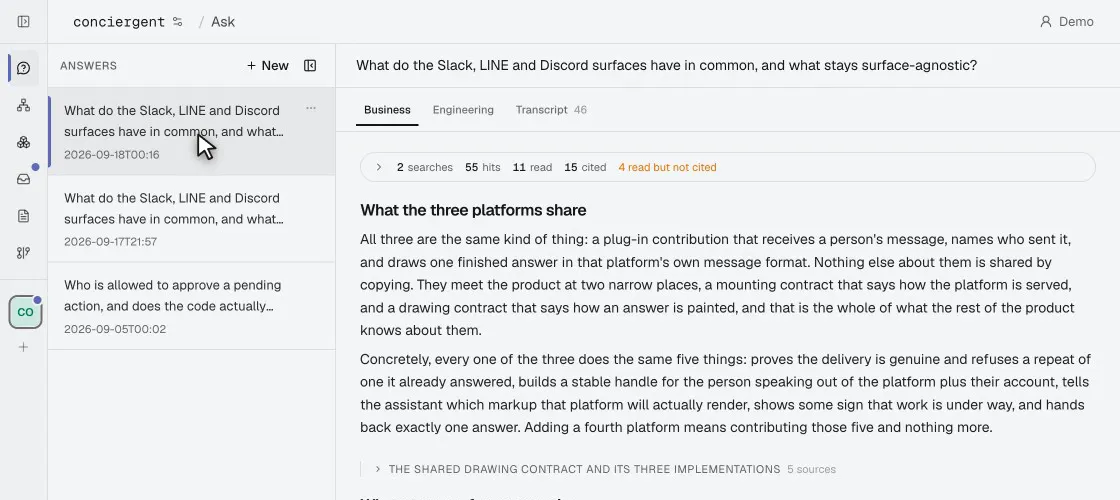
همچنین هر اجرا، حسابرسی دقیقی از عملیات خود گزارش میدهد. سیستم دقیقاً فاش میکند که چه جستوجوهایی انجام داده است، چه مقدار از مجموعه نتایج را خوانده و در نهایت به کدام بخشها استناد کرده است. این رویکرد، هوش مصنوعی را از یک جعبه سیاه به یک ابزار پژوهشی قابل ردیابی تبدیل میکند و سطحی از پاسخگویی را فراهم میکند که متون ساده قادر به ارائه آن نیستند.
مستندات پویا
Braid مستندات را نه به عنوان یک کپی ایستا، بلکه به عنوان تصویری (Projection) از مدل میبیند. چون اسناد توابعی از مدل هستند، دقیقاً میدانند چه زمانی مدل زیربنایی تغییر کرده است.
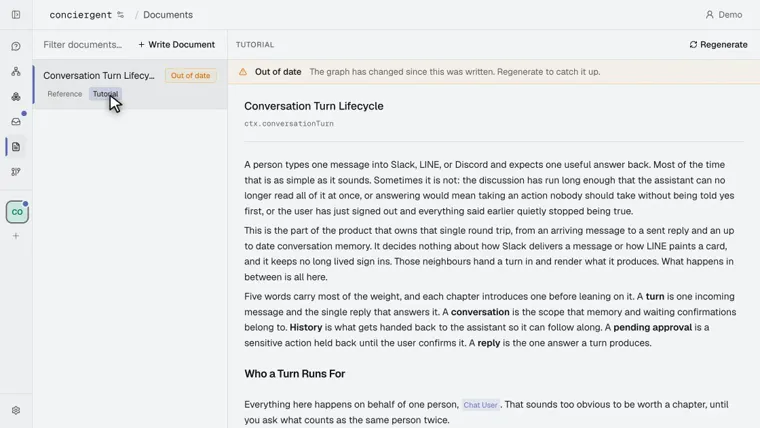
- راهنمای مرجع: این راهنماها یک برشی زنده از مدل را در داخل خود دارند تا کاربر بتواند موارد را جستوجو کند.
- آموزشها: این بخشها هر فصل را با سوالی به پایان میرسانند که خواننده باید به آن پاسخ دهد و سپس علامتگذاری شود.
اگر یک پیشنهاد جدید مدل دامنه را تغییر دهد، تمام آموزشها یا راهنماهای مرتبط بهطور خودکار «تاریخگذشته» (Out of date) علامت میخورند. در این حالت، لزوماً هیچکدام غلط نیستند، اما هیچکدام ادعای درست بودن مطلق را ندارند. این صداقت مانع از «تله نوشن» (Notion trap) میشود؛ جایی که کاربر به صفحهای اعتماد میکند که ماههاست بهروز نشده است بدون اینکه بداند.
رندرینگ ساختاری
بسیاری از دستیارهای هوش مصنوعی تمام دانش را به پاراگرافهای Markdown تبدیل میکنند و خواننده را مجبور میکنند ساختار را در ذهن خود بازسازی کند. Braid در عوض، محتوا را در قالبی رندر میکند که با نوع اطلاعات سازگار باشد. یک اجرای Braid به جای نوشتن یک صفحه، محتوا را رندر میکند و هر قطعه رندرشده، نوع خود را اعلام میکند.
انواع رندرینگ موجود عبارتند از:
- مقایسهها: در قالب ماتریسها یا جدولها رندر میشوند.
- توالیها: در قالب نمودارها نمایش داده میشوند.
- ادعاها: در کنار منابعی که بر آنها استوارند نمایش داده میشوند.
- یافتهها: بینشهای استخراجشدهی خاص.
- گزارش اجرا: یک گزارش مفصل از آنچه سیستم در طول اجرا جستوجو کرده است.
این روش تضمین میکند که یک مدیر محصول و یک مهندس میتوانند به یک داده واحد نگاه کنند، اما آن را در قالبی دریافت کنند که با نیازهای خاص آنها سازگار است. چون یک قطعه رندرشده میگوید «چیست» و نه اینکه «کجاست»، یک توالی میتواند در یک سطح به صورت یک پاسخ اسکرولی و در سطحی دیگر به صورت یک صفحه باشد، در حالی که هر دو توسط اجزای یکسانی ترسیم شدهاند.
موازنه با هوش مصنوعی خام
Braid جایگزین ابزارهایی مثل DeepWiki یا اجرای llm-wiki کارپاتی به عنوان یک مهارت نیست. در واقع، برای یک مخزن کد ناشناخته که هدف صرفاً پیدا کردن مسیر است، ابزارهای هوش مصنوعی خام برتر هستند. ارزش Braid زمانی ظاهر میشود که پاسخ باید مبنای تصمیمات تولیدی (Production) باشد.
مقایسه چهار گزینه تفاوت اصلی را روشن میکند:
- Braid: تضادهای منبع را بهصورت رسمی ثبت میکند؛ گرهها توسط انسان تأیید شدهاند؛ هر ادعا ردیابی میشود و زمان تاریخگذشته شدن را اعلام میکند.
- AI روی کد: تضادها را بیصدا حل میکند؛ تأیید انسانی ندارد؛ تا حدی از طریق لینک به فایلها ردیابی میشود و کورکورانه بازتولید میکند.
- مستندات تیمی: تضادها را یک بار در گذشته دور حل کرده است؛ تأیید گرهبهگره ندارد؛ بهندرت ردیابی میشود و هشدار تاریخگذشتگی نمیدهد.
- پرسش از مهندس: تضادها را بدون ثبت حل میکند؛ توسط انسان تأیید شده اما ردیابی نمیشود و تمرکز متخصص را میگیرد.
با انتقال حل شکاف «کد در مقابل قصد» به مرحلهای زودتر از چرخه حیات، Braid تضمین میکند که استدلال پشت یک تصمیم به گره متصل بماند. این کار مانع از آن میشود که سوالات یکسانی مکرراً از یک مهندس ارشد پرسیده شود.
محدودیتهای فعلی
در حالی که بخش خواندن باعث سودآوری پروژه میشود، برخی قابلیتها هنوز در حال تکامل هستند:
- رتبهبندی معنایی اختیاری است: این قابلیت به یک نقطه اتصال Embedding نیاز دارد. در نبود آن، سیستم بیصدا به تطبیق متنی ساده بازمیگردد و سوالاتی که با کلمات شخصی کاربر پرسیده شوند، ممکن است هیچ نتیجهای پیدا نکنند.
- تکمهارتی بودن Ask: در حال حاضر، قابلیت Ask تنها به یک مهارت پاسخگویی داخلی دسترسی دارد. اگرچه محیطهای کاری میتوانند مراحل ساخت (Build steps) را اضافه کنند، اما هنوز نوع دومی از Ask ارائه نشده است.
- بهروزرسانی دستی: یک سند میتواند سیگنال دهد که تاریخگذشته شده است، اما خودش را اصلاح نمیکند. بهروز کردن یک سند با مدل، نیازمند این است که یک انسان دکمهای را فشار دهد.
این تغییر رویکرد، صنعت را از «بازتولید کورکورانه» پاسخها به سمت یک «سامانه ثبت» (System of Record) میبرد. این سیستم مدل دامنه را به جای محصول جانبی کد، به عنوان یک قرارداد زنده تعریف میکند که تیم بر سر آن توافق دارد. برای تیمهایی که با سوالات تکراری و ویکیهای قدیمی دستوپنجه نرم میکنند، مخزن پروژه در github.com/mroops0111/braid در دسترس است.
گام بعدی شما
- اگر تیم شما با مستندات قدیمی و سوالات تکراری دستوپنجه نرم میکند، مخزن Braid را در github.com/mroops0111/braid بررسی کنید.
- بررسی کنید آیا در جریان کاری شما، تضادهای بین کد و اسناد محصول باعث خطاهای تولیدی شده است یا خیر.
- مدلهای تأییدشده انسانی را به عنوان لایهای برای کاهش توهمات در پروژههای حساس به کار بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو