اگر امروز در حال آموزش یک عامل هوشمند برای محیطهای سازمانی هستید، احتمالاً متوجه شدهاید که مدل شما بین «انجام درست کار» و «رعایت قوانین ایمنی» یکی را فدا میکند. این تضاد، نتیجهی یک نقص ریاضی در سیستمهای پاداش است که تا پیش از این نادیده گرفته میشد.
طبق گزارش فنی منتشر شده در ۲۵ سپتامبر ۲۰۲۶، مدل ۲۷ میلیارد پارامتری با استفاده از GDPO (بهینهسازی سیاست تفکیکشده گروهی) توانست نرخ تخلف از محدودیتها را از ۲۹.۴٪ به زیر ۳.۸٪ کاهش دهد. این نتیجه ثابت میکند که در آموزش عاملهای خودمختار، «نحوه نرمالسازی پاداشها» بسیار حیاتیتر از «وزن دادن به پاداشها» است.
آموزش یک عامل برای کارهای سازمانی، برخلاف حل پازلهای ریاضی ساده، تکبعدی نیست. اگر شما مدلهای زبانی را فقط روی پازلهای ریاضی ساده آموزش دهید، یادگیری تقویتی (RL) بسیار ساده به نظر میرسد: آیا مدل عدد ۴۲ را خروجی داد؟ اگر بله، پاداش ۱ است؛ اگر نه، پاداش ۰ است. اما لحظهای که سعی میکنید یک عامل خودمختار را برای کارهای واقعی سازمانی آموزش دهید، یک پاداش اسکالر واحد تبدیل به یک توهم مطلق میشود. در همین راستا، پژوهشهای اخیر NGU نشان داد که بازتوزیع بهینه منابع محاسباتی میتواند دقت مدلها را در حل مسائل ریاضی پیچیده ارتقا دهد.
در دنیای واقعی، یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — باید چندین اولویت متضاد را مدیریت کند. اکثر عاملهای عملیاتی باید یک «مأموریت اصلی» — مانند اجرای درست یک کوئری SQL، کامپایل کردن یک مدار یا بازگرداندن یک بسته داده صحیح — را در مقابل کارایی اجرا و حفاظهای سخت ایمنی متوازن کنند. همانطور که در تحلیل قبلی ما دربارهی Protealpes و ممنوعیت محاسبات LLM برای تضمین دقت اشاره کردیم، صنعت اکنون به سمت یادگیری تقویتی (RL) پیچیدهتری حرکت میکند تا توازن بین مأموریت اصلی و حفاظهای ایمنی برقرار شود.
نبرد پاداشهای متضاد
یک عامل در محیط عملیاتی باید سه اولویت غیرهمسنگ را همزمان مدیریت کند:
- مأموریت اصلی (R₁): آیا درخواست مشتری واقعاً حل شد؟
- کارایی اجرا (R₂): آیا کار با ۳ فراخوانی ابزار به صورت بهینه انجام شد، یا یک حلقه ۴۰ مرحلهای وحشی ایجاد شد که ۴ دلار هزینه توکن API مصرف کرد و باعث جهش CPU پایگاهداده شد؟
- حفاظها و محدودیتهای سخت (R₃): آیا مدل در محیط ایزوله (Sandbox) ماند، ساختارهای JSON را رعایت کرد، از تغییر جداول تولید (Production) پرهیز کرد و ناپایدارکنندههای امنیتی را حفظ نمود؟
راز تلخ آموزشهای پسزمینه (Post-training) این است که اگر این سه امتیاز را صرفاً با هم جمع کنید و در الگوریتمهای استاندارد مثل PPO یا GRPO معمولی قرار دهید، فرآیند آموزش تقریباً به طور قطع از هم میپاشد. کانال پاداشی که صدای بلندتری دارد (مقادیر بزرگتر)، سیگنالهای ظریفتر را میبلعد، عامل یاد میگیرد که سیستم را دور بزند (Game the system) و تا یکسوم از دستههای (Batches) گرانقیمت GPU در نهایت هیچ گرادیانی تولید نمیکنند.
در گزارش فنی ۲۵ سپتامبر ۲۰۲۶، پژوهشگران با جزئیات توضیح دادند که چرا الگوریتمهای استاندارد RL اغلب در این محیطهای پیچیده شکست میخورند. مشکل اصلی «سلطه مقیاس» (Scale Dominance) است؛ جایی که یک پاداش با واریانس بالا (مانند موفقیت در وظیفه)، معیارهای ظریفتر (مانند هزینه توکن) را از نظر ریاضی پاک میکند.
تکامل آموزشدهندههای عامل
برای درک این تحول، باید به تکامل تخمینگرهای گرادیان سیاست نگاه کنیم. این فرآیند شامل چهار رکن است: سیاست (شبکه عصبی که توکن بعدی را انتخاب میکند)، رولاوت (یک تلاش کامل کاندید برای پاسخ)، کانال پاداش (یک امتیاز مستقل از یک ارزیاب خاص) و مزیت (یک عدد اسکالر نرمالشده که نشان میدهد یک تلاش در مقایسه با خط پایه خود چقدر بهتر بوده است).
سالها بود که PPO (بهینهسازی سیاست تقریبی، شولمن و همکاران، ۲۰۱۷) ابزار اصلی صنعت بود. PPO از معماری Actor-Critic استفاده میکند که در آن Actor توکنها را تولید میکند و یک شبکه Critic مجزا یاد میگیرد پاداش آینده مورد انتظار از وضعیت s را با استفاده از تخمین مزیت تعمیمیافته (GAE) پیشبینی کند.
نقاط ضعف PPO در عمل:
- مالیات دوبرابری VRAM: اگر مدل سیاست شما ۲۷ میلیارد پارامتر دارد، Critic شما هم معمولاً یک مدل ۲۷ میلیارد پارامتری است. شما باید دو مدل عظیم را به همراه حالتهای بهینهساز (Optimizer states) و فعالسازها در حافظه GPU نگه دارید، که این یعنی نیاز به دو برابر H100.
- انحراف Critic: آموزش یک سرِ Critic برای پیشبینی ترکیبی از دقت وظیفه، جریمههای تأخیر و رعایت فرمت، بهشدت ناپایدار است. این امر منجر به مزیتهای نویزی و بهروزرسانیهای کند سیاست میشود.
سپس GRPO (بهینهسازی سیاست نسبی گروهی) توسط DeepSeekMath در سال ۲۰۲۴ معرفی شد و Critic را به طور کامل حذف کرد. به جای یک خط پایه شبکه عصبی، GRPO گروهی از G پاسخ کاندید را برای یک پرامپت نمونهبرداری کرده، آنها را امتیازدهی میکند و مزیتها را نسبت به میانگین و انحراف معیار همان گروه نرمال میکند.
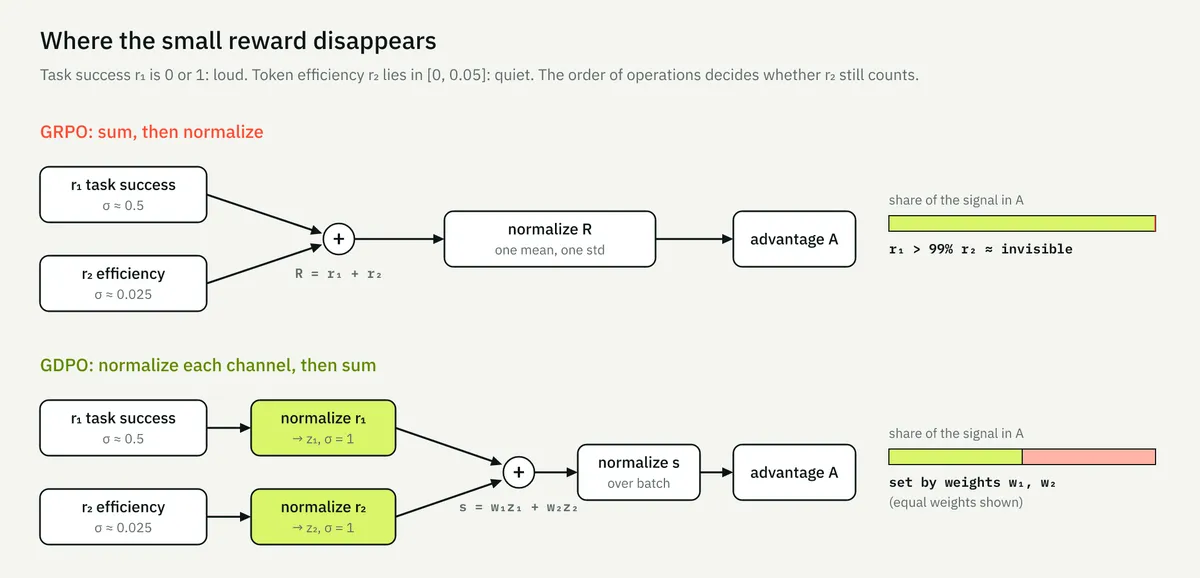
با اینکه نیاز به حافظه نصف شد، اما یک نقص مهلک ظاهر شد: «جمع سپس نرمالسازی». در GRPO معمولی، سیستم تمام امتیازات پاداش را با هم جمع میکند و سپس نرمالسازی را انجام میدهد. اگر موفقیت در وظیفه باینری (۰ یا ۱) باشد و کارایی یک عدد اعشاری کوچک (۰ تا ۰.۰۵) باشد، پاداش موفقیت ۹۹.۷٪ واریانس را به خود اختصاص میدهد. مدل عملاً جریمه کارایی را نادیده میگیرد زیرا از نظر ریاضی برای گرادیانها نامرئی است. این چالش در مدلهای کوچکتر نیز دیده شده است؛ برای مثال، بهبود پیروی از طرحهای JSON در مدل LFM2.5 نشان داد که چگونه بهینهسازی GRPO میتواند دقت خروجیهای ساختاریافته را به شدت افزایش دهد.
حل مشکل «گروههای مرده»
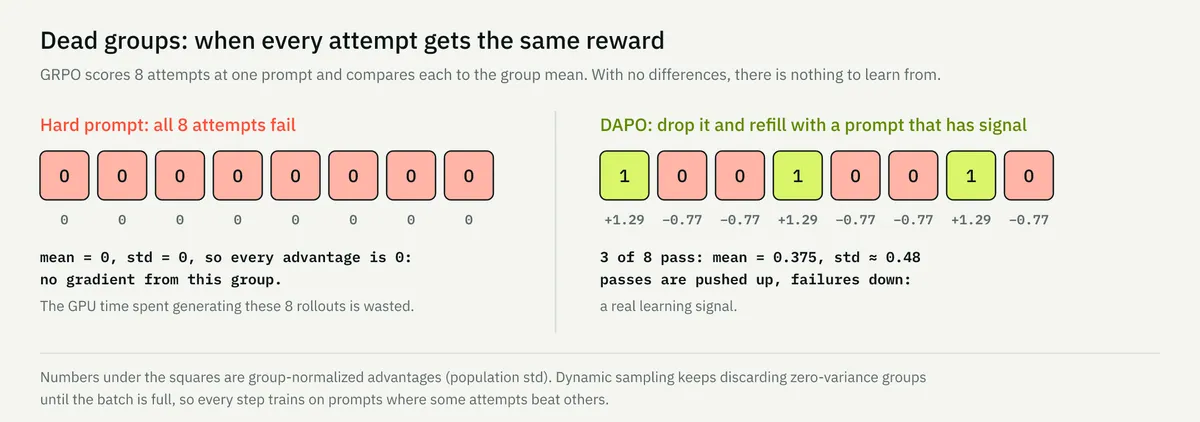
در کارهای مهندسی سخت، پدیدهای به نام «گروههای مرده» (Dead Groups) رخ میدهد. این اتفاق زمانی میافتد که یک تسک کدنویسی چنان دشوار باشد که تمام رولاوتهای کاندید در یک گروه (مثلاً ۸ تلاش) با خطای سینتکس شکست بخورند. وقتی تمام پاداشها ۰ باشند، انحراف معیار گروه ۰ میشود و در نتیجه مزیت در کل گروه ۰ میگردد.
در تسکهای دشوار، ۳۰ تا ۴۰ درصد از تمام گامهای آموزشی میتوانند گروههای مرده باشند. یعنی خوشه GPU گرانقیمت شما ۳۰ ثانیه زمان صرف تولید توکن میکند، اما بهروزرسانی گرادیان کاملاً خالی است.
DAPO (نمونهبرداری پویا) این مشکل را با پیادهسازی «جایگزینی پویا پرامپتها» حل میکند. در طول امتیازدهی رولاوت، اگر یک گروه واریانس صفر داشته باشد، DAPO بلافاصله دادههای مرده را دور ریخته و پرامپتهای فعال جدیدی میگیرد تا هر دسته آموزشی حاوی یک سیگنال یادگیری واقعی باشد و اتلاف چرخههای GPU به نزدیک صفر برسد.
پیشرفت GDPO
روش GDPO که در سال ۲۰۲۶ معرفی (arXiv:2601.05242) و در TRL 1.7 ادغام شد، منطق «جمع سپس نرمالسازی» را با «نرمالسازی سپس جمع» جایگزین کرد. این روش هر کانال پاداش را ابتدا بهطور مستقل در سطح گروه استاندارد میکند و سپس آنها را در یک امتیاز نهایی ترکیب میکند.
این کار تضمین میکند که کانال پاداشی که به طور طبیعی بین [۰ و ۰.۰۵] تغییر میکند، همان وزن ریاضی کانالی را داشته باشد که بین [۰ و ۱.۰] تغییر میکند. هر دو کانال به میانگین ۰ و واریانس ۱ میرسند، به این معنی که معیار کوچک دیگر نمیتواند توسط معیار بزرگ سرکوب شود.
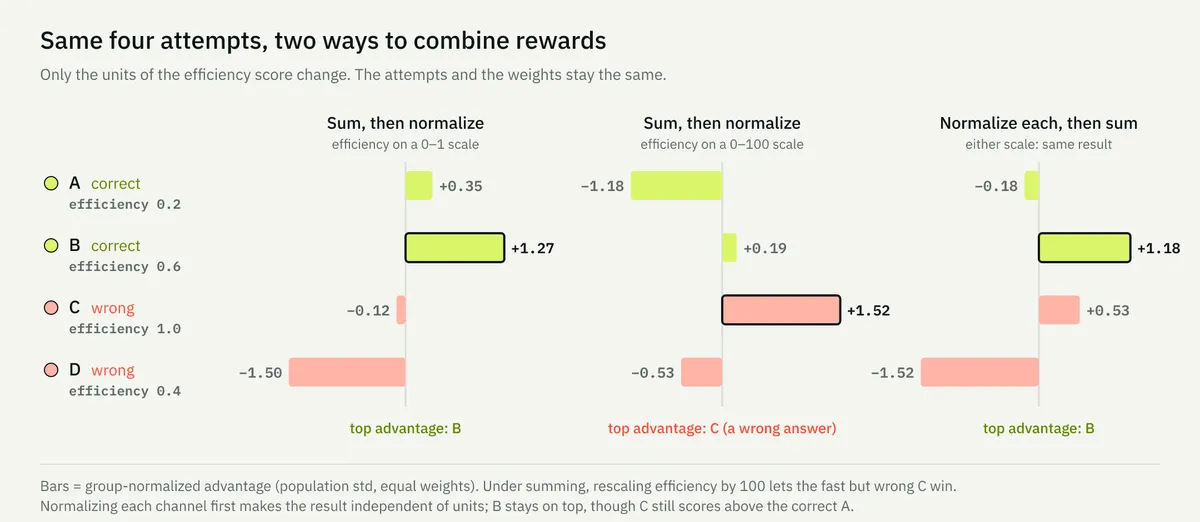
این تفکیک از «فروپاشی هندسی پاداش» جلوگیری میکند. در GRPO معمولی، کاندیدایی که کاملاً درست است اما تمام قوانین فرمت را میشکند (مجموع = ۱.۰)، دقیقاً مشابه کاندیدایی دیده میشود که تا حد زیادی درست و کاملاً ایمن است (مجموع = ۱.۰). در این حالت، سیاست هیچ گرادیانی دریافت نمیکند تا راه حل compliant (مطابق با قوانین) را به راه حل شکسته ترجیح دهد. نرمالسازی تفکیکشده در GDPO اجازه میدهد تا برتری در کانال محدودیتها به عنوان یک «زیر-مزیت» مثبت قوی ظاهر شود و مدل را به سمت مرز پارتو (Pareto Frontier) واقعی هدایت کند.
بنچمارک نتایج
آزمایش روی مدل ۲۷ میلیارد پارامتری در محیط gft-studio تفاوت فاحشی را در عملکرد چهار روش نشان داد. این تستها موفقیت در وظیفه (R₁)، کارایی توکن (R₂) و رعایت محدودیتها (R₃) را ارزیابی کردند:
- PPO (خط پایه Actor-Critic): صحت وظیفه ۴۲.۵٪؛ تخلف از محدودیتها ۲۴.۸٪. از یک Critic ۲۷ میلیارد پارامتری و GAE استفاده میکند.
- GRPO (جمع مشترک معمولی): صحت وظیفه ۵۱.۲٪؛ تخلف از محدودیتها ۲۹.۴٪؛ نرخ گروه مرده ۳۴.۲٪. بدون Critic.
- DAPO (پر کردن پویا + GRPO): صحت وظیفه ۵۶.۸٪؛ تخلف از محدودیتها ۲۲.۱٪؛ نرخ گروه مرده زیر ۳٪. بدون Critic.
- GDPO (نرمالسازی تفکیکشده + ایمنی): صحت وظیفه ۶۳.۴٪؛ تخلف از محدودیتها زیر ۳.۸٪؛ نرخ گروه مرده زیر ۳٪. بدون Critic.
نتایج کلیدی:
- GRPO ایمنی را فدا میکند: چون پاداش وظیفه بر مجموع مسلط بود، عامل به طور معمول قراردادهای فرمت و ایمنی را میشکست تا کار را به پایان برساند.
- DAPO محاسبات را نجات میدهد: با جایگزینی گروههای بدون واریانس، DAPO تقریباً ۳۴٪ از محاسبات تلف شده را نسبت به GRPO معمولی کاهش داد.
- GDPO نقطه بهینه را مییابد: تخلفات از ۲۹.۴٪ به زیر ۳.۸٪ سقوط کرد و همزمان صحت کلی به ۶۳.۴٪ جهش کرد.
راهنمای پیادهسازی برای متخصصان
برای کسانی که عاملهای سازمانی میسازند، این گزارش چند قانون سخت را برای خط لولههای RL پیشنهاد میکند:
- از جمع مشترک بپرهیزید: هرگز برای محیطهای چندپاداشی از جمع ساده استفاده نکنید. همیشه ابتدا کانالها را به طور مستقل نرمال کنید (Normalize-then-Sum).
- محدودیتهای سخت را اعمال کنید: محدودیتهای سخت باید در رابط ابزار (Tool Interface) باشند، نه در وزنهای نرم. اگر یک عامل هرگز نباید دادههای غیرمجاز را در محیط Production بنویسد، این عملیات را در لایه API مسدود کنید. برای اجرای ایمنی صرفاً به پاداشهای منفی تکیه نکنید.
- از نمونهبرداری پویا استفاده کنید: اگر مدل پایه شما کمتر از ۲۰٪ مواقع مشکل را حل میکند، DAPO را فعال کنید تا از اتلاف منابع GPU روی گروههای مرده جلوگیری شود.
- مزیتها را محدود (Clamp) کنید: هنگام ترکیب چندین کانال نرمالشده، یک رولاوت پرت (Outlier) که همزمان در دو کانال جهش میکند، میتواند باعث انحراف شدید سیاست شود. همیشه یک Clamp ایمنی (cmax بین ۳.۰ تا ۵.۰) برای محافظت از پایداری آموزش اعمال کنید.
این تغییر در نرمالسازی نشان میدهد که «هوش» یک عامل، اغلب نه توسط اندازه مدل، بلکه توسط دقت ریاضی حلقه بازخورد آن محدود میشود. همانطور که عاملها از پازلهای ساده به سمت پایگاههای داده عملیاتی حرکت میکنند، توانایی ایجاد توازن بین محدودیتهای متضاد، برنده را تعیین خواهد کرد. در مقیاس وسیعتر، این تکامل در دقت عاملها میتواند منجر به تغییر پارادایم در توسعه نرمافزار شود، جایی که سوارمهای هماهنگ هوش مصنوعی در برابر Copilotهای انفرادی کارایی تیمها را به طور چشمگیری افزایش میدهند.
توسعهدهندگان اکنون باید خط لولههای RLHF خود را ارزیابی کنند تا ببینند آیا «سلطه مقیاس» در حال پنهان کردن شکستهای ایمنی در عاملهای آنهاست یا خیر.
Originally published at g-ftech.com.



گفتگو