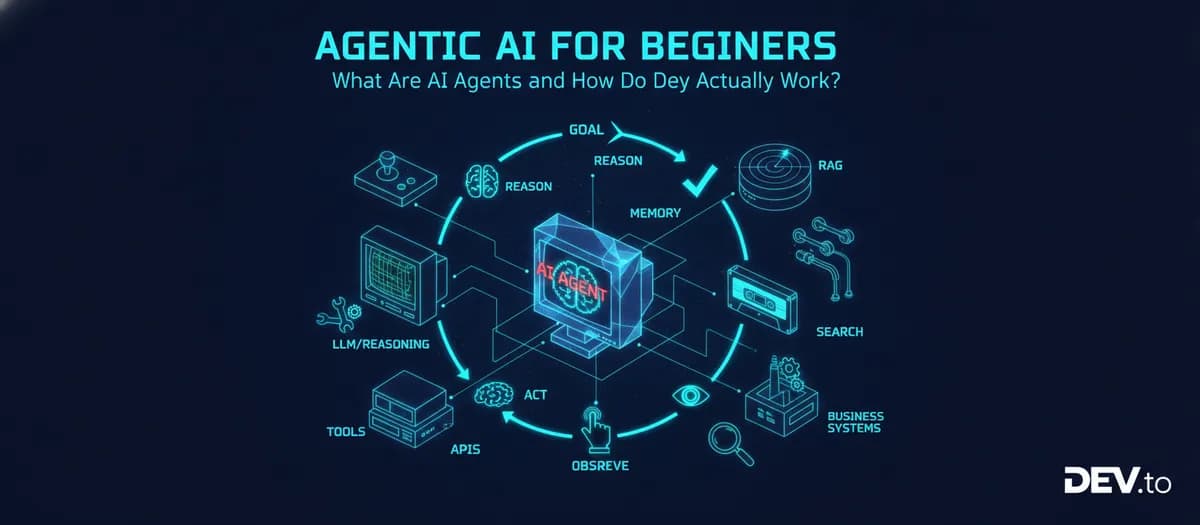
تصور کنید نرمافزاری دارید که بهجای منتظر ماندن برای دستورات تکبهتک، هدف نهایی شما را میفهمد و خودش تصمیم میگیرد چه مسیری را طی کند. این دیگر یک رویای علمی نیست، بلکه واقعیت فعلی تولید نرمافزار است. طبق گزارش فنی مفصلی که در ۳۰ سپتامبر ۲۰۲۶ در وبسایت dev.to منتشر شد، هوش مصنوعی عاملمحور (Agentic AI) در حال جداسازی بنیادین موتور استدلال از لایه اجراست تا عاملهای نرمافزاری کاملاً خودمختاری خلق کند.
این تحول درست زمانی رخ میدهد که صنعت از عصر «چتباتها» عبور میکند. در حالی که هوش مصنوعی زاینده (Generative AI) سنتی بر تولید محتوا تمرکز داشت، هوش مصنوعی عاملمحور بر تکمیل اهداف متمرکز است. همانطور که در تحلیل قبلی ما دربارهی بازسازی بازاریابی دیجیتال در سال ۲۰۲۶ اشاره کردیم، اکنون تمرکز مهندسان بر زیرساختهای مهندسی مورد نیاز برای ساخت سامانههایی است که برای محیطهای سازمانی ایمن و قابلاعتماد باشند. برای درک عمیقتر این گذار، میتوان به نقشه راه تبدیل چتباتها به عاملهای صنعتی اشاره کرد که جزئیات معماریهای عملیاتی را بررسی میکند.
تفاوت این دو را میتوان با تفاوت یک دستور پخت دیجیتال و یک سرآشپز درک کرد. یک برنامه سنتی مثل دستور پخت است؛ یعنی پنج مرحله دقیق را به ترتیب مشخصی اجرا میکند. اما یک عامل هوش مصنوعی شبیه سرآشپز است؛ شما به او هدف «برگزاری یک مهمانی شام» را میدهید و او خودش تصمیم میگیرد چه موادی بخرد، از چه ابزاری استفاده کند و اگر سس غذا خراب شد، چطور آن را اصلاح کند.
زمینه: فراتر از چتباتها
برای درک هوش مصنوعی عاملمحور، باید آن را از نرمافزارهای سنتی و حتی هوش مصنوعی زاینده متمایز کرد. نرمافزارهای سنتی دستوراتی را اجرا میکنند که توسعهدهندگان صراحتاً تعریف کردهاند. هوش مصنوعی زاینده که توسط مدلهای زبانی بزرگ (LLMs) قدرت گرفته است، میتواند زبان طبیعی را بفهمد تا متن، کد، تصویر، صدا و ویدیو تولید کند. اما هوش مصنوعی عاملمحور یک گام فراتر میرود و به نرمافزار اجازه میدهد از مدلهای هوش مصنوعی برای تصمیمگیری درباره «اقدامات لازم» جهت رسیدن به یک هدف استفاده کند.
این رویکرد، روش ساخت نرمافزار را تغییر میدهد. بهجای اینکه به سیستم بگوییم پنج گام را به ترتیب دقیق اجرا کن، توسعهدهندگان میتوانند یک هدف سطحبالا تعریف کنند. سیستم سپس تشخیص میدهد چه گامهایی لازم است، به چه ابزارهایی نیاز دارد و چه زمانی تسک به پایان رسیده است.
بهعنوان مثال، درخواستی را در نظر بگیرید: «سه سفارش آخر من را پیدا کن و بگو کدامیک دیر تحویل شده است». یک چتبات سنتی احتمالاً صرفاً میگوید که به سیستم سفارشات دسترسی ندارد. اما یک عامل هوش مصنوعی میتواند درخواست را بفهمد، نیاز به اطلاعات سفارش را شناسایی کند، یک API مدیریت سفارش را فراخوانی کند، دادهها را بازیابی کند، تاریخهای تحویل را تحلیل کند و نتیجه دقیق را برگرداند.
زمینه: مدل در برابر اپلیکیشن
بسیار حیاتی است که مدل هوش مصنوعی را از اپلیکیشنی که دور آن است جدا کنیم. مدل زبانی بزرگ (LLM) هسته قابلیتهای درک و تولید زبان را فراهم میکند. با این حال، یک LLM بهطور خودکار دسترسی مستقیم به سیستمهای داخلی کسبوکار ندارد. بدون یک معماری عاملمحور، مدل نمیتواند به پایگاه داده، CRM, ERP، APIهای داخلی، سیستمهای پرداخت، پلتفرمهای مانیتورینگ یا اسناد خصوصی شما دسترسی پیدا کند.
یک عامل هوش مصنوعی از ترکیب استدلال مدل با یک لایه اپلیکیشن ساخته میشود که دسترسی به سیستمهای تجاری، دادهها، ابزارها، امنیت و منطق اپلیکیشن را فراهم میکند. در این مدل، LLM به عنوان مؤلفه تصمیمگیرنده عمل میکند، در حالی که محیط اجرای عامل (Agent Runtime) رابطهای تعامل با دنیای واقعی را فراهم میسازد. در این نقطه است که بسیاری از تیمها دچار شکاف معماری میان عاملها و هوش مصنوعی عاملمحور میشوند که میتواند منجر به تأخیرهای جدی در استقرار سازمانی شود.
کالبدشکافی یک عامل
بر اساس گزارش dev.to، یک عامل هوش مصنوعی صرفاً یک مدل زبانی بزرگ نیست. در عوض، LLM به عنوان «مغز» یا مؤلفه استدلال در یک محیط اجرای نرمافزاری بزرگتر عمل میکند. LLM درک و تولید زبان را بر عهده دارد و اپلیکیشن پیرامونی، دسترسی به سیستمهای تجاری، دادهها، امنیت و منطق برنامه را فراهم میکند.
این محیط اجرا، چندین قابلیت حیاتی را به عامل میدهد:
- استدلال (Reasoning): مدل هدف کاربر را تحلیل کرده و گامهای لازم را تعیین میکند. تصمیم میگیرد چه اطلاعاتی مورد نیاز است، کدام ابزار مفید است، چه پارامترهایی باید ارسال شوند و آیا اقدام دیگری لازم است یا خیر. مدل خودش اقدام را اجرا نمیکند، بلکه یک درخواست ابزار ساختاریافته تولید میکند.
- ابزارها (Tools): اینها رابطهای کنترلشدهای هستند — مانند APIهای REST، پایگاه دادهها، موتورهای جستوجو، ماشینحسابها، CRM، ERP، ایمیل، تقویمها و ذخیرهسازهای فایل — که به عامل اجازه تعامل با دنیای واقعی را میدهند. ابزارها مدل را از حالت «فکر میکنم جواب این است» به حالت «میتوانم اطلاعات را بازیابی کنم یا یک عملیات مجاز را انجام دهم» میبرند.
- حافظه (Memory): این قابلیت به دو دسته تقسیم میشود:
- حافظه کوتاهمدت: اطلاعات مورد نیاز در طول تسک فعلی، مانند گفتگوی جاری، هدف فعلی، نتایج ابزارها و وضعیت کنونی.
- حافظه بلندمدت: اطلاعات مفید برای تعاملات آینده، شامل ترجیحات کاربر، تاریخچه تعاملات و زمینههای خاص هر کاربر.
- برنامهریزی (Planning): توانایی شکستن یک هدف سطحبالا به زیر-تسکهای کوچکتر و قابل اجرا. این کار میتواند در ابتدا یا بهصورت پویا انجام شود. برای مثال، برنامهریزی برای یک سفر کاری به لندن با بودجه ۲,۰۰,۰۰۰ روپیه، نیازمند جستوجوی پروازها، مقایسه قیمتها، یافتن هتلها و محاسبه هزینههای کل است.
- حفاظها (Guardrails): مرزهای امنیتی که مانع از انجام اقدامات غیرمجاز توسط عامل میشود. برای مثال، اجازه دادن به عامل برای خواندن دادههای مشتری یا ایجاد تیکتهای پشتیبانی، اما مسدود کردن صریح حذف مشتریان یا صدور استرداد وجه نامحدود.
- مدیریت وضعیت (State Management): ردیابی آنچه عامل در حال حاضر میداند. برای یک تسک استرداد وجه، وضعیت شامل این است که آیا مشتری شناسایی شده، سفارش مشخص شده، واجد شرایط بودن برای استرداد بررسی شده و مبلغ محاسبه شده است یا خیر.
جزئیات: حافظه و زمینه
حافظه یک قابلیت معماری است، نه فقط یک ویژگی ساده. حافظه با «زمینه» (Context) متفاوت است؛ زمینه اطلاعاتی است که برای یک تعامل واحد به مدل داده میشود. اما حافظه شامل ذخیرهسازی و بازیابی عمدی اطلاعات توسط سیستم برای استفاده در آینده است.
- دادههای زمینهای: شامل گفتگوی فعلی، آخرین نتیجه ابزار و وضعیت فعلی تسک است.
- حافظه ذخیرهشده: شامل ترجیحات کاربر (مثلاً «زبان برنامهنویسی مورد علاقه من C# است»)، تعاملات قبلی و اطلاعات تجاری ذخیرهشده است.
سیستمهای عملیاتی باید به سوالات پیچیده حافظه پاسخ دهند: چه چیزی باید به یاد سپرده شود، چه مدت باید نگهداری شود، چه کسی به آن دسترسی دارد و چگونه حافظههای نادرست اصلاح شوند یا دادههای حساس مدیریت گردند.
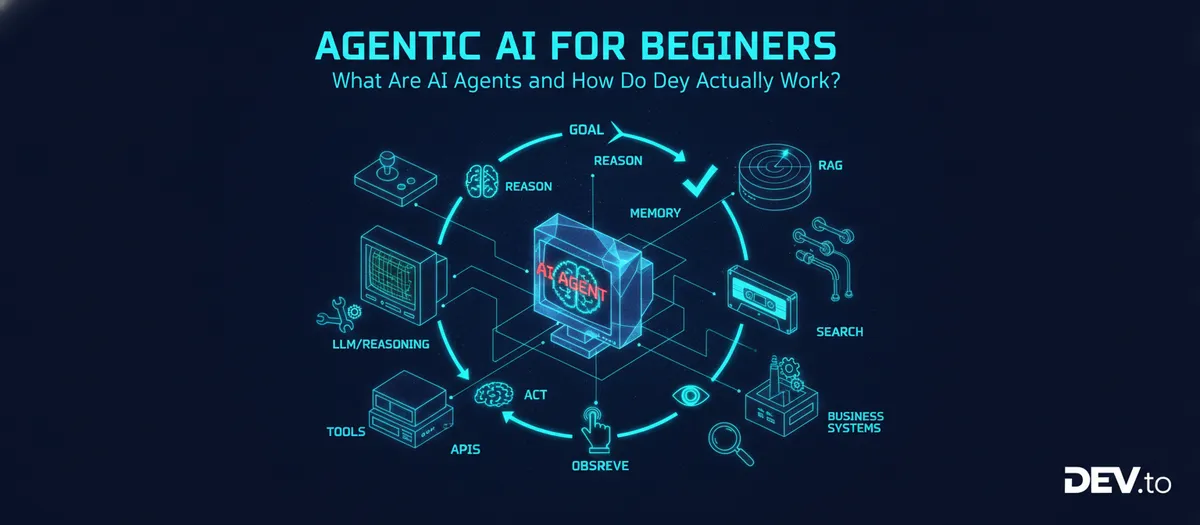
حلقه عاملمحور: استدلال، اقدام، مشاهده
عاملها برخلاف کدهای قطعی (Deterministic)، در یک حلقه پویا عمل میکنند. این فرآیند از یک چرخه خاص پیروی میکند: استدلال $ \rightarrow $ اقدام $ \rightarrow $ مشاهده $ \rightarrow $ استدلال مجدد. این حلقه تا زمان تکمیل تسک یا رسیدن به یک شرط توقف ادامه مییابد.
بهعنوان مثال، اگر از یک عامل بخواهید ارزانترین پرواز به لندن را در یک بودجه خاص پیدا کند، او فقط حدس نمیزند. او پروازها را جستوجو میکند، قیمتها را مشاهده میکند، آنها را با بودجه مقایسه میکند و اگر بودجه exceeded شد، استدلال میکند که باید دوباره با پارامترهای متفاوتی جستوجو کند. این حلقه به عاملها رفتار پویا میدهد و اجازه میدهد وقتی محیط بر گام بعدی تأثیر میگذارد، خود را تطبیق دهند.
این حلقه قدرتمند است اما ریسکهایی را به همراه دارد. خودمختاری بیشتر، فرصت بیشتری برای تصمیمات غلط، استفاده نادرست از ابزارها، هزینههای غیرمنتظره، مسائل امنیتی، حلقههای بینهایت و اقدامات ناخواسته ایجاد میکند. در نتیجه، عاملهای عملیاتی به کنترلهای سختگیرانهای نیاز دارند.
فراخوانی ابزار و ادغام سازمانی
ابزارها همان چیزی هستند که LLM را از یک تولیدکننده متن به یک «کنشگر» تبدیل میکنند. وقتی یک عامل تصمیم میگیرد از ابزاری استفاده کند، یک درخواست ساختاریافته — اغلب در قالب JSON — تولید میکند که ابزار و آرگومانهای مورد نیاز را مشخص میکند. برای مثال، یک درخواست ممکن است به این شکل باشد: {"tool": "GetOrder", "arguments": {"orderId": "12345"}}.
در یک محیط عملیاتی، مدل هوش مصنوعی دسترسی نامحدود به سیستمها ندارد. در عوض، یک «درگاه ابزار» (Tool Gateway) احراز هویت، مجوزدهی و محدودیت نرخ (Rate Limiting) را مدیریت میکند. این امر تضمین میکند که در حالی که هوش مصنوعی تصمیم میگیرد «چه کاری» انجام دهد، اپلیکیشن همچنان کنترل «چگونگی» اجرا را در دست دارد.
ابزارهای سازمانی باید به عنوان APIهایی با ویژگیهای زیر در نظر گرفته شوند:
- طرحهای (Schemas) ورودی و خروجی شفاف
- احراز هویت و مجوزدهی سختگیرانه
- اعتبارسنجی ورودیها
- گزارشگیری جامع و ردپای حسابرسی (Audit Trails)
- محدودیتهای نرخ و زمانهای انتظار (Timeouts)
- مدیریت خطای قدرتمند
RAG در برابر عاملها
یک باور غلط رایج وجود دارد که تولید بازیابیافزا (RAG) و عاملها فناوریهای رقیب هستند. در واقع، RAG اغلب ابزاری است که «توسط» یک عامل استفاده میشود. RAG از الگوی زیر پیروی میکند: سوال کاربر $ \rightarrow $ بازیابی اطلاعات مرتبط $ \rightarrow $ مدل LLM $ \rightarrow $ پاسخ.
در حالی که RAG در درجه اول به سیستم کمک میکند تا اطلاعات مرتبط برای پاسخ به یک سوال را پیدا کند، یک عامل از آن اطلاعات و ابزارهای دیگر برای تکمیل یک هدف استفاده میکند. برای مثال، یک دستیار کارمند ممکن است از RAG برای بازیابی سیاست مرخصی شرکت استفاده کند و سپس از یک API مجزای کارکنان برای بررسی موجودی مرخصی کاربر قبل از پیشنهاد تاریخ تعطیلات استفاده نماید. عامل، سیاست (RAG) و موجودی (API) را ترکیب میکند تا یک پاسخ کامل ارائه دهد.
چه زمانی از عاملها دوری کنیم؟
علیرغم تبلیغات زیاد، رفتار عاملمحور همیشه انتخاب مهندسی درستی نیست. این گزارش هشدار میدهد که از عاملها برای فرآیندهایی که کاملاً قطعی هستند استفاده نکنید. اگر یک فرآیند تجاری یک توالی شناخته شده است — مانند «دریافت سفارش $ \rightarrow $ تایید پرداخت $ \rightarrow $ رزرو موجودی $ \rightarrow $ ایجاد محموله $ \rightarrow $ ارسال اعلان» — یک گردشکار سنتی ارزانتر، سریعتر و پیشبینیپذیرتر است.
عاملها همچنین برای موارد زیر نامناسب هستند:
- عملیات حساس به تأخیر: اگر پاسخ در کمتر از ۱۰ میلیثانیه مورد نیاز است، حلقه استدلال بسیار کند است.
- رفتار قطعی اجباری: عملیات مالی، ایمنی-بحرانی یا حساس به انطباق ممکن است نیازمند اجرای کنترلشدهای باشند که در آن هوش مصنوعی فقط توصیه میکند، اما منطق تجاری اجرا را مدیریت میکند.
- دسترسیهای بیش از حد: عاملها هرگز نباید مجوزهای غیرضروری دریافت کنند؛ آنها باید از اصل «حداقل امتیاز» (Least Privilege) پیروی کنند.
مسیر رسیدن به تولید
ساخت یک عامل آماده تولید نیازمند عبور از پرامپتنویسی ساده است. توسعهدهندگان باید الگوهای «انسان در حلقه» (Human-in-the-loop) را برای اقدامات حساس پیاده کنند. برای مثال، یک عامل ممکن است مبلغ استرداد را ۵۰,۰۰۰ روپیه محاسبه کند، اما تراکنش مالی واقعی باید یک درخواست تایید دستی برای یک مدیر انسانی ارسال کند.
از نظر معماری، این کار اغلب شامل یک سیستم چندعاملی است که در آن یک «هماهنگکننده» (Orchestrator) درخواستها را به عاملهای متخصص (مثلاً عامل HR، عامل مالی و عامل IT) ارجاع میدهد. هر عامل متخصص میتواند دستورالعملها، ابزارها، مجوزها و دانش منحصر به فرد خود را داشته باشد. با این حال، گزارش هشدار میدهد که سیستم را بیش از حد پیچیده نکنید؛ افزودن عاملهای بیشتر باعث افزایش تأخیر، هزینه و تعداد نقاط شکست احتمالی میشود و عیبیابی و مدیریت وضعیت را دشوارتر میکند.
برای کسانی که این سیستم را روی Azure پیاده میکنند، یک معماری تولید ممکن است شامل Azure Front Door، API Management و یک ASP.NET Core API باشد که از Azure OpenAI و Azure AI Search برای حافظه و RAG استفاده میکند و از طریق یک Tool Gateway به Azure SQL یا Service Bus متصل میشود. سرویسهای پشتیبان ممکن است شامل Microsoft Entra ID، Azure Key Vault، Application Insights، Azure Monitor، OpenTelemetry و Cosmos DB یا Redis برای مدیریت وضعیت باشد.
این تکامل، سوال بنیادی مهندسان را تغییر میدهد. هدف دیگر این نیست که «چگونه یک عامل بسازم؟» بلکه این است که «چه سطحی از خودمختاری برای این مسئله تجاری خاص مناسب است؟»
برای شروع پیادهسازی این الگوها، توسعهدهندگان باید این نقشه راه را دنبال کنند:
- یادگیری هوش مصنوعی زاینده: تسلط بر LLMها، پرامپتها، توکنها، پنجرههای زمینه و Embeddingها.
- یادگیری فراخوانی ابزار: درک Function Calling، طرحهای ابزار و خروجیهای ساختاریافته.
- یادگیری RAG: تمرکز بر Embeddingها، جستوجوی برداری، بازیابی، تکهبندی (Chunking) و مبنیسازی (Grounding).
- یادگیری مفاهیم عامل: مطالعه حلقه عامل، وضعیت، حافظه، برنامهریزی و حفاظها.
- ساخت یک عامل ساده: شروع با ابزارهای ابتدایی مانند ماشینحساب یا API آبوهوا.
- یادگیری چارچوبهای عامل: بررسی Semantic Kernel، LangChain، LangGraph یا Microsoft Agent Framework.
- یادگیری معماری تولید: تمرکز بر امنیت، هویت، مشاهدهپذیری (Observability)، مدیریت هزینه و قابلیت حسابرسی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو