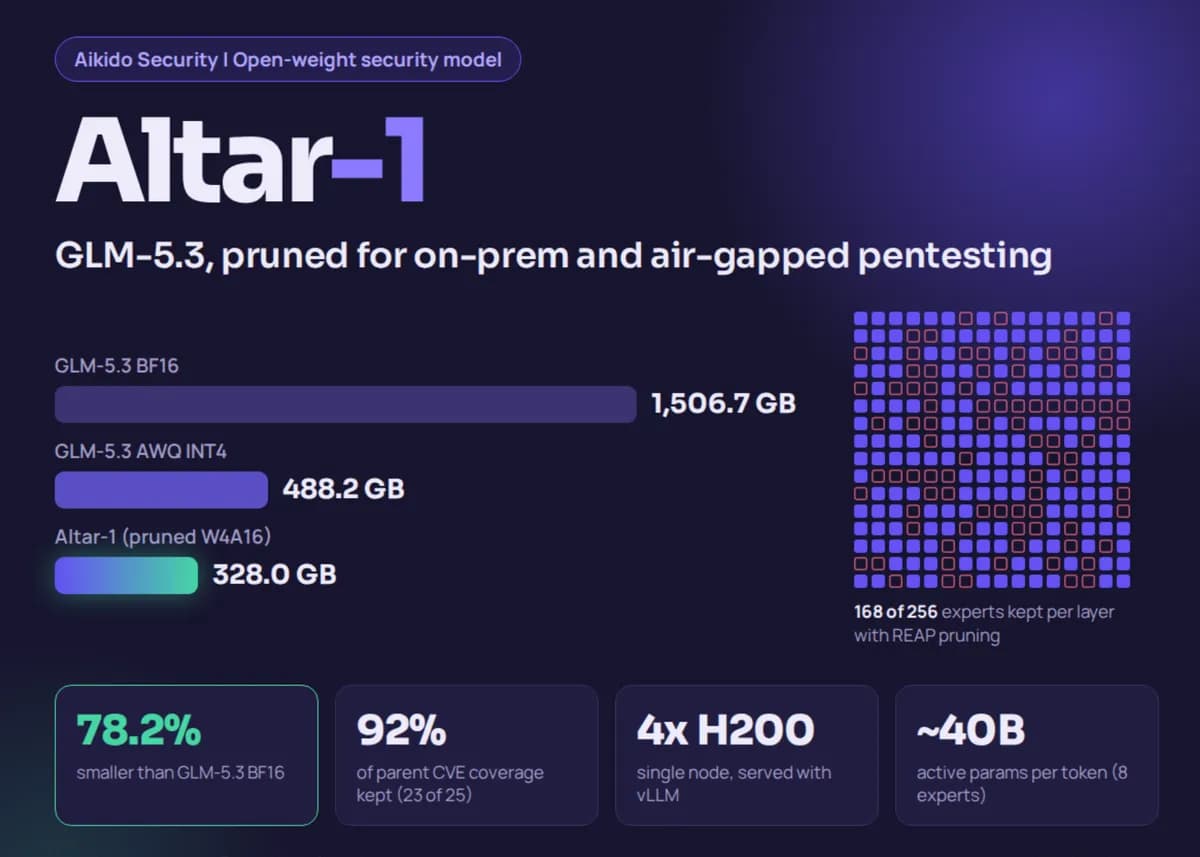
استقرار مدلهای پیشرو در شبکههای ایزوله (Air-gapped) معمولاً به خوشههای سختافزاری عظیم یا انتقال ریسکپذیر دادهها به ابر نیاز دارد. اما Aikido Security با معرفی مدل Altar-1، این شکاف زیرساختی را پر کرده است. این مدل با فشردهسازی مدل عظیم GLM-5.3 از ۱۵۰۶.۷ گیگابایت به ۳۲۸ گیگابایت، امکان میزبانی شخصی (Self-hosting) را فراهم میکند.
این انتشار، یک نقطه اصطکاک بحرانی را برای بانکها و اپراتورهای فناوری عملیاتی (OT) برطرف میکند؛ سازمانهایی که نمیتوانند کد منبع، مستندات معماری یا یافتههای امنیتی اصلاحنشده را به خارج از شبکه خود ارسال کنند. در حالی که مدلهای با وزنهای باز (Open-weight) معمولاً مشکل اقامت دادهها (Data Residency) را حل میکنند، معماریهای ترکیب خبرهها (Mixture of Experts یا MoE) اغلب یک شکاف استقرار ایجاد میکنند؛ زیرا این معماریها کاربر را مجبور میکنند تمام خبرهها را ذخیره کند، صرفنظر از اینکه در لحظه چه حجم از بار کاری فعال است.
چالش اقامت دادهها
زمینه امنیتی بسیار حساس است. مدلهای پیشرو بسته (Closed Models) روی زیرساختهای شخص ثالث اجرا میشوند و برای سازمانهایی که تحت دستورات سختگیرانه اقامت دادهها هستند، ریسک ایجاد میکنند. این نگرانیها در حالی شدت مییابد که حفرههای امنیتی در زیرساختهای مدیریت داده سازمانی همچنان یکی از چالشهای جدی در مسیر حفاظت از اطلاعات حساس است. علاوه بر این، عاملهای امنیتی زمینههای (Context) طولانیمدتی میسازند؛ در نتیجه، حافظه پنهان KV (KV cache) حاصل از این فرآیند برای فضای حافظه GPU با وزنهای مدل رقابت میکند. همین موضوع باعث میشود فشردهسازی کارآمد برای قابلیت اجرا در محیطهای On-premise ضروری باشد.
با تکیه بر پوشش قبلی ما درباره دستورالعملهای پیشآموزش با بهرهوری محاسباتی، مدل Altar-1 بر فشردهسازی پس از آموزش (Post-training compression) تمرکز دارد تا مدلهای با پارامترهای بالا روی سختافزارهای محدود قابل اجرا کند. این مدل، «ماشین ایکیدو» (Aikido Machine) را تغذیه میکند؛ یک دستگاه تست نفوذ خودکار که برای شبکههای On-prem و ایزوله طراحی شده است. همچنین این مدل در ابزارهای Aikido Attack، تحلیل کد AI و Deep Review به کار میرود.
به نقل از گزارش فنی Marktechpost، تیم توسعه این کاهش حجم را از طریق یک فرآیند دو مرحلهای به دست آورده است:
خط لوله فشردهسازی
- کوانتش (Quantization): فرآیند با نقطه بازرسی GLM-5.3-AWQ-INT4 آغاز شد. در این روش از وزنهای ۴ بیتی برای خبرههای مسیریابی (W4A16) با فعالسازهای ۱۶ بیتی استفاده شده است، در حالی که لایههای توجه (Attention)، خبره مشترک، لایههای متراکم (Dense layers) و سر مدل (Head) در حالت BF16 حفظ شدهاند.
- هرس کردن خبرهها (Expert Pruning): تیم توسعه با استفاده از متد Cerebras REAP (هرس فعالسازی خبره با وزن مسیریاب)، خبرهها را بر اساس وزن مسیریاب و بزرگی خروجی امتیازدهی کردند، نه صرفاً بر اساس دفعات انتخاب.
مدل Altar-1 تنها ۱۶۸ خبره از ۲۵۶ خبره اصلی در هر لایه را حفظ کرده و ۸۸ خبره (۳۴.۴٪) را بدون نیاز به هیچگونه آموزش مجدد حذف نموده است. برای محافظت از خبرههای متخصص در زمینههای کدنویسی، زبانهای نادر و خروجیهای ساختاریافته، هر خبره بر اساس بیشترین سهمش در کار مسیریابی هر دامنه واحد امتیازدهی شد. برای کالیبراسیون، از ردپاهای (Traces) مربوط به ابزار تست نفوذ ایکیدو، فراخوانی ابزارها (Tool calling)، استدلال، کدنویسی و متون ویکیپدیا به زبانهای مختلف استفاده شد. شرکت صراحتاً اعلام کرد که در این فرآیند از هیچ دادهای متعلق به مشتریان استفاده نشده است.
دقت مدل و ابعاد
مدل Altar-1 نسبت به نسخه BF16 حدود ۷۸.۲٪ و نسبت به نسخه AWQ (والد خود) حدود ۳۲.۸٪ کوچکتر است. در یک مطالعه دقت عمومی با استفاده از یک پانل بسته شامل ۲۵ پرامپت، مدل Altar-1 واگرایی KL معادل ۰.۵۰۶ نات را نسبت به مدل کامل BF16 نشان داد. برای مقایسه، یک ساختار EXL3 از همین برش، امتیاز ۰.۵۱۱ را کسب کرد.
عملکرد و سختافزار
بر اساس بررسیهای داخلی روی یک محک CVE که ۳۲ آسیبپذیری شناختهشده در ۳۰ مخزن کد را پوشش میداد (با ۳ بار اجرا برای هر مورد)، Altar-1 به میانگین Recall (بازخوانی) ۶۰.۴٪ رسید. این عدد در مقایسه با ۶۱.۵٪ برای نسخه AWQ INT4 و ۶۵.۶٪ برای مدل کامل BF16، افت بسیار اندکی را نشان میدهد. نکته کلیدی این است که مدل جدید، پوشش ۲۳ مورد از ۲۵ آسیبپذیری شناساییشده توسط مدل مادر را حفظ کرد که نشاندهنده نرخ حفظ ۹۲٪ است.
اگرچه این محک محدود است و بیشتر بر بازشناسی هدفمند CVEها تمرکز دارد تا کشف کور یا اعتبارسنجی اکسپلویت، اما Aikido گزارش داده است که Altar-1 در یک تست نفوذ واقعی روی محیط عملیاتی یک مشتری، یک آسیبپذیری با شدت بحرانی (Critical) را شناسایی کرده است.
مشخصات استقرار
برای اجرای این مدل به GPUهای سری Hopper انویدیا نیاز است. یک گره شامل ۴ عدد H200 حافظه کافی برای ۳۲۸ گیگابایت وزنها و یک KV Cache با پنجره زمینه ۱۲۸ هزار توکنی در اندازههای دستهای (Batch sizes) تولیدی را فراهم میکند. در مقابل، یک گره ۴ عددی H100 با ۸۰ گیگابایت حافظه (۳۲۰ گیگابایت کل)، حتی برای بارگذاری وزنها به تنهایی ناکافی است.
متخصصان میتوانند این مدل را از طریق vLLM مستقر کنند که بهطور خودکار کرنل Marlin MoE را انتخاب میکند:vllm serve AikidoSec/altar-1 --tensor-parallel-size 4 --trust-remote-code --max-model-len 131072
این تغییر در استراتژی استقرار، این فرض را که عاملهای امنیتی با دقت بالا حتماً به زیرساختهای در مقیاس ابری نیاز دارند، تغییر میدهد. Aikido با اثبات اینکه نزدیک به ۳۵٪ از خبرههای MoE را میتوان با حداقل افت بازخوانی هرس کرد، نشان داد که مدلهای امنیتی تخصصی را میتوان برای لبه (Edge) «اندازه مناسب» (Right-sized) کرد، بدون آنکه توان استدلالی مدل مادر ۷۵۳ میلیارد پارامتری (که در هر توکن از حدود ۴۰ میلیارد پارامتر فعال استفاده میکند) از دست برود.
برای متخصصان فنی، این یعنی دستگاههای تست نفوذ خودکار اکنون میتوانند کاملاً درونسازمانی و بدون تأخیر یا ریسکهای امنیتی API اجرا شوند. این مدل از مجوز GLM-5.3 پیروی میکند که اجازه استفاده تجاری و توزیع مجدد را میدهد، به شرطی که شرکتهایی با درآمد بیش از ۱۰ میلیارد دلار در ۱۲ ماه گذشته، بررسی امنیتی Z.AI را بگذرانند. لازم به ذکر است که Altar-1 یک مدل با وزنهای باز است و نه لزوماً متنباز (Open Source) طبق استانداردهای OSI.
Aikido قصد دارد در آینده با استفاده از فرمتهای کمبیتتر مانند EXL3، تعداد خبرههای بیشتری را حفظ کرده و نسخههای بعدی را بهطور اختصاصی برای گردشکارهای امنیتی تنظیم دقیق (Fine-tuning) کند.
گام بعدی شما
- اگر در محیطهای حساس امنیتی فعالیت میکنید، مدل Altar-1 را برای جایگزینی APIهای ابری در تحلیل کد بررسی کنید.
- برای استقرار، حتماً از گرههای H200 استفاده کنید تا فضای کافی برای KV Cache در پنجرههای متنی بزرگ داشته باشید.
- مستندات vLLM را برای بهینهسازی کرنل Marlin در مدلهای MoE مطالعه کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو