تصور کنید یک دستیار حقوقی، قانونی که سالها پیش لغو شده را صرفاً چون در اسناد بیشتری تکرار شده، بهعنوان مرجع معرفی کند. این دقیقاً همان نقطهای است که اکثر سیستمهای فعلی شکست میخورند، اما عامل Nebula راهکاری برای پایان دادن به این توهمات ارائه داده است. آیا یک مدل زبانی بزرگ (LLM) میتواند بهطور قابلاعتمادی بین یک کتابچه قانون اصلی و یک بهروزرسانی رسمی (Errata) تفاوت قائل شود؟
در ۲۷ سپتامبر ۲۰۲۶، این عامل ثابت کرد که میتواند این کار را انجام دهد. Nebula با استفاده از دادههای ساختاریافته، تضادهای میان دو منبع رسمی را بهطور فعال شناسایی و علامتگذاری کرد. طبق گزارش توسعهدهنده، این سیستم که اخیراً عرضه شده است، فراتر از بازیابی ساده اطلاعات میرود تا ناهماهنگیهای بحرانی را در دادهها پیدا کند.
بسیاری از سیستمهای تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — بر جستوجوی برداری (Vector Search) متکی هستند. این روش اغلب حقایق متضاد را با هم ترکیب کرده و یک پاسخ متقاعدکننده اما غلط تولید میکند. این وضعیت منجر به ایجاد یک «توهم» میشود؛ جایی که هوش مصنوعی بهروزرسانی جدیدترین سند را نادیده میگیرد، زیرا سند قدیمیتر تطابق کلمات کلیدی بیشتری دارد. در واقع، مدل ممکن است بهدلیل تعداد تکرارهای بیشتر، یک سند قدیمی را به بهروزرسانی جدید ترجیح دهد و دچار توهم (Hallucination) — یعنی حالتی که مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد — شود.
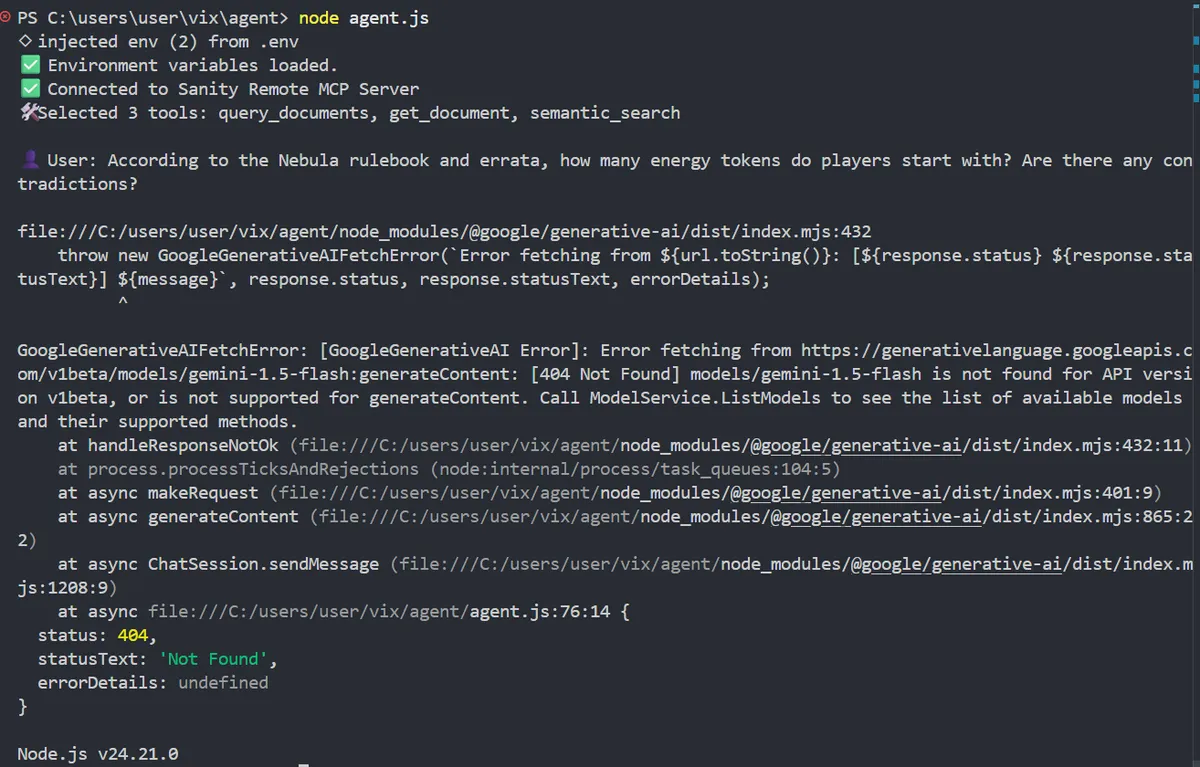
همانطور که در تحلیلهای قبلی ما دربارهی امنیت و دقت مدلهای زبانی اشاره کردیم، اتکا به شباهتهای معنایی همیشه کافی نیست. برای حل این مشکل، عامل Nebula از یک مدل محتوای ساختاریافته که روی پلتفرم Sanity میزبانی شده است، استفاده میکند. این رویکرد یادآور تلاشهای مشابه برای افزایش شفافیت است، مانند سیستمی که ردپای شواهد را برای ادعاهای هوش مصنوعی قابلتعقیب کرد تا از توهمات جلوگیری شود. این عامل بهجای جستوجوی تکههای متن (Text Chunks)، از طریق فراخوانی تابع (Function Calling) در مدل Gemini 3.5 Flash Lite، کوئریهای GROQ (پرسوجوهای شیء رابطهای گراف) را بهصورت لحظهای و در زمان اجرا مینویسد. این سازوکار به مدل اجازه میدهد بهجای تکیه بر شباهتهای مبهم معنایی، مستقیماً فیلدهای خاصی مانند _type (نوع)، title (عنوان) و source (منبع) را بازخواست کند.
زمینه: چالش Nebula
این پروژه برای «چالش Sanity» در مسیر اول با عنوان «ارسال عاملی که محتوای واقعی را کوئری میکند» (Ship an Agent That Queries Real Content) طراحی شد. هدف این بود که عاملی ساخته شود که بتواند به پرسشهای مربوط به یک بازی تخیلی به نام Nebula پاسخ دهد و همزمان تضادهای موجود در منابع مختلف را برملا کند.
برخلاف جستوجوی کلمات کلیدی که صرفاً تمام مقالات مشابه را برمیگرداند، این عامل بهگونهای طراحی شده است که درباره ماهیت اسناد استدلال کند. مدل تشخیص میدهد که یک سند «اصلاحیه» (Errata) نسبت به «کتابچه قانون» اصلی، مرجعیت و اولویت دارد. این قابلیت به او اجازه میدهد بهجای ارائه یک خلاصه گیجکننده از تمام متون، یک پاسخ اصلاحشده و دقیق ارائه دهد. این توانایی در تحلیل دقیق منابع، مشابه رویکردی است که در سیستم Paper2Agent برای تبدیل مقالات پژوهشی به کدهای قابل اجرا به کار گرفته شده است.
جزئیات: معماری فنی
بر اساس مستندات پروژه، زیرساخت فنی این سیستم شامل موارد زیر است:
- پشته تکنولوژی: این عامل توسط Node.js و مدل Gemini 3.5 Flash Lite (در سطح رایگان) قدرت گرفته است. برای اجرای کوئریهای GROQ از کتابخانه
@sanity/clientو برای پیادهسازی منطق فراخوانی تابع از@google/genaiاستفاده شده است. - مدل محتوا: توسعهدهنده یک نوع سند واحد در Sanity Studio با استفاده از TypeScript تعریف کرده است. اسکیمای
articleاز چهار فیلد مشخص تشکیل شده است:title(رشته متنی)slug(شناسه منحصربهفرد که از عنوان استخراج میشود)body(متن اصلی)source(آدرس URL)
- مجموعه داده: عامل، پروژه
uyvc8silرا در مجموعه دادهproductionکوئری میزند. این مجموعه داده با سه سند خاص پر شده بود تا تضادهای عمدی ایجاد شود: کتابچه قانون اصلی Nebula، اصلاحیه رسمی Nebula و یک راهنمای استراتژیک با عنوان «چگونه در Nebula پیروز شویم».
سازوکار شناسایی تضادها
این عامل برای تضمین صحت حقایق و یکپارچگی دادهها، یک چرخه چهارمرحلهای را طی میکند:
۱. تولید کوئری: وقتی سوالی پرسیده میشود، LLM یک کوئری GROQ مینویسد. برای مثال، برای یافتن قوانین، ممکن است چنین کوئریای تولید کند: [_type match "*rule" || _type match "errata" || lower(title) match "rule" || lower(title) match "errata"].
۲. اجرای زنده: کد این کوئری را از طریق @sanity/client روی مجموعه داده تولیدی اجرا میکند. توسعهدهنده گزینه useCdn(false) را تنظیم کرده تا CDN غیرفعال شود و پاسخها همیشه بهصورت ۱۰۰٪ لحظهای و تازه از «دریاچه محتوا» (Content Lake) دریافت شوند.
۳. تحلیل زمینهای: نتایج JSON به کانتکست مدل زبانی بازگردانده میشوند. در پرامپت سیستمی (System Prompt) صراحتاً به مدل دستور داده شده است: «وقتی دو منبع با هم تضاد داشتند، هر دو ادعا را در کنار هم با ذکر منابعشان نمایش بده. برای هر ادعا، URL منبع را ذکر کن. هرگز اطلاعات ابداع نکن».
۴. گزارشدهی موازی: اگر LLM یک تفاوت عددی یا واقعی شناسایی کند، هر دو ادعا را به همراه URLهای مربوطه ارائه میدهد.
در یک تست زنده درباره توکنهای انرژی اولیه، عامل شناسایی کرد که در بخش Setup کتابچه قانون اصلی Nebula، ذکر شده که بازیکنان با ۵ توکن انرژی شروع میکنند (منبع: https://example.com/nebula-rulebook)، در حالی که اصلاحیه رسمی Nebula نسخه ۲.۱ این مقدار را به ۸ توکن انرژی اصلاح کرده است (منبع: https://example.com/nebula-errata).
تست دیگری درباره شرط پیروزی نیز تضاد مشابهی را آشکار کرد. کتابچه قانون اصلی و راهنمای استراتژیک ادعا میکردند که بازیکنان برای پیروزی باید ۱۰ ستاره جمع کنند، اما اصلاحیه رسمی نسخه ۲.۱ شرط پیروزی را به ۱۲ ستاره بهروزرسانی کرده بود.
طراحی و استقرار
سیستم بر روی یک پشته سبک شامل Node.js، Gemini 3.5 Flash Lite و Sanity Content Lake بنا شده است. یک تصمیم کلیدی در طراحی، استفاده از «پرامپتهای مبتنی بر اسکیما» بود. در ابتدا، مدل زبانی انواع اسناد را اشتباه حدس میزد (مثلاً بهجای article از کلماتی مثل card یا document استفاده میکرد) که منجر به نتایج خالی میشد. توسعهدهنده این مشکل را با تزریق توصیف واقعی اسکیما به پرامپت سیستمی حل کرد و به عامل آموخت که دقیقاً چگونه نوع article را کوئری بزند.
با تبدیل دریاچه محتوا به تنها منبع حقیقت، مدل از حقایق سختافزاری (Hardcoded) فاصله گرفته است. هر فکتی که گزارش میشود، حاصل یک کوئری زنده GROQ است. اگر توسعهدهندهای سندی را در Sanity Studio بهروزرسانی کند، پاسخ بعدی عامل بلافاصله آن تغییر را منعکس میکند. این معماری، مدل زبانی را از یک نویسنده خلاق به یک «حسابرس داده» تبدیل میکند.
این رویکرد نشان میدهد که آینده عاملهای قابلاعتماد، نه در مدلهای بزرگتر، بلکه در ساختارهای دادهای بهتر است. وقتی هوش مصنوعی میفهمد برچسب «اصلاحیه» بر «کتابچه قانون» ارجحیت دارد، از حدسهای احتمالی به استدلال قطعی (Deterministic Reasoning) میرسد.
برای توسعهدهندگان، این یعنی مرحله «پاکسازی» و آمادهسازی دادهها، در واقع مهمترین بخش خط لوله هوش مصنوعی است. انتقال از فایلهای متنی ساده (Flat Text) به اسکیماهای ساختاریافته، به عاملها اجازه میدهد درباره منشأ دادهها (Provenance) استدلال کنند؛ یعنی بدانند نه فقط «چه چیزی» گفته شده، بلکه «چه کسی» و «چه زمانی» آن را گفته است.
گام بعدی شما
- اگر از RAG استفاده میکنید، بهجای تکیه مطلق بر بردارها، فیلدهای متادیتای ساختاریافته (مانند تاریخ یا سطح اعتبار) را به کوئریهای خود اضافه کنید.
- برای کاهش توهمات در اسناد فنی، از مدلهای ارزانقیمت اما سریع مثل Gemini Flash برای نوشتن کوئریهای دقیق روی دیتابیس استفاده کنید.
- مستندات پروژه را در گیتهاب (
https://github.com/Vicarioy/sanity-nebula-agent.git) بررسی کنید تا متوجه شوید چگونه GROQ میتواند جایگزین بردار معنایی (Embedding) — که مثل کارت معرفی عددی برای هر واژه است تا همسایگانش را بشناسد — در کارهای حساس و با دقت بالا شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو