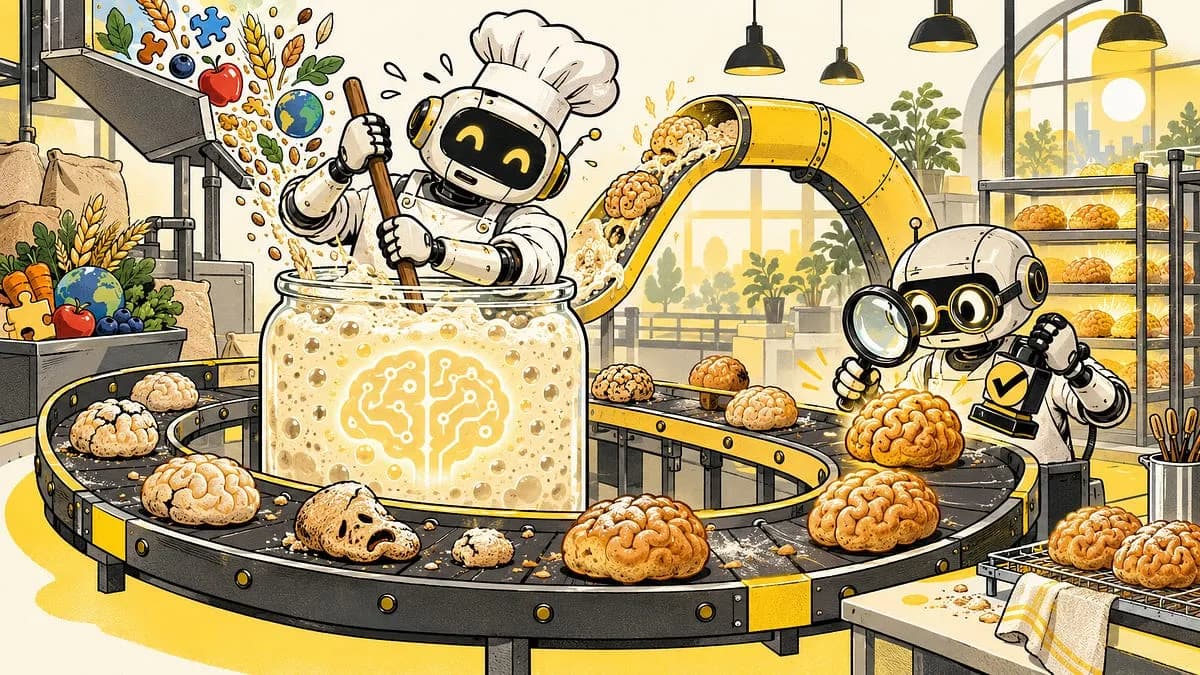
تصور کنید مدلهای هوش مصنوعی بهجای تکیه بر دادههای ثابت، بتوانند از اشتباهات خود درس بگیرند و در هر تکرار دقیقتر شوند. این دقیقاً همان اتفاقی است که در پشتپردهٔ مدلهای پیشرو رخ میدهد و آنها را از یک چتبات ساده به یک عامل (Agent) تبدیل میکند.
به نقل از تحلیل ۲۲ سپتامبر ۲۰۲۶ توسط The Sequence، موتور واقعی تولید مدلهای توانمند امروز، نه معماریهای پیچیده، بلکه خط لولههای «پسآموزش» (Post-training) در مقیاس صنعتی است. همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تمرکز صنعت از طراحی تئوریک به سمت بهینهسازی عملیاتی تغییر کرده است. این رویکرد در واقع تکامل همان فرآیندهایی است که برای همراستایی مدلها با ترجیحات و رفتار انسانی به کار میروند تا خروجیها کاربردیتر شوند.
در حالی که بحثهای مربوط به «خودبهبودی بازگشتی» (Recursive Self-Improvement) اغلب در سطح تئوری باقی میمانند، صنعت در دو سال اخیر روی اتوماسیون «کارخانه تولید مدل» متمرکز شده است. این فرآیند، کارهایی که نیاز به پاسخ انسان دارند را از کارهایی که بهصورت برنامهریزیشده قابل تأیید هستند جدا میکند تا تکرارهای سریع و خودکار ممکن شود. البته در این مسیر، حفظ تنوع در معماری مدلها ضروری است، زیرا عدم تنوع در خانواده مدلها میتواند منجر به مسمومسازی یادگیری در عاملهای خودبهبودبخش شود.
سازوکار اصلی این سیستم بهصورت یک حلقه مداوم عمل میکند:
- مدل چندین پاسخ کاندید برای یک مسئله خاص تولید میکند.
- یک سامانه خودکار، این پاسخها را امتیازدهی کرده و باکیفیتترین آنها را شناسایی میکند.
- پاسخهای با امتیاز بالا مجدداً به مجموعه دادههای آموزشی بازگردانده میشوند.
- مدل بر اساس این دادههای پالایششده بازآموزی میشود تا احتمال تولید پاسخ درست در چرخه بعدی افزایش یابد.
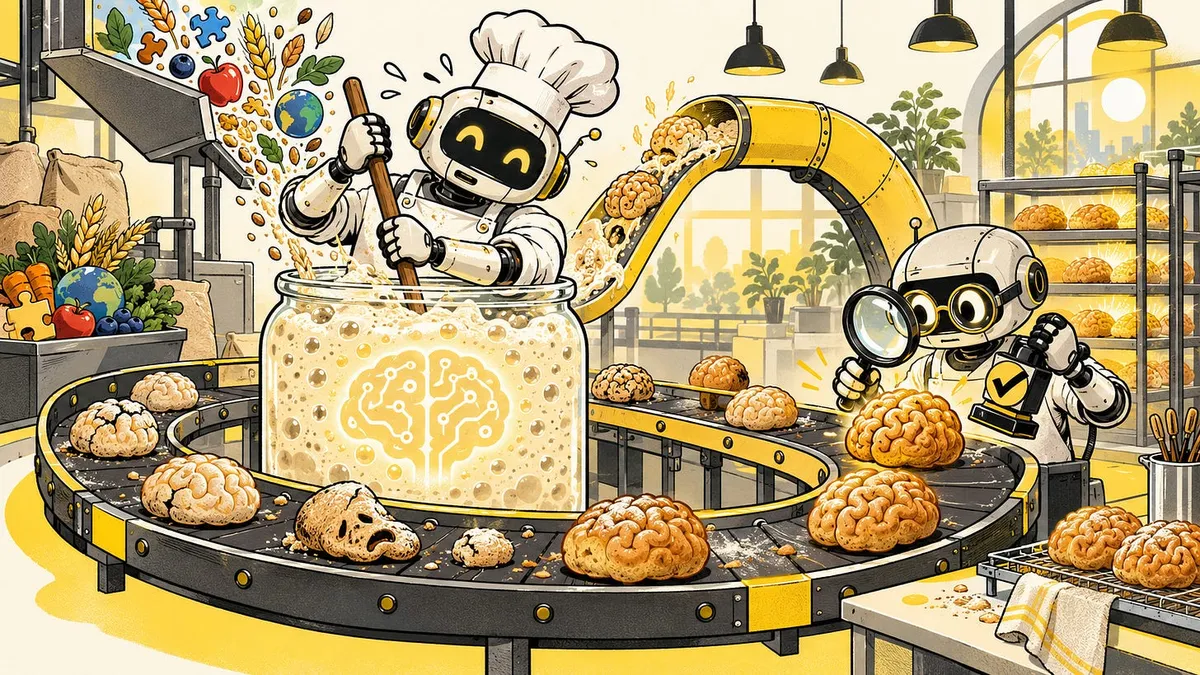
بر اساس مستندات فنی، این حلقه در طول زمان نامهای مختلفی به خود گرفته است؛ از STaR (Self-Taught Reasoner) در سال ۲۰۲۲ گرفته تا RLVR (Reinforcement Learning from Verifiable Rewards) در سال ۲۰۲۵ و در نهایت اصطلاح کلی «پسآموزش» در ساختارهای سازمانی فعلی.
برای متخصصان این حوزه، این تحول به معنای انتقال تمرکز از «دفتر طراحی» (معماری مدل) به «کارخانه» (حلقههای داده) است. این موضوع ثابت میکند که گذار از چتبات به عامل، یک جهش ناگهانی در معماری نبوده، بلکه نتیجه مقیاسپذیری یک حلقه خاص از تأیید و آموزش است.
گام بعدی شما
- بررسی نحوه ادغام این حلقهها با بازخوردهای محیطی در لحظه (Real-time feedback).
- دنبال کردن گذار از کلیدهای پاسخ ایستا به سیستمهای تأیید پویا و عاملمحور.
- مطالعه متدهای جدید در RLVR برای کاهش نرخ توهم در مدلهای استدلالی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو