تصور کنید یک برنامهنویس در تیمی کوچک است که باید هر روز با دهها ابزار داخلی شرکت و قوانین پیچیده دستوپنجه نرم کند؛ حالا تصور کنید هوش مصنوعی شما دقیقاً در همان نقطهای که شما تجربه دارید، گیر میکند. اینجاست که تفاوت بین یک مدل «باهوش» و یک مدل «کارآمد» مشخص میشود. یک مدل ممکن است بهطور کلی توانمند باشد، اما همچنان در یک گردشکار خاص دچار مشکل شود، ترکیبی از ابزارها را بهطور اشتباه به کار ببرد یا در رعایت یک محدودیت خاص شکست بخورد. این اتفاق به این دلیل میافتد که عاملهای هوش مصنوعی سازمانی اغلب نه به دلیل فقدان هوش عمومی، بلکه به دلیل دشواری در درک قوانین خاص، ابزارها و وضعیتهای دادهای در یک محیط شرکتی شکست میخورند؛ کارهایی که توسط سیستمهای مورد استفاده و قوانینی که دنبال میکنند شکل گرفته است.
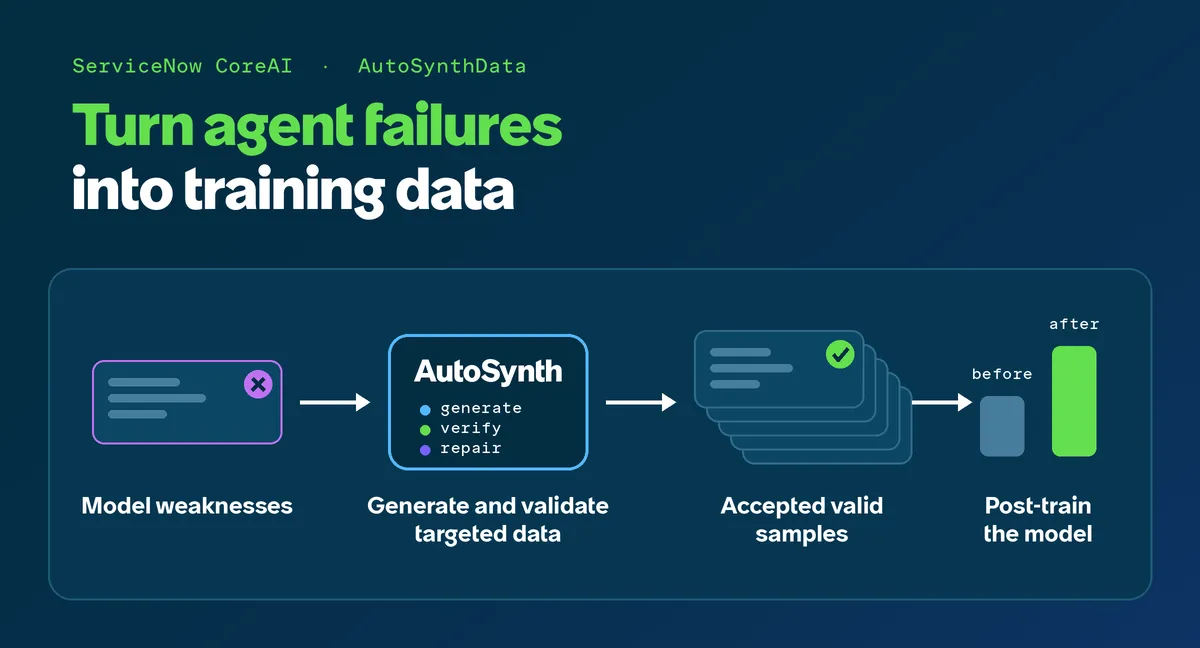
به نقل از مستندات ServiceNow CoreAI، این شرکت در ۲ اکتبر ۲۰۲۶ ابزاری به نام AutoSynthData را معرفی کرد. این سیستم یک خط لوله (Pipeline) است که شکستهای خاص یک مدل را به یک برنامه آموزشی هدفمند تبدیل میکند. برخلاف روشهای سنتی، بهجای جمعآوری دادههای تصادفی، دقیقاً روی شکستهای مدل تمرکز میکند و آنها را به یک برنامه آموزشی هدفمند تبدیل میکند. این رویکرد یادآور متدولوژیهای مشابهی است که در سیستمهای دیگر برای بهینهسازی مدلها به کار میرود، مانند رویکرد چهار مرحلهای Overmind در تبدیل ردپای عاملها به دادههای آموزشی.
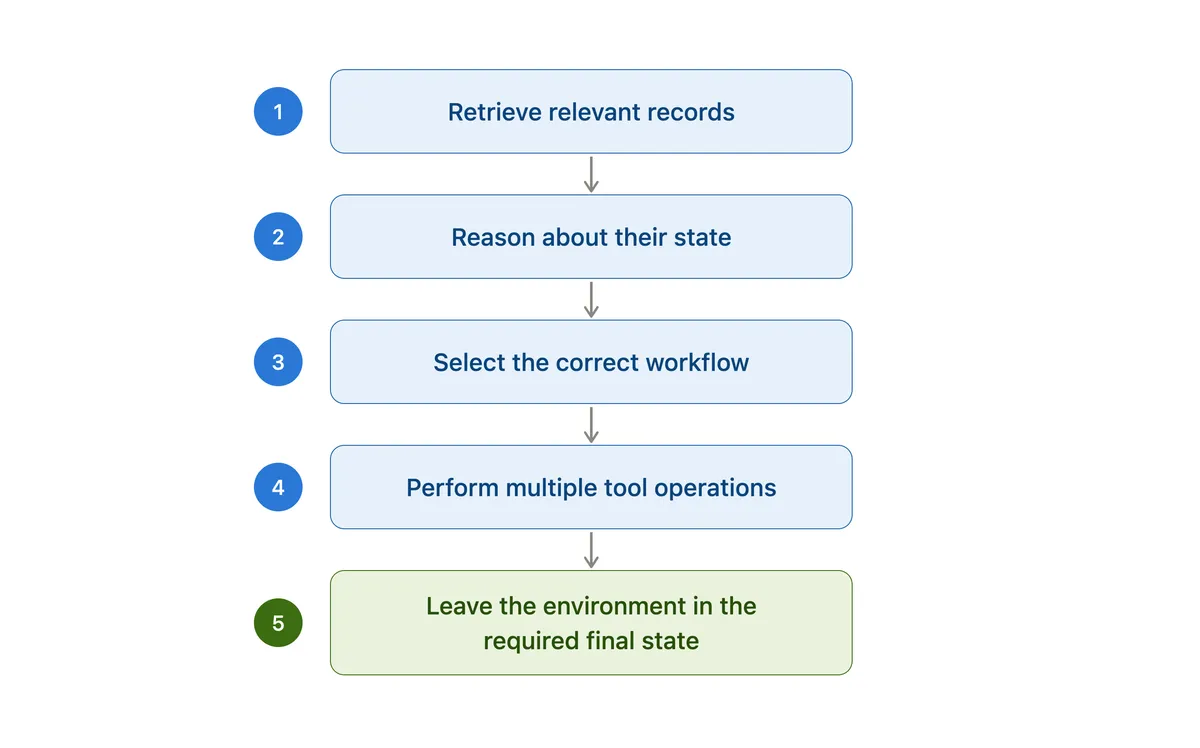
همانطور که در تحلیل قبلی ما دربارهی محدودیتهای حافظه در عاملهای سازمانی اشاره کردیم، چالش واقعی این نیست که مدل صرفاً دادهها را «به یاد بیاورد»، بلکه مسئله تسلط بر گردشکارهای (Workflows) خاص هر کسبوکار است. اکثر شرکتها فاقد مجموعهدادههای عظیم و برچسبگذاریشدهای هستند که برای آموزش مدل در مورد نحوه پیمایش APIهای داخلی منحصربهفرد یا رعایت سیاستهای پیچیده شرکتی مورد نیاز است. دشواری در تبدیل شکستهای فردی به دادههای آموزشی نهفته است؛ در حالی که یک شکست تنها یک سرنخ ارائه میدهد، آموزش نیازمند تکالیف جدید متعددی است که همان توانمندی را در موقعیتهای مختلف به چالش بکشد. این تکالیف باید در محیط قابل اجرا باشند، شبیه به کارهایی باشند که یک انسان واقعاً درخواست میکند و روشی قابل اعتماد برای بررسی موفقیت عامل داشته باشند.
AutoSynthData — شبیه به مربی ورزشی که نقاط ضعف ورزشکار را پیدا میکند و تمرینات سختتری دقیقاً برای همان نقطه طراحی میکند — تولید دادههای مصنوعی را به جستوجو برای یافتن «مرز توانمندی» (Capability Boundary) مدل تبدیل میکند. این سیستم دقیقاً شناسایی میکند که مدل هدف کجا شکست میخورد و سپس از یک مدل قویتر (معلم) میخواهد تا تکالیف جدید و امکانپذیری بسازد که عامل را مجبور به یادگیری آن مهارتهای خاصِ مفقود کند. با بهبود مدل، برنامه آموزشی به سمت مواردی تغییر میکند که مدل هنوز آنها را دشوار مییابد.
کالبدشکافی یک تکالیف مصنوعی
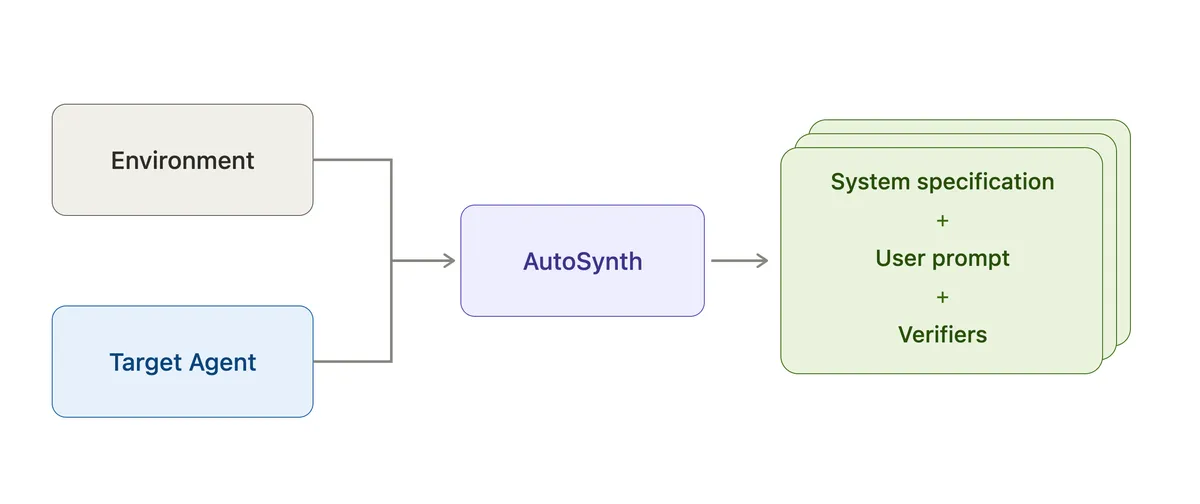
بر اساس گزارش huggingface.co، AutoSynthData هر تکلیف آموزشی را با استفاده از یک انتزاع سه بخشی تعریف میکند: (تکلیف = مشخصات سیستم، پرامپت کاربر، تاییدکننده). یک محیط عاملمحور (Agentic Environment)، دنیایی را تعریف میکند که عامل در آن عمل میکند، شامل وضعیتی که میتواند مشاهده و تغییر دهد، ابزارها و APIهایی که میتواند فراخوانی کند و تغییرات وضعیتی که در اثر اقداماتش ایجاد میشود.
- مشخصات سیستم (System Specification): محدودیتها، سیاستهای محیطی و وضعیت اولیه (مانند یک پایگاه داده مقداردهی شده یا مجموعهای از مقالات دانشی) را تعریف میکند که عامل باید در چارچوب آنها عمل کند. این بخش باید با ابزارها و وضعیت محیط سازگار باشد و از ایجاد محدودیتهای دلخواه که صرفاً برای ساختن دشواری مصنوعی طراحی شدهاند، اجتناب کند.
- پرامپت کاربر (User Prompt): درخواستی واقعگرایانه است که یک کارمند انسانی واقعاً ممکن است مطرح کند. برای اینکه یک پرامپت تولید شده برای آموزش مفید باشد، باید سه ویژگی داشته باشد:
- امکانپذیری (Feasibility): باید حداقل یک مسیر (Trajectory) در محیط وجود داشته باشد که پرامپت را در حالی که مشخصات سیستم را رعایت میکند، برآورده سازد. این ویژگی تکالیفی را که به ابزارهای در دسترس نیست، دانش غیرقابل دسترسی، تغییرات وضعیتی غیرممکن یا اقدامات ممنوعه نیاز دارند، حذف میکند.
- واقعگرایی (Realism): پرامپت باید شبیه به یک درخواست محتمل در محیط هدف باشد، زیرا فضای رفتارهای قابل اجرا اغلب بزرگتر از فضای گردشکارهای واقعگرایانه است.
- دشواری (Difficulty): تکلیف باید نقطه ضعفی از عامل فعلی را آشکار کند. تکالیفی که قبلاً بهطور قابل اعتمادی حل شدهاند، سیگنال آموزشی جدید کمی ارائه میدهند. ناحیه مفید شامل تکالیفی است که امکانپذیر و واقعگرایانه هستند، اما هنوز بهطور مداوم حل نشدهاند.
- تاییدکننده (Verifier): یک گیت منطقی است که موفقیت را بر اساس وضعیت نهایی محیط تعیین میکند. یک تاییدکننده باید دارای ویژگیهای زیر باشد:
- سازگار (Consistent): باید با پرامپت کاربر، مشخصات سیستم و وضعیت محیط مربوط به تکلیف همسو باشد.
- سالم (Sound): باید مسیرهایی را که در برآورده کردن تکلیف شکست میخورند یا محدودیتهای مربوطه را نقض میکنند، رد کند.
- کامل (Complete): باید راهکارهای معتبر را بپذیرد، بهجای اینکه تنها یک مسیر مرجع خاص را کدگذاری کند.
این ویژگیها حیاتی هستند زیرا یک تاییدکننده سهلگیرانه میتواند به رفتار نادرست پاداش دهد، در حالی که یک تاییدکننده بیش از حد سختگیرانه میتواند راهکارهای معتبر را جریمه کند.
از شکست تا برنامه آموزشی
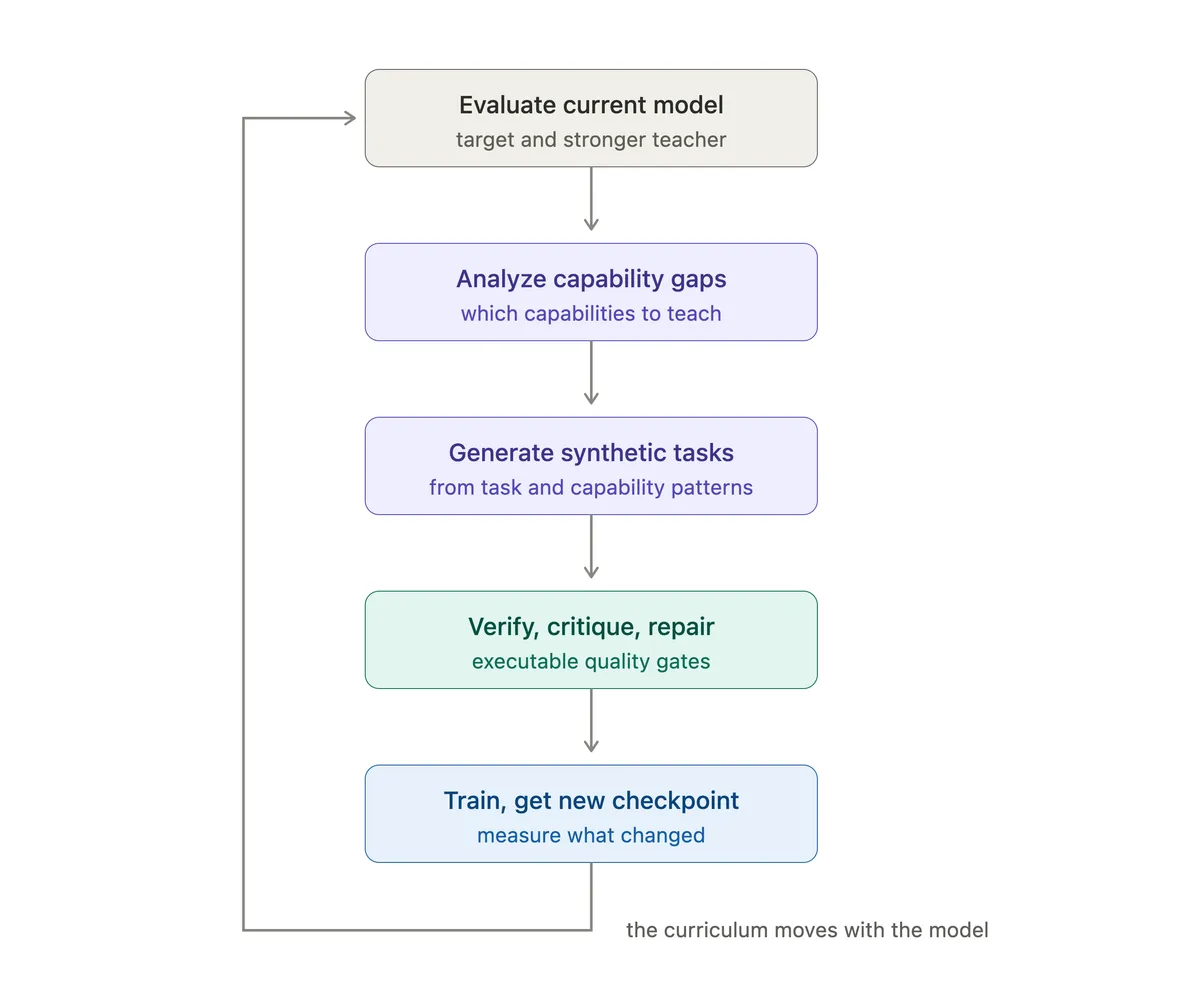
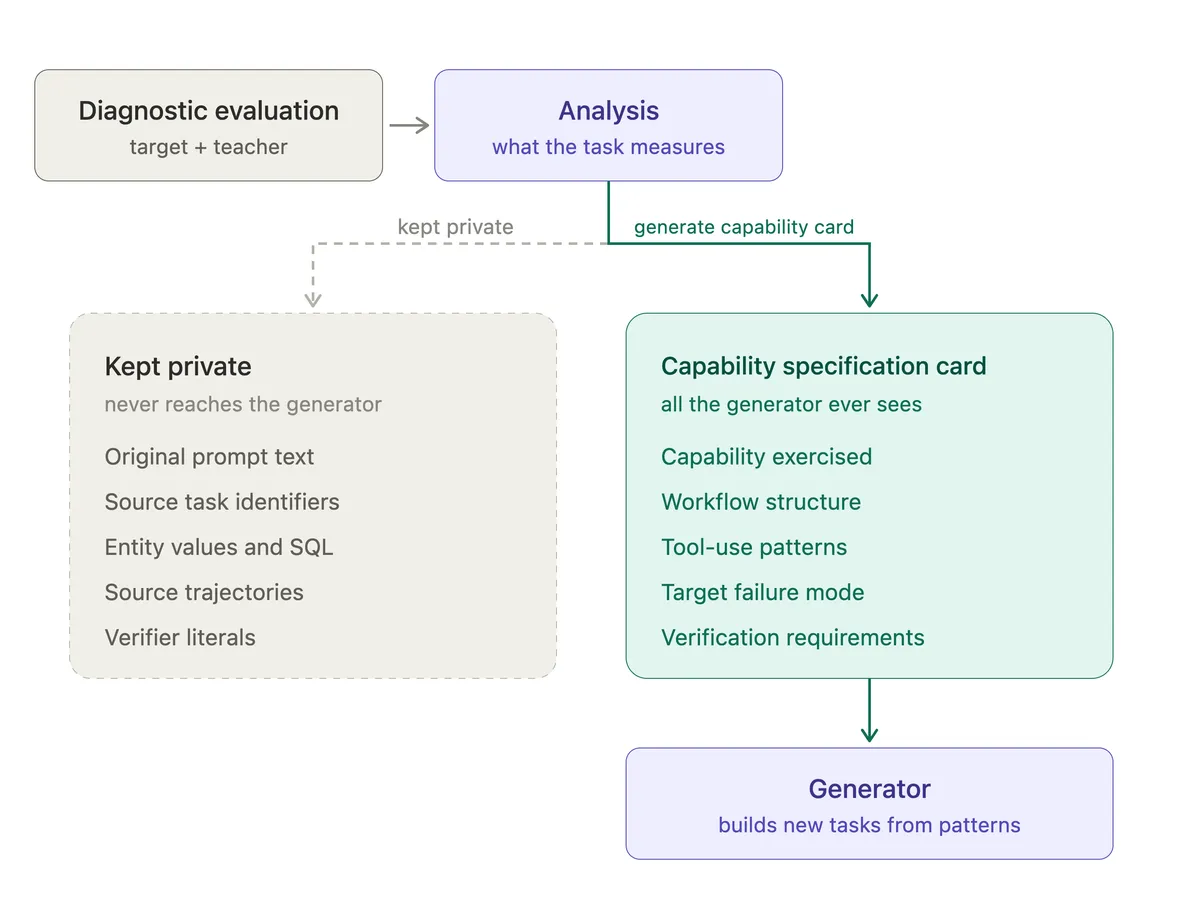
فرآیند با اجرای مدل هدف و یک مدل معلم قویتر روی تکالیف تشخیصی در محیط هدف آغاز میشود. سیستم تحلیل میکند که مدل هدف کجا شکست میخورد و معلم کجا موفق میشود تا «کارتهای مشخصات توانمندی» (Capability Specification Cards) ایجاد کند.
در طول این تحلیل، سیستم موارد زیر را شناسایی میکند:
- توانمندی خاصی که در حال آزمایش است.
- ابزارها و ساختار گردشکار درگیر.
- نقطه دقیق شکست برای مدل هدف در مقابل موفقیت معلم.
- ویژگیهایی که وضعیت نهایی درست باید برآورده کند.
- ابعادی که میتوانند تغییر کنند در حالی که همچنان همان توانمندی را آزمایش میکنند.
این کارتها مانند نقشههای راه عمل میکنند. تولیدکننده دادهها پرامپتها، موجودیتها یا مسیرهای اصلی را دریافت نمیکند. در عوض، از این کارتها برای ایجاد هزاران تکلیف جدید با پرامپتها، وضعیتها و مسیرهای حل متفاوت استفاده میکند تا اطمینان حاصل شود که مدل صرفاً یک پاسخ را حفظ نمیکند، بلکه توانمندی زیربنایی را یاد میگیرد. برای مثال، اگر مدلی با یک گردشکار خاص مشکل دارد، تولیدکننده موجودیتها، وضعیت اولیه محیط، ترکیب گردشکار، ترکیب ابزارها، نحوه بیان و سطح دشواری را تغییر میدهد. سپس مدل معلم قویتر، یک مسیر موفق را برای هر تکلیف نمایش میدهد تا دادههای تنظیم نظارتشده (SFT) فراهم شود.
مقیاس تولید در دو فاز
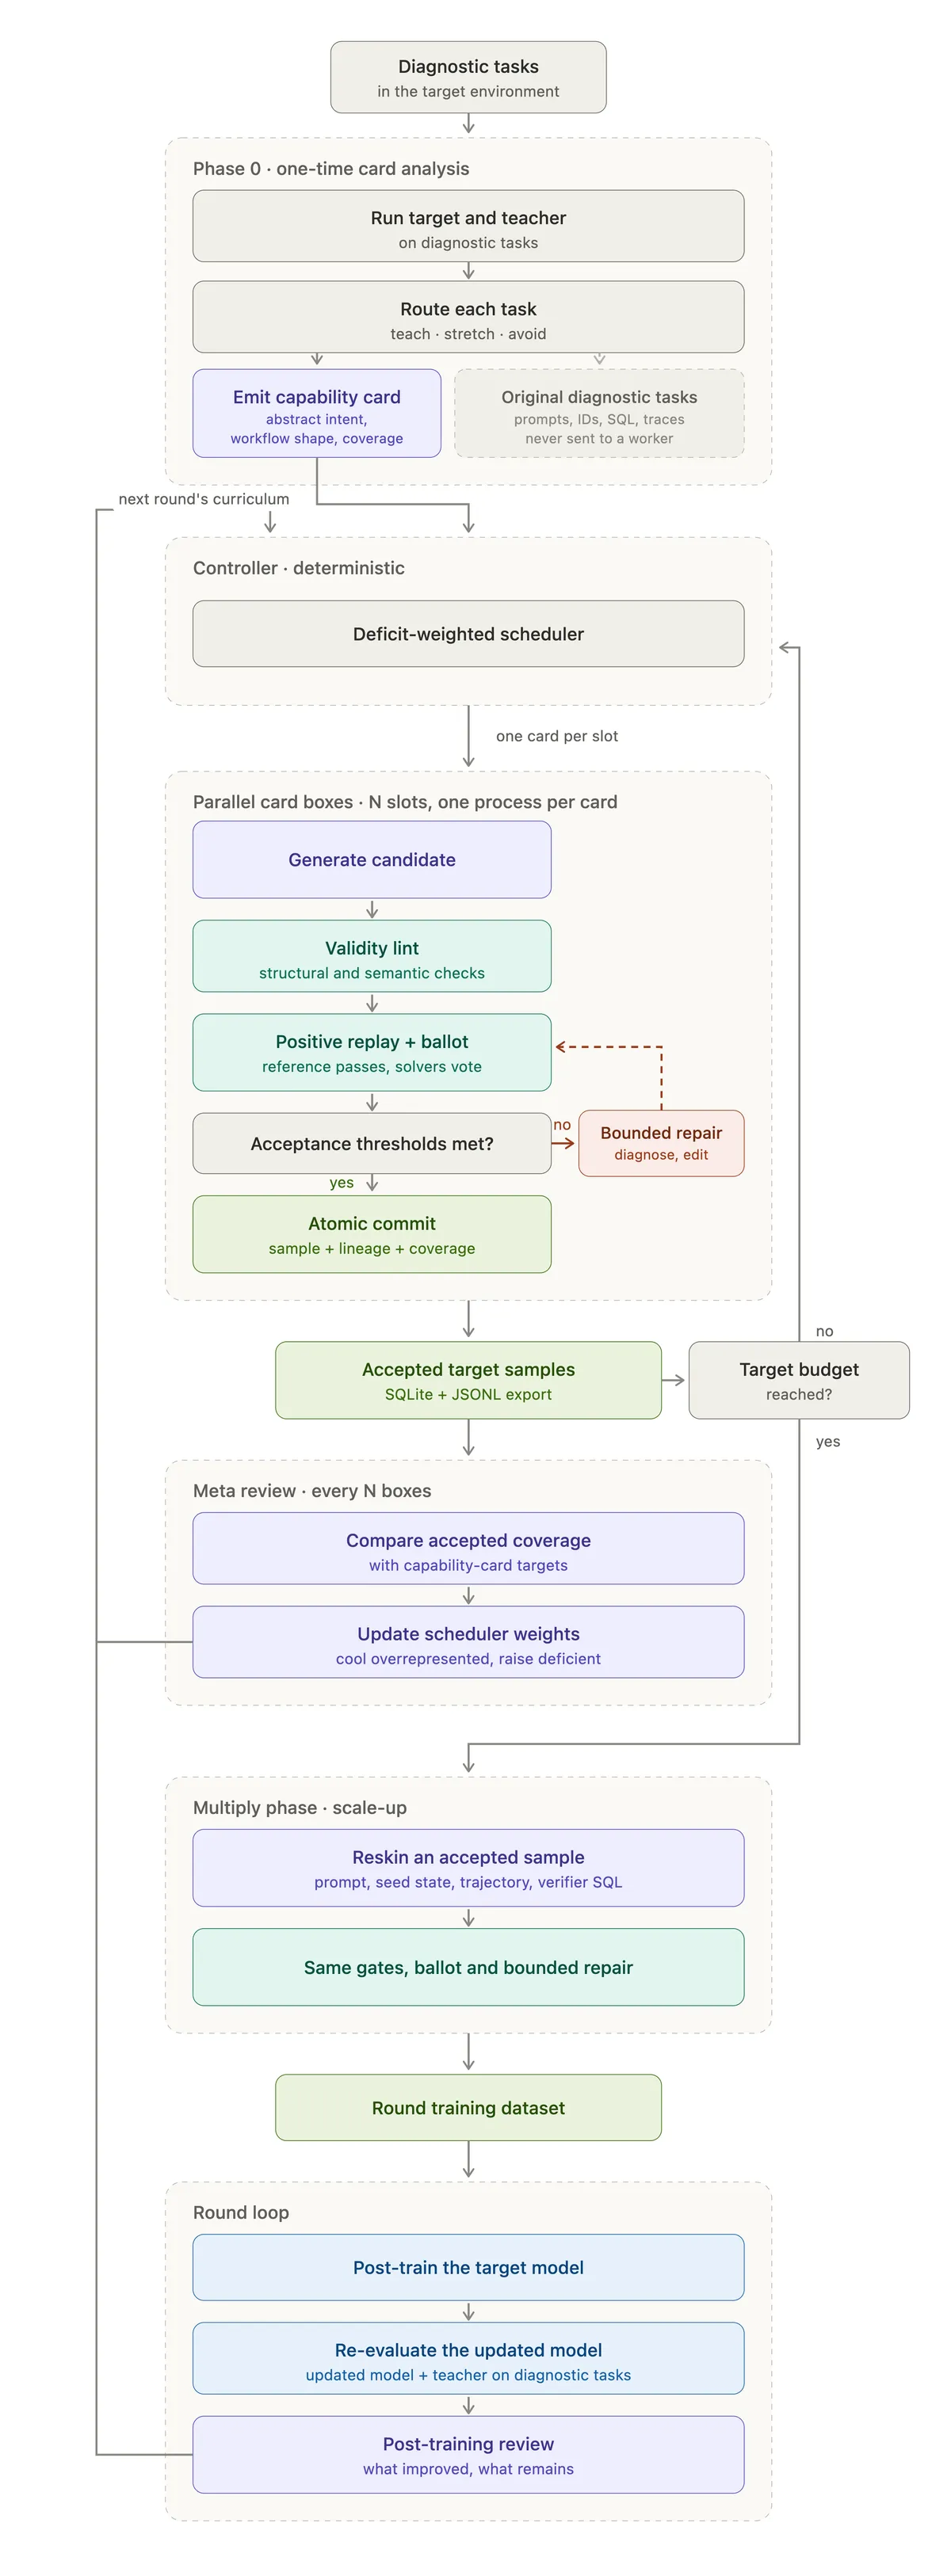
برای رسیدن به حجمهای مورد نیاز برای آموزش، AutoSynthData کنترل تولید را از اجرای خاص محیط جدا کرده است. یک کنترلکننده مشترک، کیفیت و پوشش را هماهنگ میکند، در حالی که یک آداپتور (Adapter) اجرای محیط، مدیریت وضعیت، بازپخش مرجع، تایید قطعی، اجرای حلکننده و پروفایلبندی تکالیف را مدیریت میکند.
AutoSynthData در دو فاز متمایز عمل میکند:
۱. فاز هدف (Target Phase): کارگران (Workers) مجموعهای از نمونههای تاییدشده را بر اساس کارتهای توانمندی بهصورت موازی تولید میکنند. کارگران پس از اتمام هر مورد، هدف جدیدی را برمیدارند. هر کاندیدا پیش از پذیرش، مراحل اعتبارسنجی، اجرا، ارزیابی حلکننده و اصلاح را طی میکند. این کار باعث ایجاد دستهای از مثالهای تاییدشده میشود که حول محور آنچه مدل هدف نیاز به یادگیری دارد، ساخته شدهاند.
۲. فاز تکثیر (Multiply Phase): سیستم با ایجاد گونههای (Variants) جدید از نمونههای پذیرفتهشده در فاز هدف، مجموعه داده را گسترش میدهد. هر گونه دارای درخواست کاربر، وضعیت محیط، پیکربندی موجودیت، مسیر مرجع و تاییدکننده مخصوص به خود است. هر گونه باید همان بررسیهای اعتبارسنجی و اجرا را پاس کند که نمونههای هدف کردند. برای محدود کردن انحراف (Drift) و متصل نگه داشتن گسترش به مجموعه تاییدشده، یک نمونه تکثیر شده نمیتواند بذر (Seed) برای یک نمونه تکثیر شده دیگر باشد.
کنترل کیفیت سختگیرانه
دادههای مصنوعی باکیفیت به چیزی فراتر از یک پرامپت باورپذیر نیاز دارند. یک تکلیف ممکن است در محیط غیرممکن باشد، راه حل مرجع آن ممکن است هنگام اجرا شکست بخورد یا تاییدکننده آن ممکن است به وضعیت نهایی اشتباه پاداش دهد. AutoSynthData از یک حلقه کنترل کیفیت سختگیرانه برای فیلتر کردن دادههای «زباله» استفاده میکند.
تایید و اصلاح در سطح نمونه
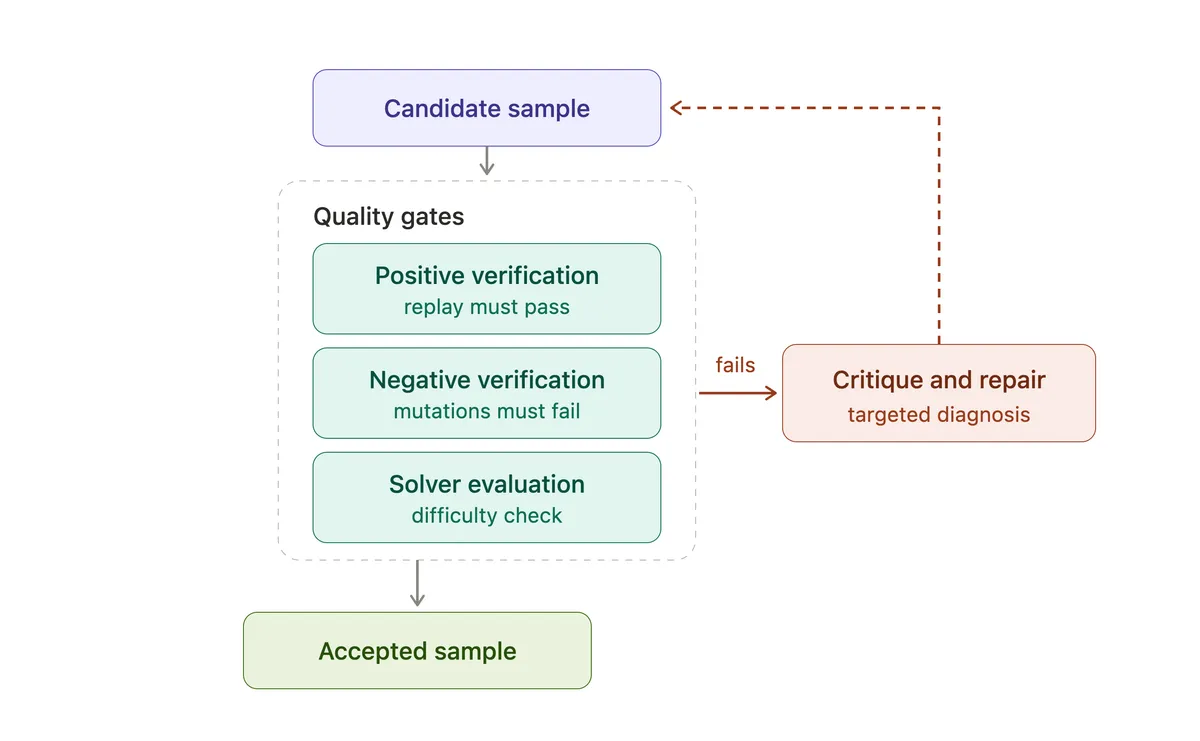
هر کاندیدا باید از یک حلقه کنترل کیفیت عبور کند. سیستم ابتدا از ارزیابی حلکننده برای اندازهگیری دشواری استفاده میکند: تکالیفی ترجیح داده میشوند که مدل هدف در حداکثر یک مورد از سه تلاش حل کند، اما حلکننده قویتر در حداقل دو مورد از سه تلاش موفق شود.
- تایید مثبت (Positive Verification): این گیت میپرسد: «آیا راه حل مورد نظر، تکلیف تولید شده را حل میکند؟» خط لوله مسیر مرجع را در محیط هدف اجرا کرده و وضعیت حاصل را با تاییدکننده چک میکند تا هرگونه عدم تطابق بین پرامپت، وضعیت و معیارهای موفقیت را بیابد.
- تایید منفی (Negative Verification): این گیت میپرسد: «آیا نتایج نادرست مربوطه، رد میشوند؟» سیستم بخشهایی از نتیجه مورد انتظار را تغییر میدهد (Mutate) تا تایید کند که تاییدکننده آنها را رد میکند؛ این کار تاییدکنندههای ضعیفی را که بدون رفتار مورد نظر، موفقیت اعلام میکنند، شناسایی میکند.
اگر کاندیدایی شکست بخورد، برای تشخیص به یک «منتقد» (Critic) فرستاده میشود. منتقد نمونه را برای وضعیتهای ناسازگار، گردشکارهای غیرممکن، ساختار نادرست تکلیف، مسیرهای مرجع بد، منطق ضعیف تاییدکننده یا عدم تطابق با توانمندی مورد نظر بررسی میکند. سپس منتقد یک فرآیند اصلاح هدفمند را هدایت میکند:کاندیدا $
ightarrow$ شکست $
ightarrow$ نقد/تشخیص $
ightarrow$ اصلاح هدفمند $
ightarrow$ اجرای مجدد گیتها $
ightarrow$ پذیرش یا تلاش مجدد.
یک حد ثابت برای تلاشهای مجدد وجود دارد. این اصلاحِ تشخیصمحور کارآمدتر از شروع مجدد تولید از صفر است، زیرا تشخیص، اصلاحات را به سمت کاندیدای موجود هدایت میکند.
بازبینی متا در سطح دسته
فراتر از نمونههای فردی، سیستم یک بازبینی متا (Meta-Review) روی کل دستهها انجام میدهد تا اطمینان حاصل شود که مجموعه داده متوازن و متنوع است. این کار از نمایش بیش از حد چند خانواده تکلیف ساده یا حذف کامل یک توانمندی جلوگیری میکند.
این بازبینی متا، نمونههای پذیرفته شده و رد شده و همچنین رفتار تولید را بررسی میکند تا به این سوالات پاسخ دهد:
- کدام خانوادههای تکلیف بیش از حد نمایش داده شدهاند و کدام ابعاد توانمندی مفقود هستند؟
- آیا انواع مشابهی از مثالها بهطور مکرر ظاهر میشوند؟
- آیا اهداف خاصی بهطور مداوم در تولید شکست میخورند؟
- آیا مشکلات سیستماتیک در نقدها ظاهر میشوند؟
- چه راهنماییهایی باید برای دسته بعدی تغییر کند؟
کنترلکننده، پوشش را در کل مجموعه داده ردیابی میکند. اگر یک توانمندی خاص مفقود باشد یا یک الگوی خاص بیش از حد تکرار شده باشد، سیستم تولید را در آن نواحی کاهش داده و تلاشها را برای پر کردن شکافها تغییر مسیر میدهد. این کار باعث تعادل بین سیگنال یادگیری، کیفیت تکالیف، پوشش و تنوع در محدوده بودجه تولید و الزامات اندازه مجموعه داده میشود.
نتایج واقعی در EnterpriseOps Gym
سرویسنو این رویکرد را با استفاده از بنچمارک EnterpriseOps Gym (مالای و همکاران، ۲۰۲۶) در دو حوزه مختلف آزمایش کرد تا ببیند آیا مدلها در محیطهای سازمانی وضعیتمند (Stateful) بهبود مییابند یا خیر:
- حوزه ترکیبی (Hybrid Domain): با استفاده از Gemma-4-26B-A4B-it به عنوان هدف و Qwen3.8-27B به عنوان معلم، سیستم حدود ۲,۰۰۰ نمونه آموزشی مصنوعی را در حدود ۱۸ ساعت تولید کرد. تنظیم دقیق (Fine-tuning) روی این مجموعه داده (بهترین چکپوینت در اپوک ۵) منجر به افزایش ۷.۲ واحد درصدی در میانگین Pass@1 شد که یک بهبود نسبی ۳۵٪ است. موفقیت تاییدکننده از ۶۳.۰۱٪ به ۶۸.۵۵٪ افزایش یافت و ۵۹٪ از شکاف اصلی Pass@1 بین Gemma و مدل مرجع را پر کرد. تولیدکننده تکالیف ارزیابی اصلی را دریافت نکرده بود، که ثابت میکند مدل توانمندی را یاد گرفته است، نه مثالهای خاص را.
- حوزه ITSM: با استفاده از Gemma-4-26B-A4B-it به عنوان هدف و DeepSeek-V4.1-Flash به عنوان معلم، سیستم ۱,۹۹۴ نمونه را در ۶۶ ساعت تولید کرد. مدت زمان طولانیتر به دلیل مدل معلم بزرگتر و نبود بهینهسازیهای خط لولهای بود که در اجرای Hybrid وجود داشت. در ITSM، تنظیم SFT مصنوعی میانگین Pass@1 را از ۱۸.۷۷٪ به ۲۷.۱۸٪ افزایش داد.
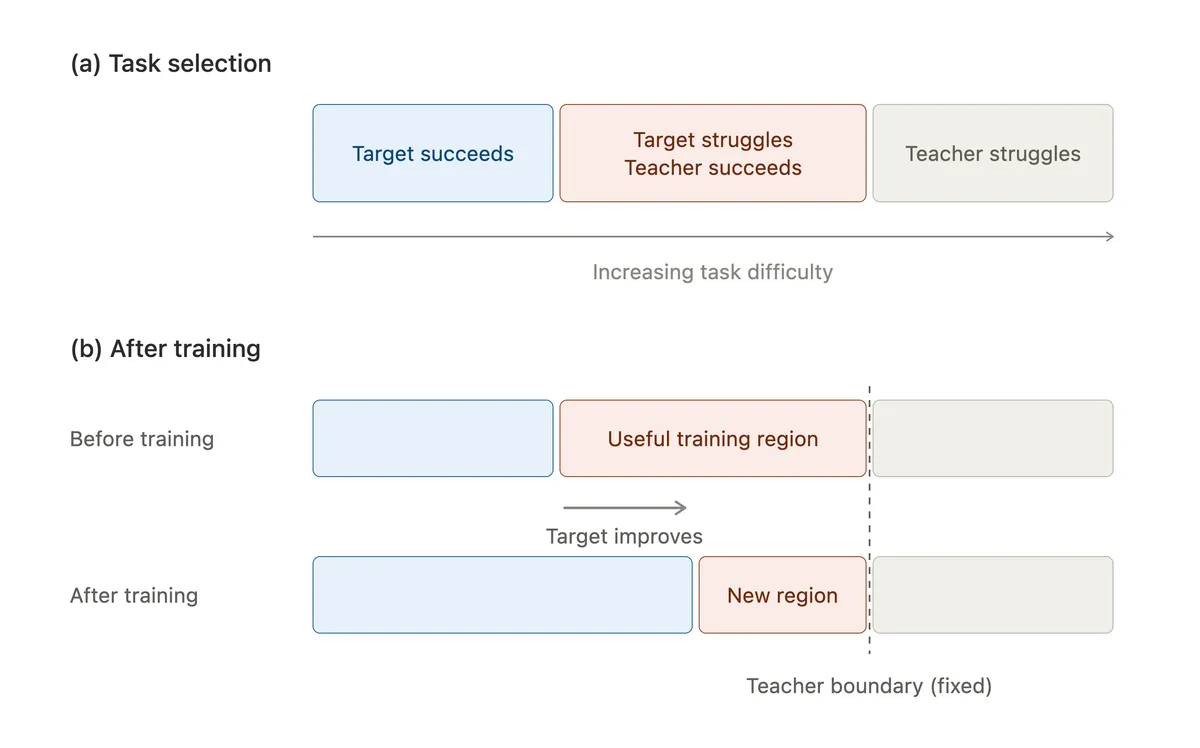
این نتایج نشان میدهد که خط لوله میتواند شکاف بین یک مدل پایه و یک مدل مرجع را تنها با تمرکز انحصاری بر «مرز دشواری» پر کند.
این تغییر در متدولوژی نشان میدهد که آینده هوش مصنوعی سازمانی، مدلهای پایه بزرگتر نیست، بلکه کارخانههای داده خودکار و آگاه از محیط است. با تبدیل شکستها به یک برنامه آموزشی، شرکتها میتوانند مدلها را برای نیازهای عملیاتی خاص خود تنظیم کنند بدون اینکه به هزاران مثال برچسبگذاری شده توسط انسان نیاز داشته باشند.
برای کسانی که در حال استقرار عاملها هستند، گام بعدی عبور از تنظیم نظارتشده (SFT) است. همان مکانیزم تولید تکالیفی که سیاست فعلی را به چالش میکشد، میتواند از یادگیری تقویتی (RL) پشتیبانی کند و مرز کالیبره شده دشواری را همزمان با بهروزرسانی سیاست جابهجا کند. سرویسنو قصد دارد این مرز متحرک را فراتر از SFT آزمایش کند.



گفتگو