
تصور کنید برنامهای مینویسید اما صفحهکلید شما اجازه پاک کردن یا تغییر کلمات قبلی را نمیدهد و هر توکن پس از تایپ، ابدی است. این جریان صلب، تعریف دقیق تولید متن در مدلهای خودبازگشتی (Autoregressive) است، اما مدلهایی مانند LLaDA در حال به چالش کشیدن این محدودیت هستند.
به نقل از تحلیل فنی منتشر شده در ۲۴ سپتامبر ۲۰۲۶ توسط The Sequence، اکثر مدلهای زبانی بزرگ فعلی با پیشبینی توکن بعدی در یک توالی خطی عمل میکنند. اگر مدل در ابتدای جمله مرتکب خطایی شود، نمیتواند آن را بهطور نامحسوس بازنویسی کند؛ بلکه مجبور است یا خطا را ادامه دهد یا در ادامه متن، اصلاحی آشکار ارائه دهد. این وابستگی خطی، یک گلوگاه محاسباتی در زمان استنتاج (Inference) ایجاد میکند؛ موضوعی که پیشتر در تحلیل ما پیرامون موانع سرعت در معماریهای فعلی هوش مصنوعی به تفصیل بررسی شده بود.
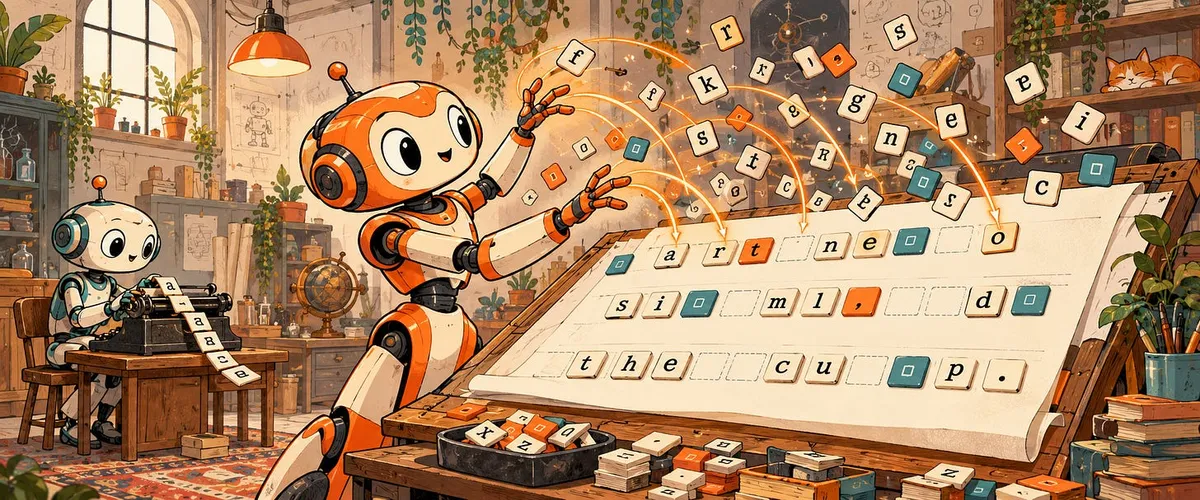
مدلهای انتشار متن (Text Diffusion) این رویکرد را تغییر میدهند. این مدلها با یک توالی ناقص یا مخدوش شروع کرده و از طریق فرآیندهای مکرر «نویززدایی»، متن را پالایش میکنند. بر اساس مستندات فنی، تفاوتهای کلیدی این معماری عبارتند از:
- موازیسازی: امکان تبدیل چندین موقعیت در یک توالی به کلمات در یک گام واحد.
- انعطافپذیری: مدل میتواند بخشهای مختلف پاسخ را بهصورت تکرارشونده ویرایش و بازنویسی کند، بهجای آنکه صرفاً به انتهای متن چیزی اضافه کند.
- معماری: انتشار یک روش تولید است، نه جایگزینی برای معماری ترنسفورمر (Transformer)؛ مدلهایی مثل LLaDA همچنان از ترنسفورمرها بهعنوان موتور محاسباتی استفاده میکنند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی توان عملیاتی مدلها اشاره کردیم، چالش اصلی اکنون از بهینهسازی جریان متوالی به تضمین انسجام تصمیمات موازی تغییر یافته است. هدف این است که سرعت تولید افزایش یابد، بدون آنکه این سرعت در محاسبات اضافی برای هماهنگسازی توکنهای موازی تلف شود. در همین راستا، تلاش برای کاهش هزینههای عملیاتی منجر به ظهور مدلهایی شده که هزینه استنتاج در بنچمارکهای پیچیده مانند ARC-AGI را به شدت کاهش دادهاند.
با بلوغ این مدلها، صنعت احتمالاً به سمت سامانههای ترکیبی حرکت میکند که پایداری مدلهای خودبازگشتی را با انعطافپذیری ویرایشی مدلهای انتشار ادغام میکنند. توسعهدهندگان باید قوانین مقیاسپذیری (Scaling Laws) ترنسفورمرهای غیرخودبازگشتی را رصد کنند تا مشخص شود آیا اینها واقعاً میتوانند جایگزین پارادایم پیشبینی توکن بعدی شوند یا خیر.
گام بعدی شما
- بررسی مقالات فنی مدل LLaDA برای درک تفاوت نرخ خطای مدلهای انتشار در برابر مدلهای خطی.
- آزمایش ابزارهای ویرایش متن مبتنی بر Diffusion برای ارزیابی کیفیت بازنویسی در مقایسه با Prompting سنتی.
- رصد بنچمارکهای سرعت استنتاج در مدلهای غیرخودبازگشتی برای تخمین کاهش هزینههای GPU.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو