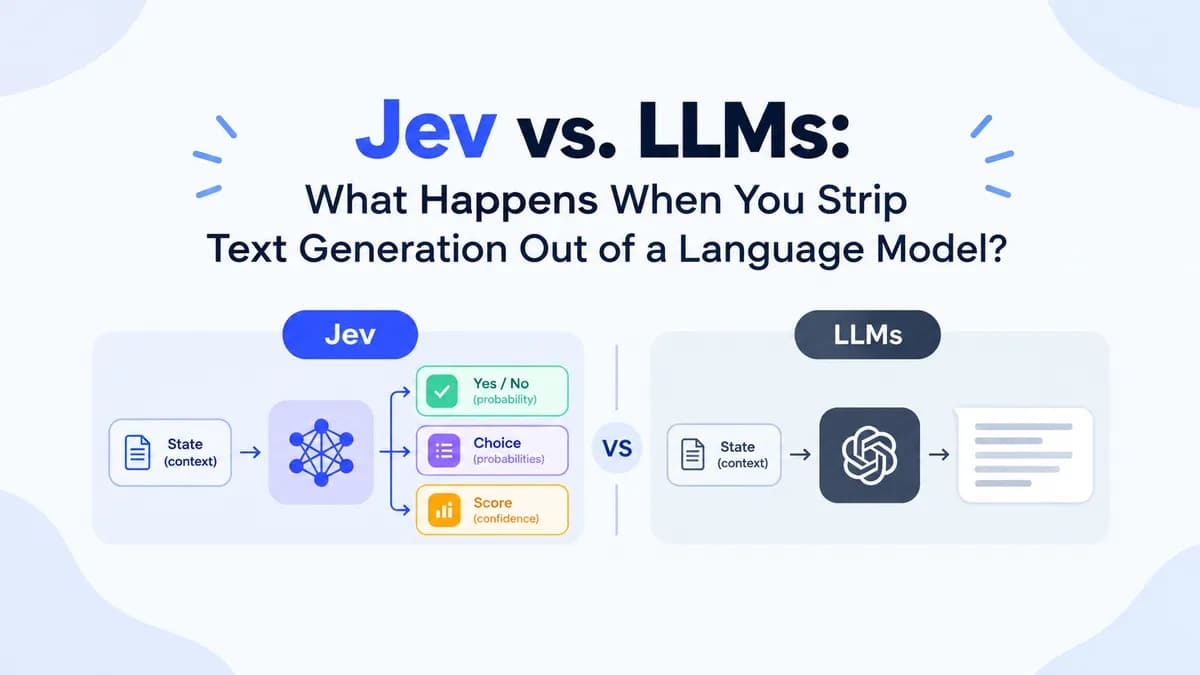
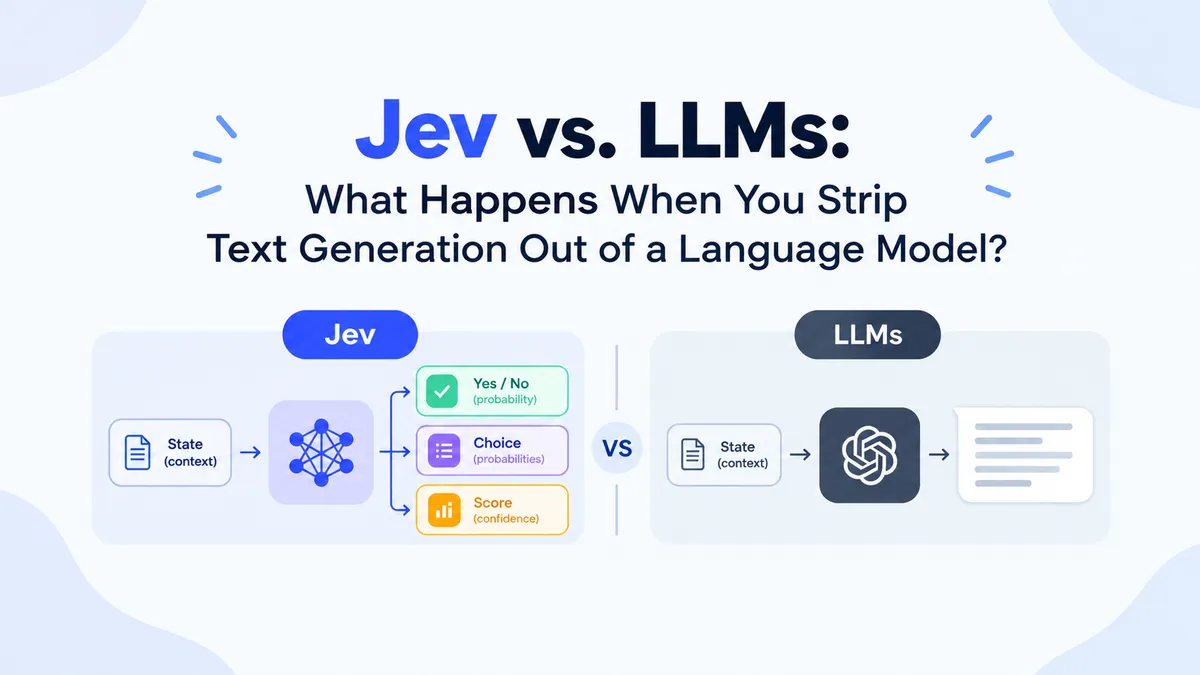
اگر امروز برای هر تصمیم ساده در زنجیرهٔ عاملهای خود از مدلهای زبانی گرانقیمت استفاده میکنید، احتمالاً بخش بزرگی از بودجه و زمان خود را هدر میدهید. مدل Jev با ثبت رکورد ۷۰ میلیثانیه در تأخیر تصمیمگیری، نشان داد که برای بسیاری از وظایف، تولید متن یک سربار غیرضروری است. این دستاورد در ادامه گزارش نخستین عرضه مدل Jev صورت گرفت که برای اولین بار سرعت خیرهکننده این معماری را به نمایش گذاشت. در واقع، یک گذر پیشرو (Forward Pass) واحد جایگزین تولید کند و توکنبهتوکن مدلهای زبانی سنتی شده است.
در ۱۵ سپتامبر ۲۰۲۶، شرکت TypeSafe AI نخستین مدل عمومی خود به نام Jev را منتشر کرد. هدف این مدل مدیریت لایههای تصمیمگیری با حجم بالا در عاملهای هوش مصنوعی است، بدون آنکه نیازی به تولید جملات و نثر باشد. این عرضه چنان موجی از کنجکاوی ایجاد کرد که نام Jev بهسرعت و بدون هیچ زمینهای در محافل هوش مصنوعی، توییتر (X) و Hacker News پیچید.
همانطور که در تحلیل قبلی ما دربارهی پتانسیل Jev برای کاهش هزینهها تا ۴۴۴ برابر اشاره کردیم، این ابزار تغییری بنیادین در نحوهٔ مدیریت دادههای ساختاریافته ایجاد میکند. در حال حاضر، اکثر عاملهای هوش مصنوعی فراخوانهای گرانقیمت مدلهای پیشرو را برای کارهای سادهای مثل مسیریابی (Routing) یا امتیازدهی به فوریت (Urgency Scoring) میسوزانند. تصور کنید برای کاری که یک عبارت منظم (Regular Expression) ساده برای آن کافی است، از یک پارسر کامل و عظیم استفاده کنید؛ این دقیقاً همان ناکارآمدی است که Jev قصد حل آن را دارد. دیوگو آلمیدا (Diogo Almeida)، بنیانگذار TypeSafe، در یک جمله کوتاه Jev را اینگونه توصیف میکند: «یک فراخوانی تابع با هوش پیشرو: وضعیت بدون ساختار وارد میشود و تصمیمات احتمالیِ تایپشده خارج میشوند.»
معماری تفکر «سیستم ۱»
آلمیدا که پیشتر پژوهشگر OpenAI بود و روی متدهای RLHF (یادگیری تقویتی از بازخورد انسانی) در پشتصحنه ChatGPT کار کرده است، Jev را یک مدل «سیستم ۱» مینامد. این اصطلاح از چارچوب تفکر سریع و کند دانیل کانمن وام گرفته شده است. در حالی که مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در حالت «سیستم ۲» بهصورت متوالی، متفکرانه و تعمقی استدلال میکنند، Jev بر تطبیق سریع و شهودی الگوها تمرکز دارد که در قالب خروجیهای ساختاریافته و قابل فراخوانی توسط نرمافزار بستهبندی شده است.
برخلاف مدلهای خودبازگشتی (Autoregressive) که توکنها را یکییکی تولید میکنند — جایی که هر توکن بر اساس تمام توکنهای قبلی شرطی میشود — Jev از یک معماری غیرخودبازگشتی با یک نمونهگیر موازی (Parallel Sampler) استفاده میکند. این معماری به مدل اجازه میدهد تا تمام خروجیهای درخواستی را بهطور همزمان و تنها در یک گذر (Pass) تولید کند، فارغ از اینکه چند سؤال درباره یک وضعیت واحد بپرسید.
به نقل از TypeSafe AI، این تغییر معماری باعث شده زمان پاسخدهی به بازه ۷۰ تا ۵۰۰ میلیثانیه برسد. در مقابل، مدلهای پیشرو برای انجام کارهای مشابه ممکن است بین ۳ تا ۳۲۹ ثانیه زمان ببرند. گمانهزنیهای مستقل پیشنهاد میکند که Jev احتمالاً یک رمزگذار دوطرفه (Bidirectional Encoder) بزرگ است که بر اساس طرحواره (Schema) شرطی شده و دارای سرهای پرسوجوی موازی برای برچسبگذاری است و مقیاس آن بسیار فراتر از طبقهبندیهای معمولی است. با این حال، از آنجا که TypeSafe هنوز وزنهای مدل یا مقاله رسمی منتشر نکرده است، این تحلیلها صرفاً حدسهای informed بر اساس رفتار عمومی مدل هستند.
API جدید برای تصمیمات احتمالی
مدل Jev بهجای نقطه انتهایی (Endpoint) متداولِ تکمیل چت (Chat Completions)، از یک API «وضعیت و پرسش» استفاده میکند. در اینجا بهجای یک گفتگو، API یک «وضعیت» (که همان زمینه یا Context است) و یک دیکشنری از «سؤالات» را دریافت میکند.
انواع خروجیهای پشتیبانیشده عبارتند از:
- noul: یک احتمال بله/خیر که نشان میدهد یک گزاره تا چه حد درست است.
- choice: درخواستی برای انتخاب از میان یک مجموعه ثابت از گزینهها، که احتمالات مربوط به هر گزینه را به همراه یک امتیاز اطمینان کلی برمیگرداند.
- confidence: درخواستی برای رتبهبندی بر اساس سطوح مرتبشده (مثلاً کم/متوسط/زیاد)، که یک امتیاز پیوسته و میزان اطمینان را برمیگرداند.
برای مثال، یک درخواست حداقلی ممکن است وضعیتی را ارسال کند که توصیفکننده یک حساب Stripe خراب است و یک سؤال «noul» بپرسد که آیا این پیام فوریت دارد یا خیر. پاسخ یک شیء JSON تمیز خواهد بود: {"is_urgent": {"type": "noul", "noul": 0.999}}. این دقیقاً همان چیزی است که یک برنامهنویس برای ایجاد شاخههای شرطی (Branching) در کد اپلیکیشن نیاز دارد.
از آنجا که نمونهگیری موازی است، افزودن سؤالات بیشتر به یک درخواست واحد، تأخیر را تقریباً افزایش نمیدهد. این موضوع یک مدل هزینه ایجاد میکند که بهطور بنیادین با LLMها متفاوت است؛ در LLMها هر توکن اضافی تولید شده، زمان و هزینه متناسبی را اضافه میکند، اما در Jev اینگونه نیست.
آموزش برای صداقت معرفتی
شرکت TypeSafe AI بهجای متدهای رایج RLHF یا RLVR (بهینهسازی برای پاداشهای قابل تأیید برنامهنویسی مثل ریاضی یا کد)، از روش RLCD (یادگیری تقویتی برای تصمیمات کالیبرهشده - Reinforcement Learning for Calibrated Decisions) استفاده کرده است. در حالی که RLHF روی آنچه انسانها ترجیح میدهند بخوانند بهینه میشود، RLCD بهطور خاص برای تخمین احتمالات صادقانه از نظر معرفتی (Epistemically Honest) در وظایف با شکلِ طبقهبندی بهینه شده است.
این کالیبراسیون (Calibration) — یعنی تطبیق احتمال پیشبینی شده با نرخ واقعی وقوع — برای اتوماسیون حیاتی است. مدلهای زبانی بهطور بدنامی در بیان عدم قطعیت کالیبرهشده ضعیف هستند، حتی زمانی که صراحتاً از آنها خواسته شود. مدلی که ۹۵٪ مواقع درست میگوید اما نمیتواند سیگنال دهد که در آن ۵٪ باقیمانده در حال خطا است، برای عاملهای عملیاتی در محیط تولید (Production) خطرناک است. ادعای TypeSafe این است که احتمالات Jev بهطور معناداری کالیبره شدهاند، که این ادعایی قویتر و قابل ابطالتر از اعتماد ساده به یک خروجی درصدی از یک LLM استاندارد است.
تضمین «صفر بودن توهم»
طبق اعلام TypeSafe AI، مدل Jev نمیتواند دچار توهم (Hallucination) شود و هرگز خطای تایپی (Type Error) نمیدهد. این ادعا صرفاً بازاریابی نیست، بلکه مستقیماً از طراحی مدل میآید. چون فضای خروجیهای معتبر از پیش توسط طرحواره (Schema) سؤال کاربر تعریف شده است، هیچ راهی وجود ندارد که مدل چیزی خارج از آن طرحواره منتشر کند. این رویکرد ساختاری برای حذف توهمات، یادآور تلاشهای مدلهای LLM-JEPA در شبیهسازی واقعیت است که با هدف کاهش خطاهای مدلهای زبانی بزرگ توسعه یافتند.
این وضعیت شبیه به یک تابع با تایپ مشخص (Well-typed function) در مهندسی نرمافزار است؛ تابع بهطور لغوی نمیتواند مقداری خارج از نوع بازگشتی تعریفشده برگرداند. این یک تضمین از نوع کاملاً متفاوت است زیرا هیچ مرحله «تولیدی» وجود ندارد که در آن یک توکن خارج از طرحواره نمونهگیری شود. اگرچه TypeSafe از دادههای تجمیعی OpenRouter برای نشان دادن نرخ توهم LLMها استفاده میکند، اما اعتراف میکند که این کار باعث ایجاد سوگیری (Bias) میشود. نرخ توهم «واقعاً صفر» آنها نتیجه معماری است، نه یک تست تجربی.
ارزیابی بنچمارکها
کاربران باید در برابر ادعاهای خیرهکننده — تا ۱۹۳.۶ برابر سریعتر و ۴۴۴.۶ برابر ارزانتر — محتاط باشند. این اعداد از یک متدولوژی سفارشی به نام «ارزیابی گردشکار» (Workflow Eval) بهدست آمدهاند که توسط خود TypeSafe AI طراحی شده است.
جزئیات کلیدی مربوط به این بنچمارکها عبارتند از:
- پایههای LLM: مدلهای پیشرو در یک آداپتور مخصوص System One متعلق به TypeSafe قرار گرفتند تا مجبور به ارائه خروجی ساختاریافته شوند.
- داده مرجع (Ground Truth): پاسخ «درست» بر اساس میانگین خروجی دو مدل پیشرو دیگر تعیین شد، نه بر اساس برچسبهای خارجی یا انسانی.
- شفافیت: شرکت صراحتاً در یادداشتهای تکمیلی خود ذکر کرده است که این یک بنچمارک مستقل و شخص ثالث نیست.
ارزش آن را دارد به یاد داشته باشیم که این یک محصول API بسته است که تنها دو هفته است عرضه شده و توسط شرکتی ارائه شده که بهتازگی ۴۰ میلیون دلار سرمایه اولیه (Seed Round) جذب کرده است، نه یک نتیجه پژوهشی داوریشده (Peer-reviewed).
جایگاه Jev در پشتهٔ عاملها
مدل Jev جایگزین چتباتها نیست، بلکه یک لایه تصمیمگیر است. همانطور که در گزارش LangChain ذکر شده، این مدل بهعنوان یک لایه بسیار ارزانتر و سریعتر در حلقهٔ عامل عمل میکند تا از مصرف بیرویه فراخوانهای کامل LLM برای کارهایی که نیاز به تولید متن ندارند، جلوگیری کند.
این مدل بهعنوان یک میانافزار (Middleware) برای چندین وظیفه با فرکانس بالا در حلقه عامل جای میگیرد:
- مسیریابی مدل (Model Routing): طبقهبندی اینکه آیا یک درخواست نیاز به مدل ارزان دارد یا مدل پیشرو، بدون اینکه برای گرفتن این تصمیم، یک فراخوان مدل پیشرو هزینه شود.
- گیتینگ ریسک ابزار (Tool-Risk Gating): شناسایی و علامتگذاری فراخوانهای خطرناک ابزارها (مثل دستورات bash یا
rm) قبل از اجرا. این دقیقاً مشابه الگوهایی است که در محیطهای بسته مثل Claude Code و Cursor استفاده میشود. - تریاژ در مقیاس بالا (Triage at Scale): امتیازدهی به فوریت یا مسیریابی هزاران تیکت پشتیبانی در دقیقه از طریق عملیات map-reduce روی مجموعهدادههای بزرگ بدون ساختار.
- حلقههای آنی (Real-time Loops): شرکت TypeSafe نمایش داد که Jev میتواند بازی Doom را با نرخ ۱۰ هرتز بر اساس وضعیت ساختاریافته بازی اجرا کند، در حالی که هزینه آن تقریباً ۷ دلار در ساعت است.
برای توسعهدهندگان، ادغام langchain-typesafe اجازه میدهد این قابلیت از طریق یک فراخوان TypeSafeClassifier پیاده شود. با ارسال یک وضعیت و دستور Noul ، توسعهدهنده احتمالی را دریافت میکند که میتواند برای ایجاد شاخهبندی فوری در کد برنامه استفاده شود.
Jev چه چیزی نیست؟
بسیار مهم است که مرزهای این فناوری را مشخص کنیم. «مدل سیستم ۱» نامی است که TypeSafe برای محصولش ابداع کرده است و هنوز به یک اصطلاح استاندارد علمی تبدیل نشده است.
بهطور مشخص، Jev نمیتواند:
- کد، نثر یا پاسخهای چت بنویسد (چون هیچ مرحله تولید متنی وجود ندارد).
- وزنهای باز یا مقاله منتشر شده ارائه دهد (مدل بسته است و فقط از طریق API در دسترس است).
- استدلالهای باز، برنامهریزی چندمرحلهای یا کارهایی که از تفکر توکنبهتوکن سود میبرند را انجام دهد.
این تحول نشان میدهد که آینده معماری هوش مصنوعی فقط مدلهای بزرگتر نیست، بلکه یک پشته لایهبندیشده (Tiered Stack) است. تقابل Jev و LLM یک رقابت نیست؛ بلکه بیشتر شبیه پرسیدن این است که «آیا از Regex استفاده کنیم یا یک پارسر کامل؟». با سپردن طبقهبندی به لایه سیستم ۱، توسعهدهندگان میتوانند استدلالهای گرانقیمت سیستم ۲ را برای کارهایی ذخیره کنند که واقعاً به آن نیاز دارند. اگر سهم وظایف طبقهبندی در محیطهای عملیاتی به اندازه ادعای پذیرندگان اولیه مثل Browserbase زیاد باشد، مدلهای سیستم ۱ به یک لایه پذیرفتنی و جدید در پشته عاملها تبدیل خواهند شد که در کنار LLM قرار میگیرند، نه اینکه جایگزین آن شوند.
گام بعدی شما
- اگر از LangChain استفاده میکنید، کتابخانه
langchain-typesafeرا برای جایگزینی لایههای مسیریابی (Router) بررسی کنید. - در طراحی عاملهای خود، وظایف را به «تصمیمات احتمالی» و «تولید متن» تفکیک کنید تا هزینه استنتاج را کاهش دهید.
- برای کارهای حساس، از خروجیهای
confidenceمدل برای ایجاد سیستمهای تایید انسانی (Human-in-the-loop) استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو