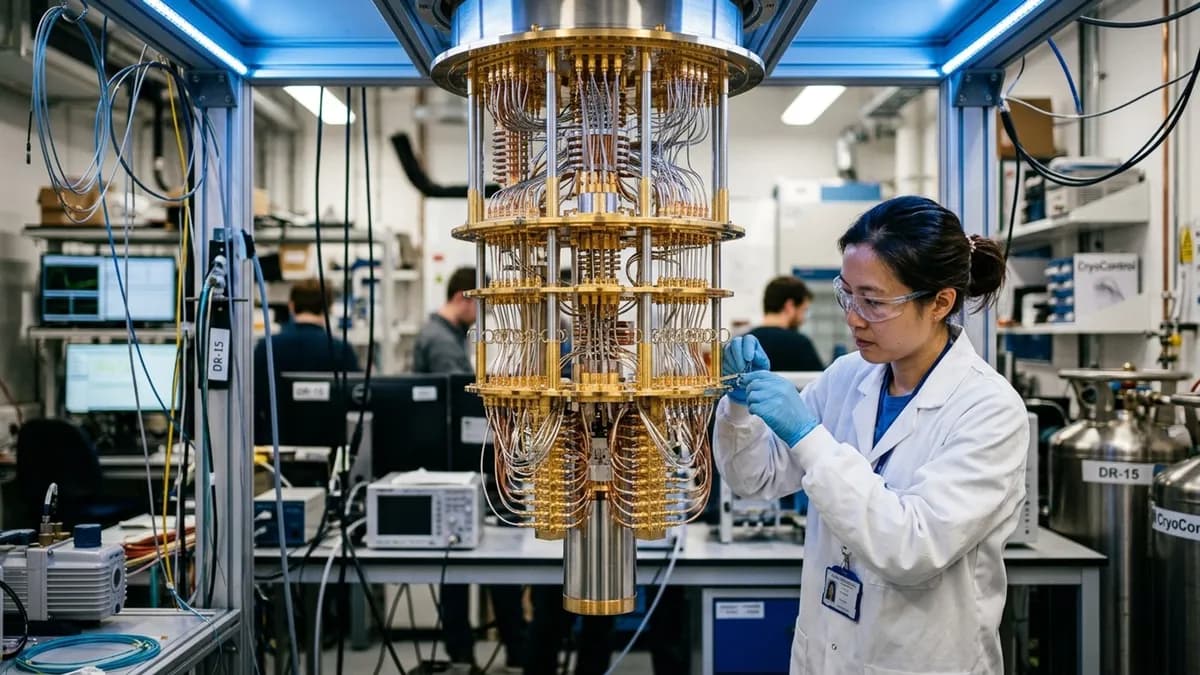
تصور کنید با مسائلی محاسباتی روبرو هستید که فارغ از اینکه مدل زبانی شما چقدر بزرگ شود، هرگز قابل حل نیستند، اما یک سیستم کوانتومی کوچک میتواند آنها را به راحتی رمزگشایی کند. این واقعیت اکنون توسط تیمی در IBM Research به صورت ریاضی ثابت شده است؛ آنها نشان دادند که مدارهای کوانتومی کمعمق در دو نوع وظیفهٔ خاص، برتری نظری مطلق نسبت به مدلهای زبانی بزرگ دارند.
این یافتهها در ۱۵ سپتامبر ۲۰۲۶ منتشر شد و درست در زمانی میرسد که صنعت در تلاش است با گسترش پنجرههای متنی و پیچیدهتر کردن استدلال، محدودیتهای هوش مصنوعی کلاسیک را جابهجا کند. همانطور که در تحلیلهای پیشین ما دربارهی محدودیتهای سختافزاری مدلهای محلی اشاره کردیم، تمرکز اکنون از «مقیاس» به «محدودیتهای بنیادین ریاضی» معماری ترنسفورمر (Transformer) تغییر یافته است.
برای درک ابعاد این موضوع، وظیفهای را تصور کنید که نیاز به دنبال کردن زنجیرهای از ارجاعات در هزاران کتاب مختلف دارد. برای یک ترنسفورمر کلاسیک، این یک کابوس مصرف منابع است، اما برای یک مدار کوانتومی، عملیاتی کاملاً مدیریتپذیر محسوب میشود. این شکاف، یک مرز سخت در پیچیدگی محاسباتی است.
زمینهای از سال ۲۰۱۸
یافتههای فعلی اتفاقی نیستند و دنبالهرو خط پژوهشی خاصی روی مدارهای کوانتومی کمعمق هستند. در این مدارها، عمق مدار ثابت میماند، حتی اگر تعداد کیوبیتها افزایش یابد.
این مسیر با پژوهشی در سال ۲۰۱۸ در مجلهٔ Science آغاز شد. سرگئی براوی، دیوید گاسِت و رابرت کونیگ از IBM ثابت کردند که مدل خاصی از مدارهای کوانتومی کمعمق میتوانند مسائل جستوجویی را حل کنند که هیچ مدار کلاسیک کمعمقی قادر به حل آنها نیست. از آن زمان، پژوهشگران بهطور مداوم این فاصله را در برابر مدلهای کلاسیک پیشرفتهتر تقویت کردهاند.
تعریف انواع مسائل
نویسندگان این مقاله — شامل سرینیواسان آروناچالام و همکاران — بر روی دو نوع مسئله تمرکز کردند:
- مسائل تابعی (Functional Problems): محاسبه یک مقدار خاص یا بازگرداندن خروجی درست برای یک ورودی (مثلاً استخراج دقیق یک داده در پاسخ به پرامپت).
- مسائل نمونهبرداری (Sampling Problems): تولید خروجی بر اساس یک توزیع احتمالی (مثلاً تولید تصاویر یا متون جدید).
شکاف تابعی: نمایهگذاری تکرار شونده
نخستین پیشرفت مربوط به مسائل تابعی است. پژوهشگران بر روی ترنسفورمرهای «فقط رمزگشا» (Decoder-only) تمرکز کردند؛ همان معماری که در GPT، Claude و Llama به کار رفته است. این مدلها ورودی را توکنسازی (Tokenization) کرده، آنها را به صورت بردار معنایی (Embedding) تبدیل میکنند و سپس با مکانیزم توجه (Attention)، وزن این بردارها را در لایههای مختلف تغییر میدهند.
آنها از «تابع نمایهگذاری تکرار شونده» به عنوان محک استفاده کردند. در این مسئله، یک زنجیره از ارجاعات وجود دارد: یک ورودی در انتهای کتاب اول به کتاب دوم اشاره میکند و این روند ادامه مییابد تا هدف نهایی مشخص شود.
طبق مقاله «جداسازی مدارهای کوانتومی از LLMهای کلاسیک» که در ۴ اوت ۲۰۲۶ در arXiv منتشر شد، نتایج تکاندهنده است:
- محدودیت کلاسیک: هر ترنسفورمر کمعمق برای حل این مسئله به عرضی در مرتبه $n^{\Omega(1)}$ نیاز دارد تا موفق شود.
- برتری کوانتومی: این مسئله در مدارهای $QNC^0$ با عمق $O(\log \log n)$ قابل محاسبه است، به شرطی که با یک گیت AND کلاسیک تقویت شوند.
شکاف نمونهبرداری: توازن و انتشار
دومین اثبات، مسائل نمونهبرداری را هدف قرار میدهد که هستهٔ اصلی هوش مصنوعی زاینده در مدلهایی مثل DALL·E و Stable Diffusion است. تیم IBM بهطور خاص مدلهای انتشار (Diffusion Models) را تحلیل کرد؛ مدلهایی که با افزودن نویز به متن و سپس یادگیری معکوس این تخریب آموزش میبینند.
آنها این مدلها را در برابر «نمونهبرداری توازن» (Parity-sampling) آزمایش کردند. در این مسئله باید تشخیص داد که آیا رشتهای از صفرها و یکها، تعداد زوج یا فردی از یکها دارد یا خیر. مدارهای کوانتومی میتوانند با استفاده از درهمتنیدگی و تداخل، این توازن را بهطور بهینه پیشبینی کنند.
نکته حیاتی این است که تیم IBM حتی اثر زنجیره تفکر (Chain-of-Thought) را نیز در نظر گرفت؛ جایی که مدل توکنهای میانی تولید میکند تا مسئله را حل کند. آنها ثابت کردند که حتی با وجود زنجیره تفکر زیرخطی و امکان بازبینی توکنهای خروجی، مدلهای انتشار نمیتوانند با توزیع تولید شده توسط یک مدار کوانتومی کمعمق برابری کنند.
واقعیت نظری در برابر واقعیت عملی
باید تأکید کرد که این نتایج کاملاً نظری و مبتنی بر اثباتهای ریاضی هستند. نویسندگان اذعان میکنند که شکاف عظیمی بین سختافزار مورد استفاده در این اثباتها و ماشینهای امروزی وجود دارد.
در حالی که LLMهای مدرن روی خوشههای عظیم GPU اجرا میشوند، کامپیوترهای کوانتومی فعلی نویزی و مستعد خطا هستند. این پژوهش تاریخ دقیقی برای زمانی که سختافزار کوانتومی در دنیای واقعی بر GPU پیروز شود، ارائه نمیدهد؛ اما تأکید میکند که با رشد اندازه مسئله، پیروزی مدارهای کوانتومی اجتنابناپذیر است.
تغییر در محکهای هوش مصنوعی
این یافته فرضات این حوزه را تغییر میدهد و ثابت میکند که قوانین مقیاسپذیری (Scaling Laws) برای LLMها نمیتوانند هر مسئلهای را حل کنند. این یعنی «نقاط کوری» در معماری ترنسفورمر وجود دارد که هیچ مقدار اضافهتر از پارامتر یا داده نمیتواند آنها را ترمیم کند.
برای جامعه فنی، این موضوع بحث را از «چقدر میتوانیم مدل را بزرگ کنیم» به «چه معماریای برای این کلاس پیچیدگی لازم است» تغییر میدهد و تلاش برای دستیابی به رایانش کوانتومی تحملپذیر خطا را به عنوان یک تکامل ضروری برای AI توجیه میکند.
در بلندمدت، این مسیر به سوی یک آینده ترکیبی اشاره دارد. پردازندههای کوانتومی احتمالاً جایگزین LLMها نمیشوند، بلکه به عنوان شتابدهندههای تخصصی برای وظایفی با پیچیدگی بالا عمل خواهند کرد.
گام بعدی شما
- بررسی مقالات مربوط به $QNC^0$ برای درک عمیقتر از محدودیتهای محاسباتی ترنسفورمرها.
- دنبال کردن پیشرفتهای سختافزاری IBM در زمینه کاهش نویز کیوبیتها.
- تحلیل مجدد استراتژیهای مقیاسبندی مدلها با در نظر گرفتن محدودیتهای ریاضی اثبات شده.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو