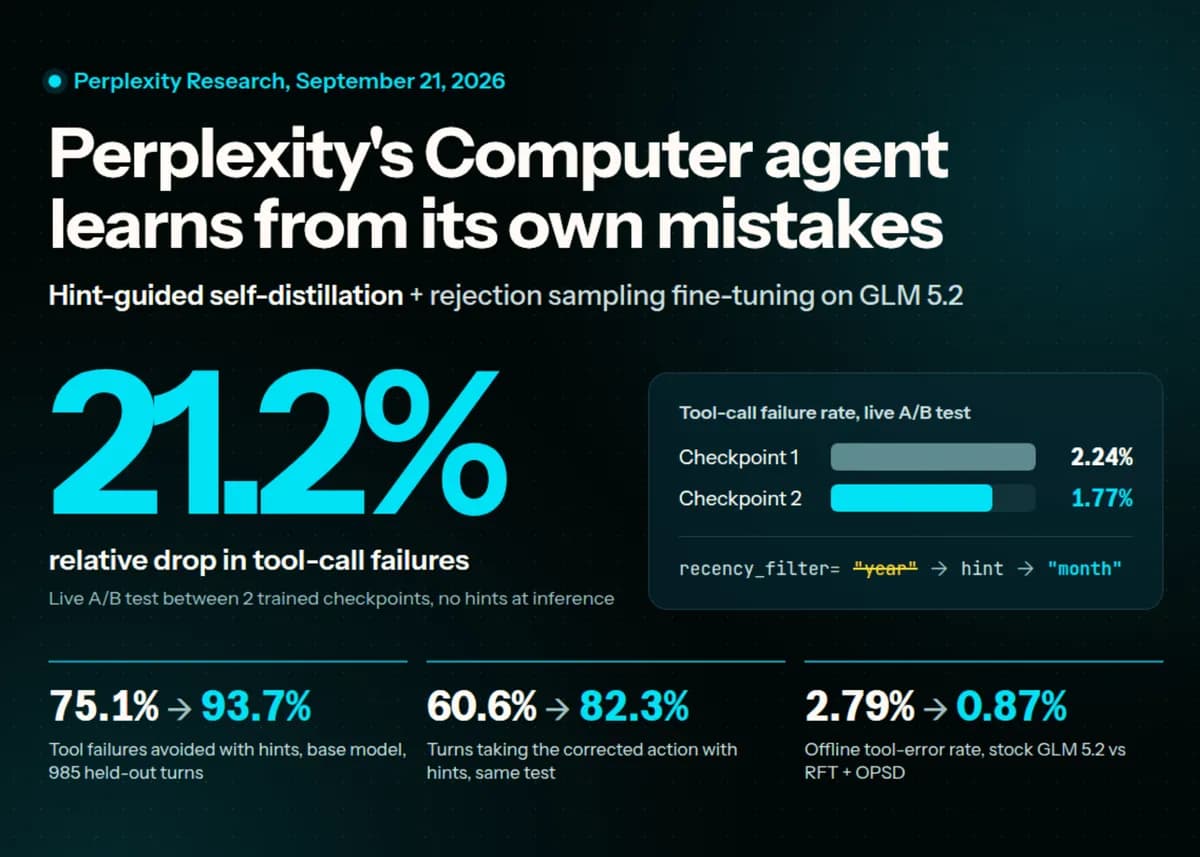
خطای فراخوانی ابزارها در عاملهای هوش مصنوعی ۲۱.۲٪ کاهش یافت؛ این نتیجهی اصلی مطالعهی جدید Perplexity Research است. این تیم با آموزش عامل Perplexity Computer روی جلسات واقعی کاربران، دقیقاً روی نقاط ضعفی تمرکز کرد که معمولاً در خط لولههای آموزشی استاندارد نادیده گرفته میشوند.
بیشتر آموزشهای عاملهای هوش مصنوعی بر پایه تنظیم دقیق نمونهگیری ردشده (Rejection Sampling Fine-Tuning یا RFT) است که تنها نتایج موفق را تقلید میکند. اما طبق گزارش این تیم، یک پاسخ نهایی موفق لزوماً به معنای درست بودن مسیر پیموده شده نیست؛ یک عامل ممکن است خطای ابزاری شدیدی مرتکب شود و سپس آن را جبران کند، که در صورت تقلید کل مسیر، این اشتباه تقویت میشود. برای حل این مشکل، Perplexity سیستمی را معرفی کرد که رفتارهای قابل تقلید را از اشتباهات نیازمند اصلاح تفکیک میکند. این رویکرد پاسخی به چالشی است که در آن بسیاری از عاملهای هوش مصنوعی با وجود تشخیص خطا در خروجی، همچنان نتایج ناقص را ارائه میدهند.
زمینه و دسترسی به مدل
این خط لوله از مدل بنیادی GLM 5.2 استفاده میکند. در حالی که مدل پایه در Hugging Face در دسترس است، وزنهای پسآموزش و کدهای آموزشی منتشر نشدهاند و این مدل منحصراً به عنوان یک گزینه مدل در داخل Perplexity Computer اجرا میشود.
بر اساس مستندات فنی، تیم هر نوبت پاسخدهی دستیار را به یکی از سه treatment یا روش برخورد تقسیم میکند:
- تقلید (Imitate): نوبتهای بدون خطا در جلسات موفق که با تابع زیان آنتروپی متقاطع (Cross-Entropy یا CE) آموزش میبینند.
- اصلاح (Correct): نوبتهای خطا که با یک راهنمای تأییدشده جفت شدهاند و از زیان واگرایی کولبک-لایبلر (KL Divergence) استفاده میکنند. این مورد میتواند در هر جلسهای رخ دهد، چه جلسه در نهایت موفق باشد و چه نباشد.
- بستر (Keep as Context): نوبتهای باقیمانده که در ورودی میمانند اما هیچ زیانی برای آنها محاسبه نمیشود.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی استنتاج در مدلهای زبانی اشاره کردیم، تفکیک دادههای آموزشی از نویز، کلید رسیدن به دقت بالاتر است. در اینجا، جلسات موفق میتوانند هم هدف تقلید و هم هدف اصلاح را فراهم کنند، در حالی که جلسات ناموفق تنها اهداف اصلاحی را ارائه میدهند.
مکانیزم تقطیر هدایتشده با راهنما
یک «راهنما» (Hint) در واقع دستورالعمل اصلاحی کوتاهی است که بر اساس اطلاعاتی نوشته شده که مدل قبلاً در اختیار داشت اما نادیده گرفته بود. برای مثال، اگر مدل از فیلتر «سال» استفاده کند در حالی که طرح دادهها (Schema) فقط «روز»، «هفته» یا «ماه» را میپذیرد، راهنما صراحتاً فراخوانی شکستخورده را نام میبرد، خطای اعتبارسنجی را ذکر میکند و یک مقدار مجاز را پیشنهاد میدهد یا پیشنهاد میکند که فیلد اختیاری حذف شود.
برای تبدیل این راهنماها به سیگنال آموزشی، Perplexity از تقطیر خودکار برخط (On-Policy Self-Distillation یا OPSD) استفاده میکند. در این سازوکار، Trainer یک نقطه بازرسی (Checkpoint) واحد از GLM 5.2 را دو بار اجرا میکند:
- گذر معلم (Teacher Pass): در این مرحله مدل راهنما را میبیند.
- گذر شاگرد (Student Pass): در این مرحله مدل راهنما را نمیبیند.
هر دو گذر از Teacher Forcing استفاده میکنند تا اطمینان حاصل شود که هیچ پاسخ جایگزینی تولید نمیشود. احتمال توکنهای بعدی معلم جدا شده (Detached) و از طریق Forward KL به عنوان یک هدف نرم (Soft Target) عمل میکند. زیان ترکیبی به صورت (CE + λ × KL) محاسبه شده و بر تعداد توکنهای تقلید شده تقسیم میشود. اگر ضریب λ صفر شود، سیستم به همان SFT استاندارد بازمیگردد. عبارت CE در اینجا حیاتی است، زیرا آموزشِ صرفاً مبتنی بر اصلاح ممکن است باعث شود معلم و شاگرد صرفاً با نادیده گرفتن بستر (Context) با یکدیگر موافق شوند. این موضوع یادآور آن است که تمرکز بیش از حد بر معیارهای دقت در RLVR میتواند استراتژیهای نمونهگیری مدل را تخریب کند.
اعتبارسنجی دادهها و تحلیل علت ریشهای
برای جلوگیری از سوگیری پسنگر (Hindsight Bias)، تیم اطمینان یافت که هر راهنما با اطلاعات موجود «پیش از وقوع خطا» بررسی شود. به عنوان مثال، وقتی کاربر در Paychex درخواست فرم 'w3' داد و مدل به اشتباه تصور کرد که این یک غلط تایپی برای 'W-2' است و فرم اشتباهی را جستجو کرد، راهنما روی همان تفسیر اولیه خطا تمرکز میکند، نه فقط روی پاسخ نهایی.
جزئیات عملیاتی خط لوله
جزئیات فنی این فرآیند به شرح زیر است:
- فیلتر کردن: دادهها از جلسات Computer که توسط GLM 5.2 ارائه شدهاند استخراج میشوند. کاربرانی که انصراف دادهاند و جلساتی که حاوی اطلاعات شناسایی شخصی (PII) هستند، حذف شدند.
- سختی: یک مدل زبانی بهمثابه داور (LLM-as-a-judge) تنها تکالیفی را نگه داشت که در مقیاس ۵-درجهای، نمره ۴ یا ۵ گرفته بودند.
- معیار موفقیت: برای موفق شناخته شدن یک جلسه، دو داور LLM باید هر دو پاسخ نهایی را تأیید کنند.
- ردیابی شکایت: سه داور LLM نوبت مسئول خطا را در بازخوردهای کاربران پیدا میکنند و باید حداقل دو داور توافق داشته باشند؛ این موضوع حیاتی است زیرا نوبت آخر پیش از شکایت، تنها در حدود ۵۰٪ موارد علت ریشهای است. این تحلیل دقیق بر اهمیت شناسایی نقصهای ساختاری تأکید دارد، چرا که بسیاری از شکستهای سامانههای چندعاملی بیش از آنکه به مدل مربوط باشند، ریشه در نقص فرآیندها دارند.
نتایج ارزیابی
نتایج نشان داد که راهنماها حتی پیش از آموزش مؤثر بودهاند. در ۹۸۵ مورد خطای ابزار که کنار گذاشته شده بودند (Held-out)، مدل پایه با داشتن راهنما در ۹۳.۷٪ موارد از تکرار خطا اجتناب کرد، در حالی که این رقم بدون راهنما ۷۵.۱٪ بود. سهم اقدامات اصلاحشده از ۶۰.۶٪ به ۸۲.۳٪ افزایش یافت. برای نوبتهای مربوط به بازخورد کاربر، نرخ اصلاح برای شواهد صریح از ۴۰.۰٪ به ۷۵.۰٪ و برای قصد استنباطشده از ۳۲.۵٪ به ۸۰.۰٪ رسید.
نرخ خطای ابزار در حالت آفلاین برای مدل GLM 5.2 خام ۲.۷۹٪ و برای مدل RFT تنها ۱.۳۵٪ بود. نقطه بازرسی ترکیبی RFT و OPSD به نرخ ۰.۸۷٪ رسید، هرچند Perplexity اشاره میکند که این موارد از دادههای آموزشی متفاوتی استفاده کردهاند.
در تستهای A/B زنده با حضور ۱۰۰ هزار کاربر در هر گروه، نرخ شکست فراخوانی ابزارها از ۲.۲۴٪ به ۱.۷۷٪ کاهش یافت. مقایسه یک نقطه بازرسی قدیمیتر با GLM 5.2 خام، نرخ شکست ۲.۸۲٪ در مقابل ۲.۹۴٪ را نشان داد که از نظر آماری معنادار نبود. نتایج در سطح تکالیف روی بنچمارکهای BrowseComp و SpreadsheetBench متغیر بود.
این تغییر، این فرض را که جلسات شکستخورده «دادههای پرت» یا ضایعات هستند، تغییر میدهد. Perplexity با تبدیل خطاها به اهداف اصلاحی با سیگنال بالا به جای نویز، نشان داد که عاملها میتوانند با استفاده از اصطکاکهای عملیاتی خودشان بهینه شوند. با این حال، تأثیر این روش بر رضایت کلی کاربران از نظر آماری معنادار نبود و نرخ نارضایتی شدید تنها از ۲.۵۸٪ به ۲.۵۴٪ رسید.
گام بعدی شما
- اگر از عاملهای هوش مصنوعی برای اتوماسیون استفاده میکنید، لاگهای شکست را به جای حذف، به عنوان دادههای آموزشی (Correction Targets) دستهبندی کنید.
- در طراحی سیستمهای Agentic، از مکانیزم «راهنمای اصلاحی» برای تبدیل خطاهای زمان اجرا به سیگنالهای یادگیری استفاده کنید.
- بررسی کنید که آیا خطاهای مدل شما ناشی از عدم دسترسی به داده است یا نادیده گرفتن Schemaهای موجود.
اما تأثیر این روش بر کاهش هزینههای استنتاج در مقیاس میلیونی حتی حیاتیتر است — به تحلیل ما دربارهی بهینهسازی GPUها مراجعه کنید.



گفتگو