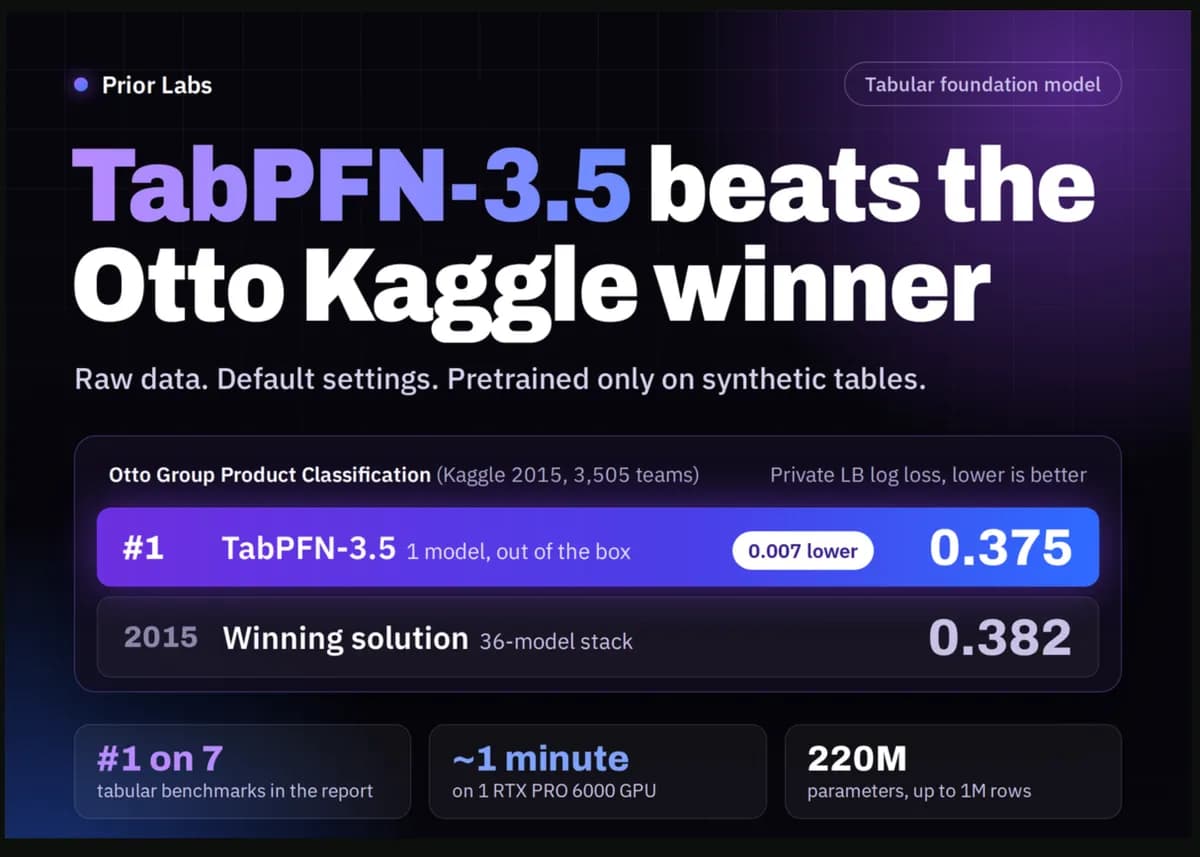
تصور کنید یک مدل هوش مصنوعی بتواند بدون دیدن حتی یک نمونه از دادههای شما و بدون هیچگونه تنظیم دستی، از پیچیدهترین سیستمهای آماری سالهای پیش پیشی بگیرد. این دقیقاً همان اتفاقی است که اکنون با TabPFN-3.5 رخ داده است.
طبق گزارش فنی Prior Labs، این مدل توانسته است در چالش طبقهبندی محصولات گروه Otto (سال ۲۰۱۵)، به نرخ زیان لگاریتمی (Log Loss) ۰.۳۷۵ برسد و بدین ترتیب رکورد برنده آن مسابقه (۰.۳۸۲) را جابهجا کند. نکته تکاندهنده این است که در حالی که برنده سال ۲۰۱۵ از مجموعهای پیچیده شامل ۳۶ مدل دستساز استفاده میکرد، TabPFN-3.5 این نتیجه را تنها با یک «گذر پیشرو» (Forward Pass) و بدون هیچ آموزشی روی دادههای آن مسابقه به دست آورده است.
زمینه و جزئیات چالش Otto
برای درک اهمیت این دستاورد، باید به فضای مسابقات Kaggle در سال ۲۰۱۵ بازگردیم. چالش طبقهبندی محصولات گروه Otto در آن زمان برگزار شد و ۳۵۰۵ تیم برای کسب جایزه ۱۰,۰۰۰ دلاری در آن رقابت کردند. شرکتکنندگان باید محصولات را با استفاده از ۹۳ ویژگی شمارشی مبهم (Obfuscated count features) در ۹ دسته مختلف طبقهبندی میکردند. امتیاز نهایی بر اساس «زیان لگاریتمی چندکلاسه» (Multi-class log loss) محاسبه میشد که در آن مقادیر پایینتر نشاندهنده عملکرد بهتر مدل است.
برنده اصلی این رقابت، استادان بزرگ کگل (Kaggle Grandmasters) به نامهای گیلبرتو تیتریتز و استانیسلاو سمنوف بودند که هر دو در دورهای رتبه اول جهان را در اختیار داشتند. راهکار برنده آنها یک ساختار لایهبندی شده و بسیار پیچیده متشکل از ۳۶ مدل بود که بر روی ویژگیهای دستساز (Hand-crafted features) بنا شده بود. در مقابل، TabPFN-3.5 برای رسیدن به نتیجه خود به هیچگونه آموزش یا تنظیم (Tuning) روی هر مجموعه داده نیاز ندارد.
طبق گزارش فنی Prior Labs، این مدل منحصراً روی دادههای مصنوعی (Synthetic data) پیشآموزش دیده است و هرگز با مجموعه داده Otto یا هیچ مجموعه داده دیگری از Kaggle مواجه نشده بود. نیک اریکسون، پژوهشگر Prior Labs و یکی از خالقان AutoGluon، اشاره میکند که اگرچه AutoGluon 1.6 در اوت ۲۰۲۶ به رتبه ۹ رسید، اما جهش نهایی برای رسیدن به امتیاز برنده، دشوارترین بخش بود. او توضیح میدهد که حرکت از رتبه ۵۰ به رتبه ۱۰ تنها زیان لگاریتمی را از ۰.۴۱ به ۰.۴۰ کاهش داد، اما رسیدن از رتبه ۱۰ به امتیاز برنده (۰.۳۸۲) نیازمند کاهش بیشتر ۰.۰۱۸ بود که تقریباً دو برابر تلاش قبلی را میطلبید. TabPFN-3.5 این مانع را تنها در حدود یک دقیقه روی یک واحد پردازش گرافیکی RTX PRO 6000 با استفاده از دادههای خام و تنظیمات پیشفرض پشت سر گذاشت.
معماری فنی و عملکرد
این مدل چندین تغییر ساختاری اساسی را برای بهبود استدلال روی دادههای جدولی معرفی کرده است:
- افزایش مقیاس: ابعاد ترنسفورمر در-بستر (In-context transformer) از ۵۱۲ به ۱۰۲۴ افزایش یافته است. تعداد پارامترها نیز از ۵۳ میلیون در نسخه TabPFN-3 به ۲۲۰ میلیون پارامتر رسیده است.
- رمزگذاریهای جدید: مقادیر اکنون از ویژگیهای فوریه آموختهشده (Learned Fourier features) و رتبههای ECDF در-بستر استفاده میکنند. این رتبهها تحت تبدیلهای یکنواخت (Monotonic transforms) مانند مقیاسبندی لگاریتمی تغییر نمیکنند.
- نقطه بازرسی یکپارچه: یک نقطه بازرسی (Checkpoint) واحد چندوظیفهای اکنون هر دو وظیفه طبقهبندی (Classification) و رگرسیون (Regression) را مدیریت میکند.
- سادهسازی خط لوله: Prior Labs مراحل پیشپردازش مانند تبدیلهای چندکی (Quantile transforms)، مقیاسبندی مقاوم (Robust scaling) و ویژگیهای SVD را حذف کرده است.
- ظرفیت داده: این مدل از حداکثر ۱ میلیون ردیف پشتیبانی میکند. توصیه شده است که از ۶,۰۰۰ ویژگی استفاده شود، اما مدل میتواند تا ۲۰,۰۰۰ ویژگی را پشتیبانی کند.
- توزیع پیشین تنظیمشده (Tuned Prior): دادههای آموزشی مصنوعی اکنون بر روی جداول عریض، گروهبندی شده و با کاردینالیتی بالا (High-cardinality) تأکید دارند.
در حال حاضر، TabPFN-3.5 در هفت محک (Benchmark) معتبر دادههای جدولی رتبه نخست را در اختیار دارد: TabArena، BeyondArena، STRABLE، MulTaBench، RelArena-α، TALENT و ScoringBench. در محک TabArena که یک بنچمارک پویا شامل ۵۱ مجموعه داده است، نسخه TabPFN-3.5-Thinking به امتیاز ۱۹۱۰ Elo رسید، در حالی که مدل پایه امتیاز ۱۸۶۶ را کسب کرد. این نتیجه، مدل AutoGluon 1.6 extreme را با اختلاف ۱۳۰ Elo و در یکپنجم زمان کمتر شکست میدهد.
محک BeyondArena شامل ۱۴۲ مجموعه داده است که دادههای زمانی (Temporal)، عریض، غنی از متن و با کاردینالیتی بالا را در بر میگیرد. TabPFN-3.5 حدود ۱۵۰ امتیاز Elo جلوتر از پیشرو قبلی است، هرچند مدلهای MLP تنظیمشده و مجموعهای (Ensembled) هنوز در بخشهای دادههای زمانی، گروهبندی شده و برشهای دادههای حجیم پیشتاز هستند.
خانواده مدلها
شرکت Prior Labs این عرضه را به چهار نسخه مجزا تقسیم کرده است:
- TabPFN-3.5: دارای وزنهای باز، ۲۲۰ میلیون پارامتر و به طور پیشفرض ۸ تخمینگر (Estimators).
- TabPFN-3.5-Fast (alpha): دارای وزنهای باز، ۸۴ میلیون پارامتر و تا ۶ برابر سریعتر از مدل پایه.
- TabPFN-3.5-Plus: فقط از طریق API و برای سازمانها. این نسخه قابلیت مدیریت بومی متن و توجه FP8 (FP8 attention) را اضافه میکند.
- TabPFN-3.5-Thinking: محاسبات استنتاج بیشتری را صرف میکند بدون اینکه از LLMها، دادههای واقعی یا جستجو استفاده کند. این نسخه تا ۱۲ برابر سریعتر از TabPFN-3-Thinking اجرا میشود.
با وجود افزایش تعداد پارامترها، حافظه KV Cache مشابه نسخههای قبلی باقی مانده است. این امر اجازه میدهد پیشبینیهای تک-ردیفی کششده، سرعت TabPFN-3 را حفظ کنند، اگرچه مدل پایه روی مجموعههای آموزشی بزرگ تا ۲ برابر کندتر از TabPFN-3 عمل میکند. این تمرکز بر بهینهسازی سرعت استنتاج در سختافزارهای محلی، مشابه رویکردی است که در پروژه DSpark برای افزایش پاسخدهی عاملهای هوشمند دنبال شد.
این تحول نشان میدهد که عصر مهندسی دستی ویژگیها (Feature Engineering) برای دادههای جدولی به سرعت در حال پایان است. Prior Labs با تبدیل پیشبینی جدولی به یک مسئله «یادگیری در بستر متن» (In-context Learning) به جای یک مسئله آموزشی، این حوزه را به سمت پارادایم «مدلهای بنیادی» برای دادههای ساختاریافته سوق میدهد.
در حالی که MLPهای تنظیمشده هنوز در برخی بخشهای خاص BeyondArena پیشتاز هستند، توانایی دستیابی به نتایج پیشرو (SOTA) بدون هیچگونه تنظیم، یک بهرهوری عظیم برای دانشمندان داده است. وزنهای باز برای تحقیقات غیرتجاری، ارزیابی و مسابقات Kaggle در دسترس است، در حالی که استفاده تولیدی نیازمند API یا مجوز تجاری است. کاربران اکنون میتوانند برای تأیید این نتایج به یک نوتبوک بازتولیدپذیر در Kaggle دسترسی داشته باشند.
گام بعدی شما
- اگر دانشمند داده هستید، نوتبوک بازتولیدپذیر این مدل در Kaggle را برای تست روی دادههای خود بررسی کنید.
- برای پروژههایی که محدودیت زمانی دارند، نسخه Fast را جایگزین مدلهای سنتی MLP کنید.
- بررسی کنید که آیا حذف مراحل پیشپردازش دادهها در خط لوله شما، دقت مدلهای جدید را تحت تأثیر قرار میدهد یا خیر.
اما تأثیر این رویکرد بر کاهش هزینههای زیرساختی استنتاج حتی جذابتر است — به تحلیل ما درباره بهینهسازیهای KV Cache در مدلهای ترنسفورمر مراجعه کنید. این بهینهسازیها در راستای کاهش هزینههای عملیاتی است، مشابه آنچه در مدل r-1 برای کاهش هزینه پردازش اسناد مشاهده شد.



گفتگو