تصور کنید یک دستیار مستندات که تا دیروز بینقص کار میکرد و تمام بررسیهای استقرار را با موفقیت پشت سر گذاشته بود، ناگهان پس از یک تغییر روتین در سیستم بازیابی، دچار تأخیر شدید شده و پاسخ نمیدهد. در حالی که نسخه مدل هیچ تغییری نکرده و سرویس در ظاهر سالم است، اما بازیاب اکنون بافت (Context) بیشتری را ارسال میکند. این افزایش حجم داده باعث کند شدن فرآیند تولید متن شده و درخواستها پشت یک سرور استنتاج شلوغ انباشته میشوند. از آنجایی که پیکربندی بازیابی در جای دیگری ذخیره شده است، بازگرداندن (Revert) کانتینر برنامه مشکل را حل نمیکند. این سناریو یک نقص حیاتی در نحوه استقرار هوش مصنوعی توسط تیمها را افشا میکند: تلقی کردن نسخه مدل به عنوان تنها منبع حقیقت برای رفتار سیستم.
بسیاری از تیمهای توسعه، استقرار هوش مصنوعی را شبیه به نرمافزارهای سنتی میبینند که در آن یک تگ نسخه (Version Tag) برای شناسایی تغییرات کافی است. اما هوش مصنوعی زاینده (Generative AI) — شبیه به آشپزی که علاوه بر دستور پخت، به کیفیت مواد اولیه و دمای دقیق فر وابسته است — یک «شبکه وابستگی» (Dependency Web) ایجاد میکند. در این سیستم، تغییر در یک پرامپت یا یک شاخص بازیابی میتواند کل زنجیره را بشکند، حتی اگر وزنهای مدل دستنخورده باقی بمانند. ورودیها، پیشپردازشها، پرامپتها، سیستم بازیابی، قراردادهای ابزارها (Tool Contracts) و تنظیمات سرویسدهی میتوانند به طور مستقل رفتار سیستم را تغییر دهند. این موضوع یک شکاف خطرناک بین یک بررسی استقرار موفق و یک تجربه کاربری شکستخورده ایجاد میکند.
این چالش در واقع گسترش یافتهی همان مشکلی است که صنعت با «انحراف آموزش-سرویسدهی» (Training-Serving Skew) دست و پنجه نرم میکند؛ مفهومی که مدتهاست در راهنمای MLOps گوگل (Google) مستند شده است. کاربردهای هوش مصنوعی زاینده، مجموعه وابستگیهایی را که میتوانند باعث شکستهای خاموش شوند، گسترش دادهاند. سیستمهای یادگیری ماشین سنتی پیش از این با این مشکل روبرو بودند: مثلاً یک طبقهبندیکننده (Classifier) که با یک تبدیل ویژگی خاص آموزش دیده، وقتی در محیط تولید با تبدیل دیگری مواجه میشود، رفتار نادرستی نشان میدهد. یک برنامه تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — به طور مشابه شکست میخورد؛ زمانی که بازیاب دادههای بیش از حدی را ارسال کند و باعث سربار سرور استنتاج شود. [1]
راهکار مانیفست انتشار
برای حل این مشکل، تیمها باید از نسخهبندی تکبعدی مدل به سمت یک «مانیفست انتشار» (Release Manifest) نسخهبندی شده حرکت کنند. این مانیفست مانند یک مرز دور تمام اجزایی است که باید به عنوان یک واحد واحد و یکپارچه عمل کنند. این کار تضمین میکند ترکیبی از اجزا که در محیط Staging تست شده، دقیقاً همان ترکیبی باشد که در لحظه شروع یک درخواست در محیط Production resolve میشود.
برای یک برنامه RAG، یک مانیفست کاربردی باید شامل شناسههای دقیقی مانند موارد زیر باشد:
- شناسه انتشار (release_id): مثلاً
docs-assistant-r17 - نسخه برنامه (app_revision): مثلاً
git-8f2a1c - نسخه مدل (model_revision): مثلاً
model-snapshot-42 - نسخه پرامپت (prompt_revision): مثلاً
support-v7 - بخش بازیابی: شامل نسخه شاخص (index_revision) مانند
docs-index-2026-09-01، نسخه بردار معنایی (Embedding) مانندembed-v3و نسخه خط لوله (pipeline_revision) مانندchunk-and-rank-v4 - نسخه زمان اجرا (runtime_revision): مثلاً
serving-config-v6(که مواردی چون محدودیت توکنها، دستهبندی یا Batching، مهلتهای زمانی و جایگذاری منابع را پوشش میدهد) - مجموعه ارزیابی: مثلاً
support-regression-v12 - انتشار قبلی: مثلاً
docs-assistant-r16
اگر برنامه از ابزارهای خارجی (Tools) استفاده میکند، مانیفست باید طرحوارهها (Schemas) و آداپتورهای آنها را نیز نسخهبندی کند. برای حفظ امنیت، مانیفست باید تنها ارجاعاتی به اسرار (Secrets) را ذخیره کند و هرگز مقادیر واقعی اسرار را در خود نگه ندارد.
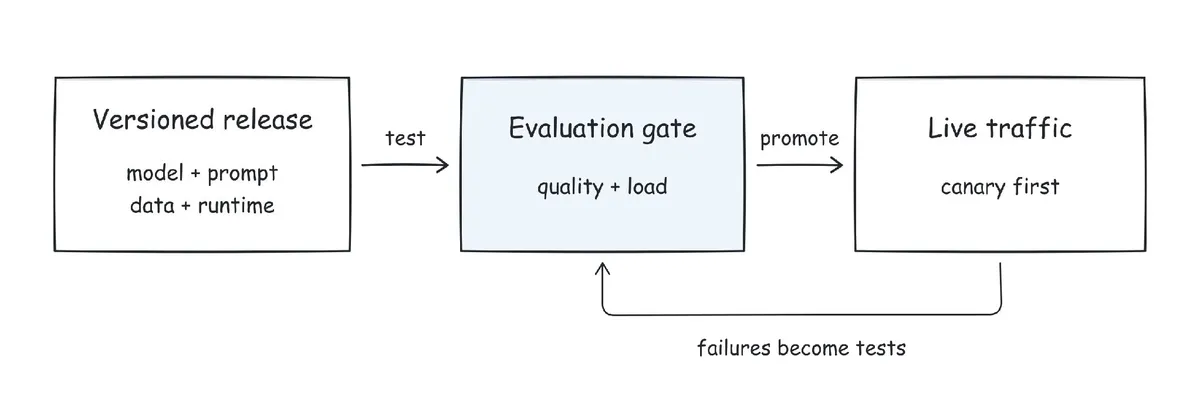
باید توجه داشت که مانیفست، تضمینی برای بازتولید بیتبهبیت (Bit-for-bit reproducibility) نیست. سرویسهای خارجی تغییر میکنند، تولید متن اغلب غیرقطعی (Nondeterministic) است و ارائهدهندگان مدلها ممکن است اسنپشاتهای تغییرناپذیر ارائه ندهند. به جای اینکه یک نام مستعار شناور (Floating Alias) را به عنوان یک نسخه ثابت جا بزنیم، باید این محدودیتها را ثبت کنیم. در جاهایی که دادهها به طور مداوم تغییر میکنند، باید «واترمارک» (Watermark) جذب دادهها و پیکربندی شاخص را ثبت کرد تا حتی زمانی که بازپخش (Replay) ناقص است، بتوان حوادث را بررسی کرد.
این رویکرد با کل خط لوله (Pipeline) به عنوان یک واحد اتمیک برخورد میکند. بهروزرسانی چهار ذخیرهگاه پیکربندی مختلف به صورت متوالی، یک «انتشار» نیست؛ بلکه مجموعهای از تغییرات پرریسک است که میتواند سیستم را در وضعیت ناسازگار قرار دهد. مدیریت متمرکز این وابستگیها میتواند هزینههای عملیاتی را به شدت کاهش دهد؛ برای مثال، استفاده از کاتالوگهای مدل یکپارچه در Oxlo.ai نشان داد که چگونه سازماندهی مدلها میتواند پیچیدگیهای محیط تولید را مدیریت کند.
پیادهسازی دروازه ارزیابی
دریافت کد موفقیت HTTP 200 به معنای عبور از یک دروازه کیفی نیست. یک سرویس میتواند کد موفقیت برگرداند اما همچنان در پاسخ به کاربر شکست بخورد. برای یک دستیار مستندات، یک پاسخ مفید باید به منبعی قابل دسترس ارجاع دهد، نسخه صحیح محصول را منعکس کند و در صورت نبود شواهد، از اختراع دستورالعملهای ساختگی خودداری کند. اینها بررسیهایی متفاوت از در دسترس بودن نقطه انتهایی (Endpoint Availability) هستند.
تیمها باید یک مجموعه داده فشرده و نسخهبندی شده بسازند که حول محور تسکهایی باشد که آن ویژگی قرار است انجام دهد. این مجموعه داده باید شامل موارد زیر باشد:
- پرسشهای عادی و متداول
- شکستهایی که پیش از این مشاهده شدهاند
- درخواستهای مبهم
- مواردی که شواهد لازم در آنها موجود نیست
- تلاشها برای عبور از مرزهای مجوز دسترسی (Authorization Boundaries)
برای جلوگیری از بیشبرازش (Overfitting) پرامپت روی مجموعه تست — شبیه دانشآموزی که سوالات امتحان را حفظ میکند اما مفهوم را نمیفهمد — باید یک مجموعه ارزیابی مجزا (Held-out evaluation set) نگه داشت تا تنظیمات مکرر باعث نشود مجموعه تست به یک هدف آموزشی تبدیل شود.
مکانیزمهای اعتبارسنجی
بررسیهای قطعی (Deterministic) باید در اولویت باشند؛ مواردی مانند اعتبار طرحواره (Schema)، آرگومانهای مجاز ابزارها، شناسههای ارجاع و اجرای سختگیرانه مجوزها. برای قضاوتهای معنایی، باید یک معیار (Rubric) تعریف کرد و امتیازات خودکار را با بررسی انسانی مقایسه کرد. اگر از یک مدل زبانی بهمثابه داور (Model-based judge) استفاده میشود، باید دانست که خروجی آن حقیقت مطلق نیست؛ پیکربندی این داور باید ثابت (Pinned) باشد و اختلافات بین داور و انسان باید بررسی شوند، نه اینکه صرفاً با میانگینگیری نادیده گرفته شوند.
دروازه ارزیابی باید کل مسیر را بسنجد، نه فقط مدل را. یک تست مدلمحور، تغییرات بازیابی را که در مثال ابتدایی ذکر شد، نادیده میگیرد. باید انتشار را از مراحل بازیابی، تولید و اعتبارسنجی خروجی عبور داد و سپس نتایج را به صورت قطعهقطعه (Slices) بررسی کرد: ورودیهای طولانی، زبانهای مختلف، نسخههای محصول و درخواستهایی با شواهد پراکنده.
معیارهای پذیرش
معیارهای پذیرش (Acceptance Criteria) باید پیش از نگاه کردن به کاندید تعیین شوند. یک سیاست عملی میتواند هرگونه نقض مشاهدهشده در کنترل دسترسی را دلیل رد انتشار قرار دهد، مستنداتی بخواهد که نشان دهد بخشهای مهم تسکها فراتر از یک تلورانس مشخص رگرسیون (پسرفت) نداشتهاند، و الزام کند که بودجههای تأخیر و هزینه تحت یک بار کاری نماینده (Representative Workload) حفظ شوند.
یک شکست در دروازه ارزیابی باید یک اثر عیبیابی (Debugging Artifact) تولید کند که شامل شناسههای انتشار کاندید و خط مبنا (Baseline)، نسخه مجموعه داده، موارد شکستخورده و ردیابیهای (Traces) مربوطه باشد. یک بیلد قرمز که فقط میگوید «کیفیت کاهش یافت»، ناکافی است و رفع مشکل را به یک پروژه تحقیقاتی تبدیل میکند.
اندازهگیری عملکرد در محیط عملیاتی
تعداد درخواست در ثانیه (RPS) معیار ضعیفی برای مدلهای زبانی است. یک پرسش کوتاه و یک سند حجیم، فشار متفاوتی به سختافزار میآورند. تیمها باید توزیع طول ورودی، طول خروجی، همزمانی (Concurrency) و فورانهای ورود درخواستها را تست کنند، که شامل هر دو حالت حافظه موقت گرم (Warm Cache) و سرد (Cold Cache) باشد.
در پاسخهای جریانی (Streaming)، معیارهای vLLM نشان میدهند که باید «زمان تا نخستین توکن» (Time to First Token) را از سرعت توکنهای بعدی و زمان کل تکمیل جدا کرد. اغلب دلیل اصلی نارضایتی کاربر، زمان انتظار در صف (Queue Time) است؛ سرور ممکن است پس از پذیرش درخواست، توکنها را سریع تولید کند، اما کاربر بیشتر وقت خود را در انتظار ورود به سیستم گذرانده باشد. [2]
زیرساخت و تأخیر
تحلیل باید با ردیابیهای سرتاسری (End-to-end traces) شروع شود و سپس به بازیابی، بازرتبهبندی (Reranking)، صفبندی، پیشپرورش (Prefill)، رمزگشایی (Decoding) و فراخوانیهای پاییندستی برسد. اشتباه رایج این است که p95 هر مرحله را با هم جمع کنند تا p95 کل را به دست آورند، زیرا این صدکها ممکن است توصیفکننده درخواستهای متفاوتی باشند. باید از زمانبندی هر درخواست (Per-request timing) برای شناسایی اینکه درخواستهای کند وقت خود را کجا میگذرانند، استفاده کرد.
دستهبندی (Batching) یک موازنه حیاتی بین توان عملیاتی (Throughput) و تأخیر ایجاد میکند. انتظار برای جمعآوری درخواستها میتواند توان عملیاتی را بهبود بخشد اما تأخیر قابل مشاهده برای کاربر را افزایش دهد. NVIDIA Triton Inference Server این موضوع را از طریق تأخیرهای قابل تنظیم در صف برای دستهبندی پویا (Dynamic Batching) صریح میکند. اگرچه این با دستهبندی مستمر (Continuous Batching) در سرورهای اتورگرسیو یکسان نیست، اما درس یکسان است: دقیقاً همان زمانبندیکنندهای (Scheduler) را بنچمارک کنید که اجرا میکنید. [3]
مکانیسمهای استقرار ایمن
بهرهوری GPU یک سیگنال تشخیصی است، نه هدف محصول. هدف نهایی تجربه کاربر است. این امر مستلزم محدود کردن صفها، انتشار مهلتهای زمانی (Deadlines) و اجرای بودجههای تلاش مجدد (Retry Budgets) است. تلاشهای نامحدود میتواند باری اضافی به سیستمی که در حال حاضر تحت فشار است اضافه کند؛ تلاشهای مجدد باید به مهلت زمانی باقیمانده و یک بودجه صریح احترام بگذارند.
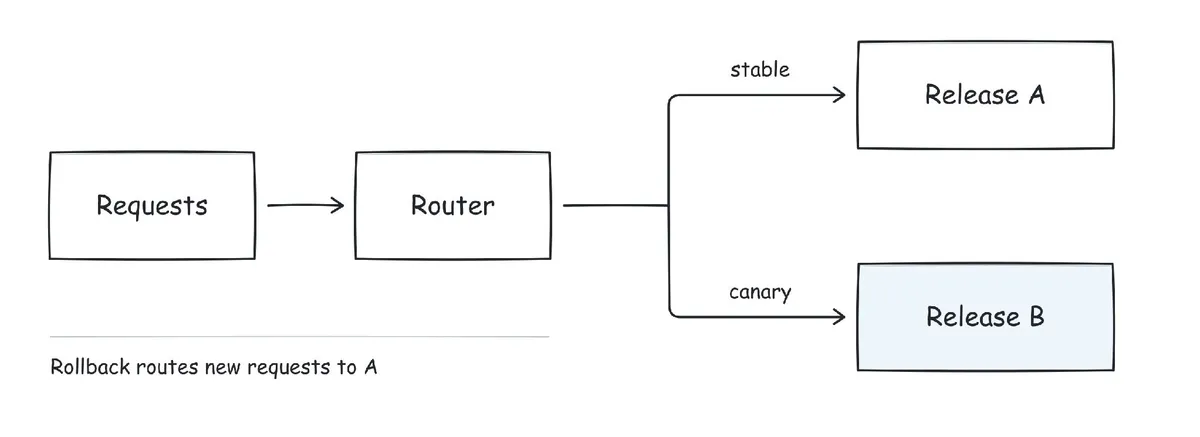
استقرارهای کاناری (Canary) باید نسخه کاندید را با یک گروه کنترل مقایسه کنند. طبق گزارش SRE Workbook گوگل، یک کاناری «ساکت» لزوماً نشانه موفقیت نیست؛ بلکه ممکن است صرفاً به این معنا باشد که کاناری بخشهای حیاتی بار کاری را که اهمیت دارند، به چالش نکشیده است. [4]
تخصیص درخواستها باید آگاهانه باشد. تصادفی کردن هر درخواست برای تسکهای مستقل جواب میدهد، اما یک گفتگو (Conversation) ممکن است به تخصیص پایدار نیاز داشته باشد تا رفتار سیستم در میانه گفتگو تغییر نکند. علاوه بر تفاوتها، اهداف مطلق سرویس را نیز بررسی کنید؛ یک وابستگی مشترک شکستخورده میتواند هم کاناری و هم گروه کنترل را تخریب کند.
بازگشت و بازیابی (Rollback)
بازگشتها باید جامع باشند. اگر یک انتشار جدید، شاخص بازیابی را در جای خود بازنویسی کرده باشد، صرفاً بازگرداندن کد برنامه مشکل را حل نمیکند. تیمها باید نسخههای سازگار شاخص را نگه دارند یا مهاجرتهای بازگشتپذیر طراحی کنند. اسنپشاتهای تاریخی همچنان باید لغو دسترسیهای فعلی و الزامات حذف دادهها را رعایت کنند. همچنین باید حافظههای موقت (Cache) مربوطه را نسخهبندی یا ابطال کرد تا یک مسیر قدیمی، نتایجی را که تحت فرضیات نسخه کاندید تولید شدهاند، ارائه ندهد.
تغییر مسیر (Routing) فقط بر درخواستهایی اثر میگذارد که هنوز تخصیص نیافتهاند. تولیدات در حال اجرا (In-flight generations) نیاز به یک سیاست تخلیه (Drain) یا لغو صریح دارند. اثرات جانبی ابزارها — مانند ارسال یک ایمیل — با تغییر نسخه مدل قابل بازگشت نیستند. بنابراین باید از «تکرارپذیری» (Idempotency) و مرزهای تأیید استفاده کرد و اطمینان یافت که ترافیک سایه (Shadow Traffic) اثرات جانبی واقعی ایجاد نمیکند.
تحلیل هزینه و کیفیت
یک درخواست ارزانتر لزوماً به معنای یک تسک تکمیلشده ارزانتر نیست. اگر یک کاندید کمهزینه باعث تلاشهای مجدد بیشتر یا ارجاع به انسان شود، صرفهجوییها از بین میروند. هزینه را به صورت «هزینه به ازای هر تسک موفق» محاسبه کنید: مجموع هزینههای سرویسدهی و پشتیبانی تقسیم بر تعداد تسکهایی که معیار موفقیت تعریفشده را برآورده کردهاند، در حالی که تلاشهای شکستخورده در صورت کسر (صورت کسر) شمرده شوند.
مقایسه باید بین موارد مشابه باشد. انتشاری که ارزانتر به نظر میرسد چون پاسخها را بیصدا کوتاه (Truncate) میکند، باید در ارزیابی رد شود. هدف، یافتن یک محدوده عملیاتی مفید است: کدام بار کاری کیفیت و تأخیر مورد نیاز را تأمین میکند، با چه هزینهای و با چه مقدار فضای خالی (Headroom) برای رشد؟
بستن حلقه بازخورد
هر حادثه در محیط عملیاتی باید منجر به ایجاد یک مورد تست جدید در مجموعه ارزیابی شود که رفتار مورد انتظار و بافت آن مشخص باشد. این کار پیوندی مستقیم بین شکستهای عملیاتی و دروازه کیفیت انتشار بعدی ایجاد میکند. با این حال، به رسمیت بشناسید که بازخوردهای تولیدی گزینشی هستند: شکایتها برخی کاربران را بیش از حد نمایندگی میکنند و کلیکها لزوماً به معنای صحت پاسخ نیستند.
در مدلهای پیشبین، «انحراف ورودی» (Input Drift) باعث بررسی میشود؛ اما در کاربردهای زاینده، یک تغییر در پرامپت یا بازیابی میتواند نیازمند یک انتشار جدید باشد، حتی بدون نیاز به یک جاب آموزش (Training Job). در هر دو مورد، ارتقای نسخه باید به شواهدی درباره سیستم نهایی وابسته باشد.
مسئولیتها باید در سطح رابطها (Interfaces) تعریف شوند. تیم برنامه رفتار را تعریف میکند، تیم پلتفرم تضمین میکند که ماشینآلات استقرار قابل اعتماد هستند و مالکان دادهها تازگی و سیاستهای دسترسی را مدیریت میکنند. بدون یک شخص تعیینشده که قدرت متوقف کردن یک رولاوت (Rollout) را داشته باشد، یک هشدار فقط نویز است.
در نهایت، هدف سیستمی است که در آن یک مهندس On-call بتواند دقیقاً شناسایی کند کدام انتشار پشت یک پاسخ بد است و در عرض چند ثانیه یک نسخه سازگار را بازیابی کند. اگر این مسیر شفاف نیست، فرآیند استقرار شما سریعتر از حد ایمنی است.
گام بعدی شما
- مانیفست انتشار را برای پروژه خود تعریف کنید و تمام وابستگیهای غیر از مدل (پرامپت، ایندکس، تنظیمات سرور) را در آن ثبت کنید.
- یک مجموعه داده ارزیابی (Eval Set) شامل شکستهای واقعی گذشته بسازید تا از رگرسیون در نسخههای جدید جلوگیری کنید.
- معیارهای پذیرش (Acceptance Criteria) را پیش از هر تغییر در مدل یا پرامپت مکتوب کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو