اگر امروز برای مدیریت کدهای پیچیده به هوش مصنوعی تکیه میکنید، باید بدانید که سدِ توهمات در مهندسی نرمافزار جابهجا شده است. با انتشار Grok 4.6 در نیمه اول سپتامبر ۲۰۲۶، شرکت xAI توانست به نرخ موفقیت ۷۳.۸ درصدی در محک SWE-bench Verified برسد. این مدل با بهرهگیری از یک مزیت سختافزاری عظیم، توانست مسائلی را حل کند که پیش از این باعث توهمات (Hallucinations) در مدلهای زبانی بزرگ میشد.
این پیشرفت در حالی رخ میدهد که صنعت AI با بازدهی نزولی در پیشآموزشهای سنتی دستوپنجه نرم میکند. در حالی که سایر آزمایشگاهها با گلوگاههای شدید ترازسازی (Alignment) در هنگام استنتاج مواجه هستند، xAI روی برتری محاسباتی فیزیکی شرطبندی کرده است. Grok 4.6 نخستین استقرار تجاری بزرگی است که بهطور کامل از ابرخوشه Colossus در ممفیس، تنسی بهره میبرد؛ زیرساختی که بیش از ۲۰۰ هزار شتابدهنده با تراکم بالا را در اختیار دارد.
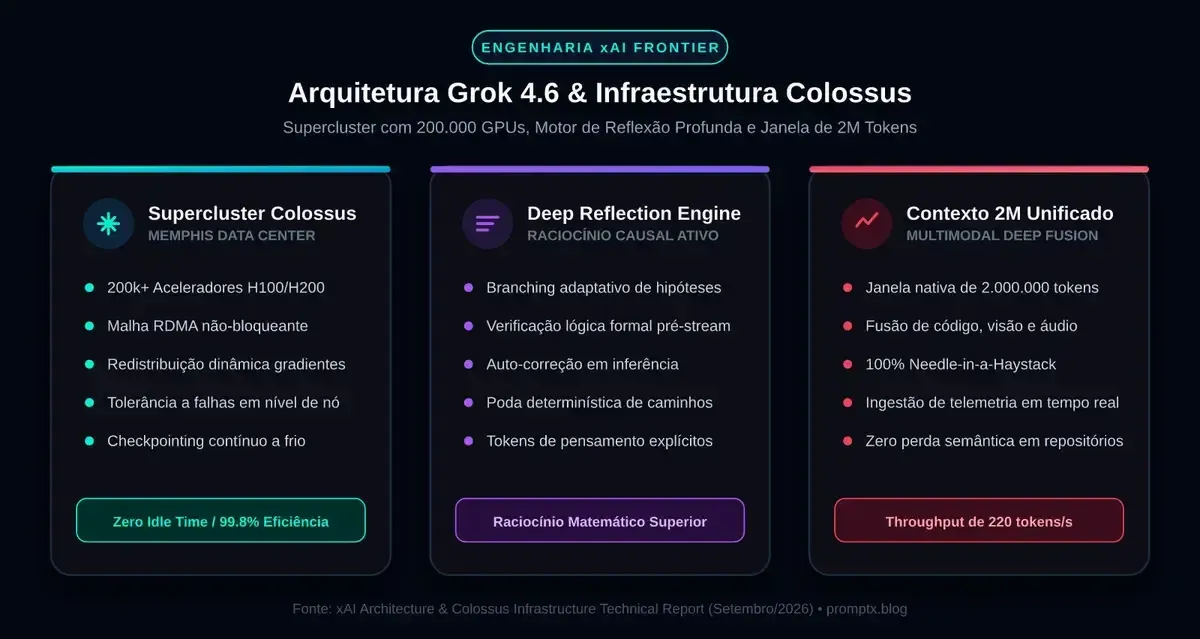
زیرساخت Colossus
مقیاس Colossus تنها به تعداد GPUها محدود نمیشود. این خوشه از یک مش نوری RDMA بدون احتقان (Congestion-free) برای اتصال GPUهای H100 و H200 استفاده میکند. تمامی این اجزا از طریق یک سیستم آب تصفیه شده با مدار بسته خنک میشوند. برای حفظ پایداری سیستم در مقیاس وسیع، xAI واحدهای Tesla Megapacks را ادغام کرده است تا نوسانات ولتاژ شبکه برق محلی باعث کرش کردن فرآیندهای آموزشی نشود.
یکی از حیاتیترین دستاوردهای مهندسی در این پروژه، «افزونگی گرم در سطح گره» (Node-level hot redundancy) است. در خوشههای رایج، خرابی سختافزاری منجر به توقف کامل و نیاز به بازگشت به آخرین نقطه بازرسی (Checkpoint) ذخیره شده روی دیسکهای مشترک NVMe میشود که این امر باعث اتلاف ۱۵ تا ۲۵ درصد از کل انرژی الکتریکی مصرفی میگردد. اما زیرساخت Grok 4.6 از تلهمتری زیر میلیثانیهای برای رصد دمای پیوندها (Junction temperatures)، نوسانات ولتاژ گذرگاه PCIe و نرخ خطای حافظه ECC استفاده میکند.
این سیستم اجازه میدهد ایزولاسیون پویا بدون توقف جهانی (Global Pause) صورت گیرد. اگر یک گره ناپایدار شود، توپولوژی شبکه تنسورهای گرادیان را در کمتر از ۴۰۰ میلیثانیه و از طریق RDMA over RoCE v2 به گرههای رزرو منتقل میکند. این مکانیسم تضمین میکند که گام بهینهسازی جهانی هرگز متوقف نشود و در نتیجه، بازدهی عملیاتی به ۹۹.۸ درصد میرسد.
یادگیری تقویتی از طریق تایید رسمی (RLFV)
این پایداری سختافزاری به xAI اجازه داد تا از RLHF (بازخورد انسانی) به RLFV یا یادگیری تقویتی از طریق تایید رسمی کوچ کند. در مرحله پسآموزش (Post-training)، مدل به کامپایلرهای زبان رسمی مانند Lean 4، Coq و Isabelle/HOL و همچنین محیطهای ایزوله (Sandboxes) لینوکس متصل شد.
در این رویکرد، بهجای تکیه بر ترجیحات ذهنی انسان، مدل صرفاً بر اساس صحت اثباتپذیر پاداش میگیرد. این معیارها شامل موارد زیر است:
- خروجی تستهای واحد (Unit Test) با کد بازگشت صفر.
- نبود کامل خطاهای Segmentation Fault.
- اثباتهای ریاضی که توسط یک هسته قطعی (Deterministic Kernel) تایید شدهاند.
این رویکرد یادگیری تقویتی، شباهتهای ساختاری زیادی با متدهای تضمین محاسباتی دارد؛ بهطور مشابه، سیستم MathKernel نیز با ایجاد ردپای کامل تلاش میکند تا خطاهای محاسباتی در مدلهای زبانی را به طور کامل حذف کند. این فرآیند باعث حذف سطحینگری در پاسخها و توهمات نحوی شده و به Grok 4.6 دقتی در سطح حسابداری (Actuarial Precision) میبخشد.
موتور بازتاب عمیق (Deep Reflection Engine)
قلب تپنده Grok 4.6، موتور بازتاب عمیق است. برخلاف مدلهای استاندارد خودبازگشتی که توکن بعدی را بهصورت خطی و بر اساس احتمال P(xt+1 | x≤t) پیشبینی میکنند، این موتور فرآیند رمزگشایی (Decoding) را از تامل و تفکر (Deliberation) جدا میکند.
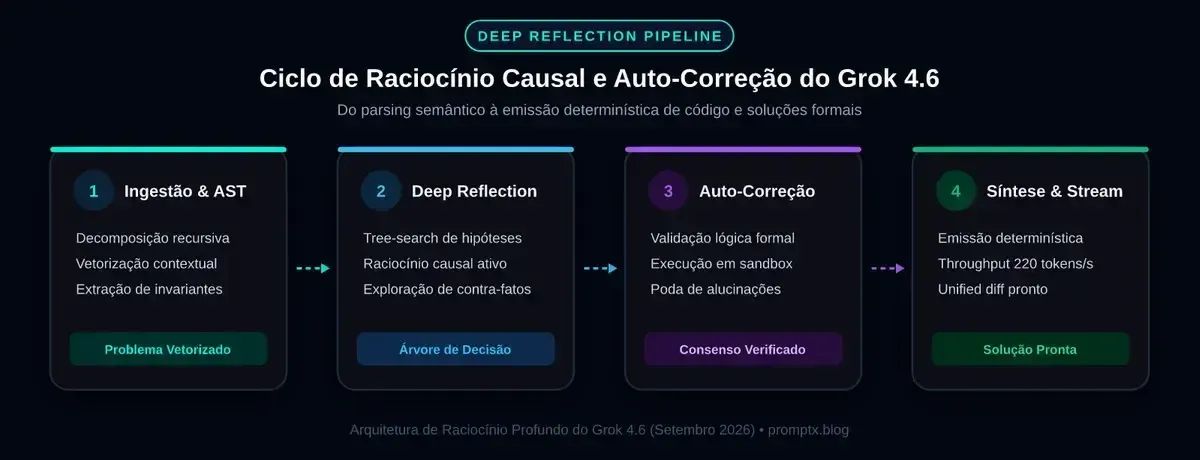
وقتی مدل با یک پرامپت پیچیده روبرو میشود، مراحل زیر را طی میکند:
- ساخت گراف فرضیه: مدل چندین تنسور بازتابی ایجاد کرده و از جستوجوی درختی مونتکارلو (MCTS) به کمک یک شبکه مقدار عصبی برای بررسی مسیرهای استدلالی استفاده میکند.
- پروجکشن ضد-واقعی (Counter-factual Projection): مدل بهطور داخلی مسیرهای استدلالی جایگزین تولید کرده و پیامدهای گامهای جبری یا تصمیمات طراحی مختلف را صراحتاً ارزیابی میکند.
- هرس علی و معلولی (Causal Pruning): اگر یک شاخه به تناقض در پیشفرضها یا خطای کامپایل منجر شود، آن شاخه بهطور برگشتناپذیر هرس شده و مدل به محتملترین گره علی قبلی بازمیگردد (Backtracking).
این فرآیند کاملاً شفاف است. از طریق API رسمی، این گامهای میانی به عنوان reflection_tokens تحویل داده میشوند تا توسعهدهندگان بتوانند منطق داخلی AI را پیش از تولید پاسخ نهایی بازرسی و ممیزی کنند.
فرمولبندی ریاضی بازتاب
موتور بازتاب عمیق با استفاده از یک تابع زیان ترکیبی چندهدفه آموزش دیده است:Ltotal = LNLL(θ) + λref Lreflection(θ) + λverif Lformal(θ)
- LNLL(θ): زیان کلاسیک احتمال منفی لگاریتمی روی توکنهای پاسخ نهایی تایید شده.
- Lreflection(θ): شاخههای اکتشافی را که از ناورداهای منطقی (Logical Invariants) منحرف میشوند جریمه میکند. این مقدار از طریق واگرایی کولبک-لایبلر در برابر مسیرهای جستوجوی استاندارد تولید شده در پیشآموزش MCTS محاسبه میشود.
- Lformal(θ): یک زیان تقویتی که توسط هستههای رسمی هدایت میشود. هر خطای سینتکس یا نوع (Type Error) از سوی کامپایلر، جریمه شدیدی (Rerror = -1.0) ایجاد میکند، در حالی که یک اثبات تایید شده یا پوشش تست ۱۰۰ درصدی، حداکثر پاداش (Rsuccess = +1.0) را به همراه دارد.
زمینه متنی چندوجهی و سرعت
Grok 4.6 از یک پنجره متنی بومی ۲ میلیون توکنی پشتیبانی میکند. این مدل از طریق «توجه نهان با فشردهسازی بالا» (High-compression latent attention) به این هدف رسیده است؛ به این صورت که حالتهای توجه گذشته را در تنسورهای فشرده کمبعد ذخیره کرده و آنها را تنها برای بلوکهایی که توسط پرسوجوهای فعلی فعال میشوند، بازسازی میکند.
در تستهای «سوزن در انبار کاه» (Needle-in-a-haystack)، که در آن حقایق تصادفی در اعماق ۱٪ تا ۹۹٪ از پنجره ۲ میلیون توکنی قرار داده شدند، مدل نرخ بازیابی ۱۰۰ درصدی را حفظ کرد و از اشباع مشاهده شده در سایر مدلهای بسته پیشی گرفت.
چندوجهی بودن در این مدل بهجای الحاق تکه تکه، بهصورت یکپارچه طراحی شده است. تصاویر، فریمهای ویدئویی مستمر، شکلموجهای صوتی و کدهای منبع همگی به یک فضای بردار معنایی (Embedding) مشترک منتقل میشوند. این قابلیت به مدل اجازه میدهد تا مثلاً یک جهش صوتی خاص در ضبط یک توربین را در یک پاس محاسباتی واحد، با یک خط کد تلهمتری خاص مرتبط کند.
برای حل مشکل تأخیر (Latency) که در مدلهای استدلالی رایج است، xAI از رمزگشایی گمانهزنانه (Speculative Decoding) در مقیاس وسیع استفاده کرده است. یک مدل کمکی ۸ میلیارد پارامتری بهطور همزمان روی همان شتابدهنده اجرا شده و توالیهای ۵ تا ۸ توکنی را پیشبینی میکند. مدل اصلی Grok 4.6 این توالیها را در یک بررسی تنسوری موازی تایید میکند که منجر به سرعت استریم پایدار ۲۲۰ توکن در ثانیه میشود.
نبرد بنچمارکهای سپتامبر ۲۰۲۶
طبق دادههای کنسرسیوم BenchLM منتشر شده در سپتامبر ۲۰۲۶، Grok 4.6 اکنون در خط مقدم قرار دارد. این تحلیل برای تمرکز بر رهبران فعلی، نسلهای قدیمیتر را حذف کرده و مدلهای GPT-6 Astra، Claude Fable 5.1، DeepSeek 4.1 و Gemini 3.8 Flash را مقایسه کرده است.
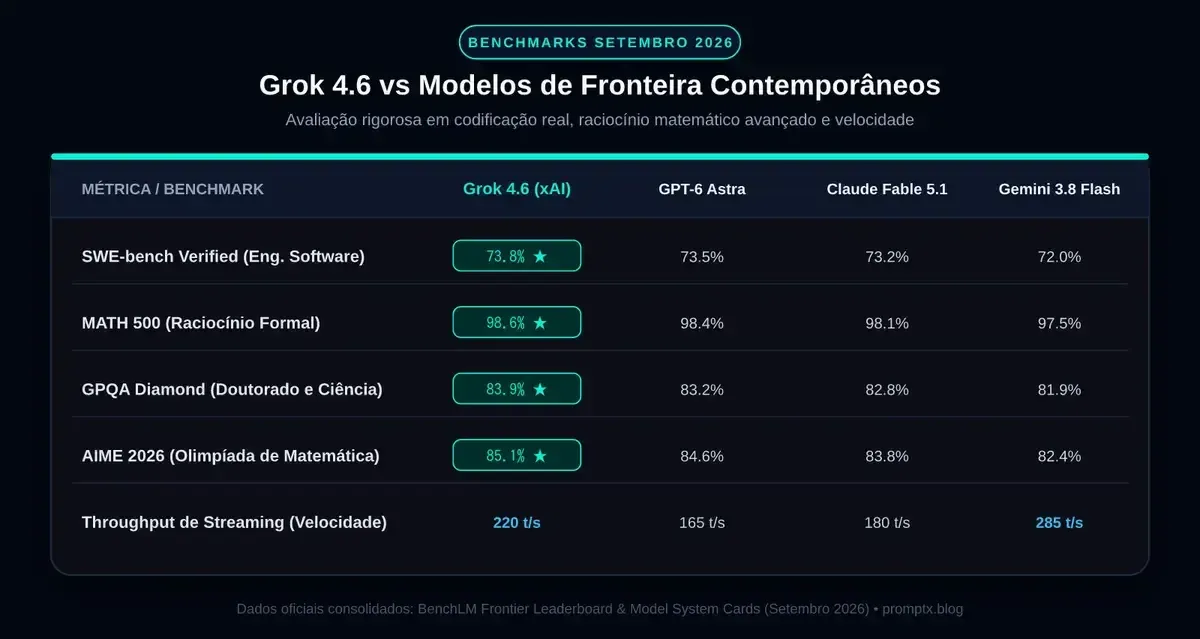
- SWE-bench Verified: Grok 4.6 با امتیاز ۷۳.۸٪، مدلهای GPT-6 Astra (۷۳.۵٪)، DeepSeek 4.1 (۷۳.۶٪) و Claude Fable 5.1 (۷۳.۲٪) را شکست داد. این مدل در پیمایش درختهای دایرکتوری گیتهاب و تولید پچهای اتمیک برای مخازنی مانند Django، SymPy یا Matplotlib تخصص دارد.
- MATH 500: مدل به دقت ۹۸.۶٪ رسید و تقریباً این بنچمارک را به پایان رساند. خطاهای محاسباتی پایه که در مدلهای مولد رایج بود، تقریباً حذف شدهاند.
- GPQA Diamond: در سوالات علمی سطح دکترا (فیزیک کوانتوم، ژنتیک مولکولی) امتیاز ۸۳.۹٪ را کسب کرد و از GPT-6 Astra (۸۳.۲٪) و Gemini 3.8 Flash (۸۱.۹٪) پیشی گرفت.
- AIME 2026: Grok 4.6 با ۸۵.۱٪ پیشتاز بود و پس از آن DeepSeek 4.1 (۸۴.۲٪) و GPT-6 Astra (۸۴.۶٪) قرار داشتند.
اقتصاد Grok Enterprise
برای مدیران فناوری (CTO)، مخربترین جنبه این مدل، هزینه کل مالکیت (TCO) است. xAI قیمت API خود را بهگونهای تعیین کرده که بهشدت قیمتهای بازار را پایین بیاورد.
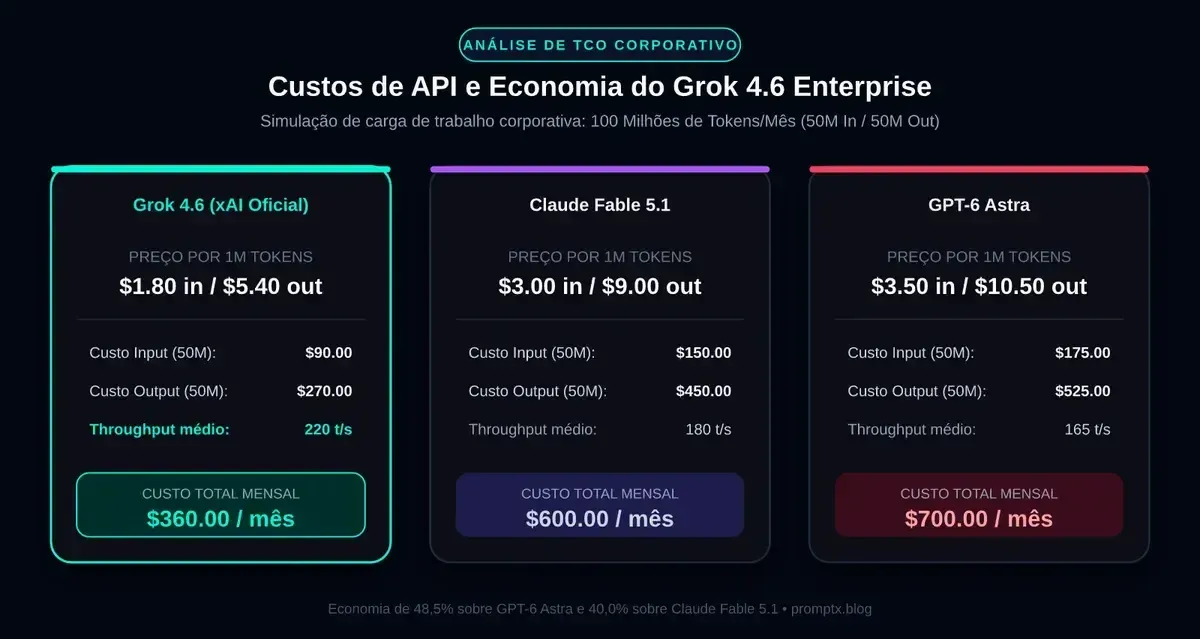
قیمت API عمومی ۱.۸۰ دلار برای هر میلیون توکن ورودی و ۵.۴۰ دلار برای هر میلیون توکن خروجی تعیین شده است. همچنین xAI تخفیف ۷۵ درصدی برای توکنهای ورودی کششده (Prompt Caching) ارائه میدهد که هزینه را برای زمینههای تکراری مانند شمای دیتابیسها به ۰.۴۵ دلار در هر میلیون توکن کاهش میدهد.
برای مقیاسهای عظیم، سطح SuperGrok Heavy & Enterprise Dedicated برشهای محاسباتی فیزیکی اختصاصی روی Colossus را فراهم میکند که تضمینکننده نرخ پردازش (Throughput) تضمینی، عدم ذخیرهسازی دادهها برای آموزش و انطباق با استانداردهای SOC 2 Type II و ISO 27001 است.
در یک شبیهسازی بار کاری شرکتی با ۱۰۰ میلیون توکن در ماه (۵۰ میلیون ورودی / ۵۰ میلیون خروجی):
- Grok 4.6: ۳۶۰ دلار در ماه (۴,۳۲۰ دلار سالانه).
- Claude Fable 5.1: ۶۰۰ دلار در ماه (۷,۲۰۰ دلار سالانه).
- GPT-6 Astra: ۷۰۰ دلار در ماه (۸,۴۰۰ دلار سالانه).
این به معنای صرفهجویی ۴,۰۸۰ دلاری در سال برای یک تیم ۲۰ نفره در مقایسه با GPT-6 Astra است، در حالی که پنجره متنی کاربردی دو برابر بزرگتر است.
پیادهسازی: ممیز خودکار پایتون
برای ادغام Grok 4.6، توسعهدهندگان میتوانند از اندپوینت رسمی (https://api.x.ai/v1/chat/completions) استفاده کنند. پیادهسازی زیر یک کلاینت ناهمگام (Asynchronous) را با فعالسازی بازتاب عمیق و فراخوانی ابزارها نشان میدهد:
import asyncio
import json
import os
from typing import Any, AsyncGenerator, Dict, List, Optional
import aiohttp
class GrokClient:
    def __init__(self, api_key: Optional[str] = None, base_url: str = "https://api.x.ai/v1"):
        self.api_key = api_key or os.environ.get("XAI_API_KEY")
        if not self.api_key:
            raise ValueError("Chave de API da xAI não configurada.")
        self.base_url = base_url.rstrip("/")
        self.session: Optional[aiohttp.ClientSession] = None
    async def __aenter__(self):
        self.session = aiohttp.ClientSession(headers={"Authorization": f"Bearer {self.api_key}", "Content-Type": "application/json"})
        return self
    async def __aexit__(self, exc_type, exc_val, exc_tb):
        if self.session:
            await self.session.close()
    async def stream_chat(self, messages: List[Dict[str, str]], tools: Optional[List[Dict[str, Any]]] = None) -> AsyncGenerator[Dict[str, Any], None]:
        payload = {"model": "grok-4.6", "messages": messages, "temperature": 0.2, "max_tokens": 4096, "stream": True, "deep_reflection": True}
        if tools:
            payload["tools"] = tools
            payload["tool_choice"] = "auto"
        if self.session is None:
            raise RuntimeError("Cliente não inicializado; use async with.")
        async with self.session.post(f"{self.base_url}/chat/completions", json=payload) as response:
            if response.status != 200:
                raise RuntimeError(f"Erro na API xAI ({response.status}): {await response.text()}")
            async for line in response.content:
                decoded = line.decode("utf-8").strip()
                if not decoded.startswith("data: "): continue
                data = decoded[6:]
                if data == "[DONE]": break
                try:
                    choices = json.loads(data).get("choices", [])
                    if choices: yield choices[0].get("delta", {})
                except json.JSONDecodeError: continue
class AutonomousCodeAuditor:
    def __init__(self, client: GrokClient):
        self.client = client
    async def audit(self, code: str, filename: str):
        messages = [{"role": "user", "content": f"Audite {filename} e proponha uma solução verificada. Código recebido: {code}"}]
        async for delta in self.client.stream_chat(messages):
            if delta.get("content"): print(delta["content"], end="", flush=True)
async def main():
    async with GrokClient() as client:
        await AutonomousCodeAuditor(client).audit("print('teste')", "exemplo.py")
if __name__ == "__main__":
    asyncio.run(main())
تحلیل: گذار به هوش قابل تایید
این انتشار نشاندهنده تغییر جهت در رقابت تسلیحاتی AI از «دادههای بهتر» به «تاییدات بهتر» است. با ادغام هستههای رسمی (Lean 4/Coq) مستقیماً در حلقه پاداش، xAI از حدسهای احتمالی مدلهای زبانی به سمت محاسبات قطعی حرکت میکند.
برای توسعهدهنده، این بدان معناست که بالاخره میتوان به عاملهای AI برای کدهای محیط عملیاتی (Production) اعتماد کرد. توانایی هرس کردن مسیرهای استدلالی نادرست پیش از اینکه روی صفحه نوشته شوند، حلقه «آزمون و خطا» را که در حال حاضر جریانهای کاری عاملمحور (Agentic Workflows) را مختل میکند، کاهش میدهد.
با این حال، تکیه بر ابرخوشه Colossus نشاندهنده شکافی رو به رشد در دنیای AI است. مانع ورود دیگر تنها نبوغ الگوریتمی نیست، بلکه توانایی مدیریت ۲۰۰ هزار GPU و زیرساخت برق عظیمی است که برای روشن نگه داشتن آنها لازم است. این تمرکز بر بهینهسازی سختافزاری و معماری، در راستای روندهای جدیدی است که در مخزن متنباز OpenArch و بررسی ۷۲ معماری مدرن LLM برای دسترسی به بازدهی بالاتر دنبال میشود.
برای ادغام Grok 4.6، تیمهای مهندسی باید این دستورالعملها را دنبال کنند:
- Temperature: برای کارهای قطعی بین ۰.۱ تا ۰.۳ تنظیم شود. دماهای بالا در حالت بازتاب عمیق میتواند با بررسی فرضیات حاشیهای، تأخیر را افزایش دهد.
- بودجه توکن: مقدار
max_tokensرا حداقل روی ۴,۰۹۶ یا ۸,۱۹۲ قرار دهید، زیرا توکنهای بازتابی (Reflection Tokens) از سقف خروجی مصرف میکنند. - کشینگ: دستورات سیستمی و مستندات ایستا را در ابتدای پرامپت قرار دهید تا تخفیف ۷۵ درصدی کش فعال شود.
- تأخیر: برای کارهای زیر یک ثانیه، گزینه
deep_reflection: falseرا تنظیم کنید تا زمان تا نخستین توکن (TTFT) به زیر ۶۵ میلیثانیه برسد.



گفتگو