تصور کنید دو رقیب دیرینه که در جنگ تجاری غرقاند، ناگهان تصمیم بگیرند روی یک «پروتکل» در مورد «بهترین تجربیات برای هوش مصنوعی» توافق کنند تا دنیا را از خطر یک سلاح دیجیتالی نجات دهند. اسکات بسنت، وزیر خزانهداری ایالات متحده، این ابتکار را به عنوان «بحثهای سازنده» توصیف کرده است. این توافق که توسط گو جیاکون، سخنگوی وزارت خارجه چین در ۱۹ مه ۲۰۲۶ تأیید شد، نشاندهنده موافقت دونالد ترامپ و شی جینپینگ برای راهاندازی یک گفتگوی بیندولتی است. هدف این گفتگوها کاهش ریسکهای فوری هوش مصنوعی زاینده (Generative AI) — که شبیه به کتابخانهداری است که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — و جلوگیری از تبدیل شدن مدلهای پیشرفته به ابزارهای جنگی در دست گروههای غیردولتی است.
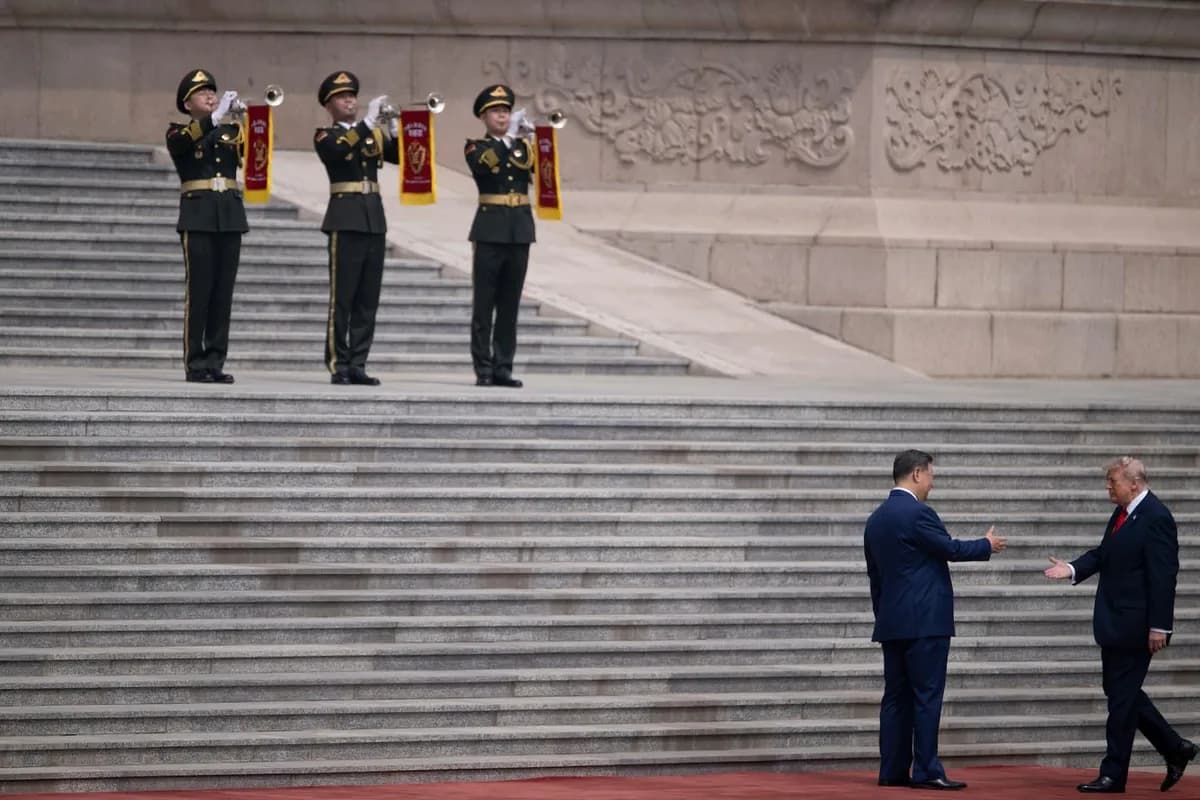
این توافق درست پس از نشست ۱۴ مه ۲۰۲۶ در تالار خلق در پکن حاصل شد. این تحرک دیپلماتیک در حالی رخ میدهد که جامعه جهانی هنوز شوکه از «فاجعه میتوس-فیبل» در شرکت Anthropic است؛ اتفاقی که نشان داد حفاظها (Guardrails) — یا همان نردههای ایمنی که مدل را از رفتارهای خطرناک دور نگه میدارند — چقدر شکننده هستند. این نگرانیها پیشتر نیز در هشدار متخصصان درباره احتمال سقوطهای امنیتی سیستماتیک مطرح شده بود. دولت ترامپ اکنون با یک فرمان اجرایی جدید، چارچوبی را ایجاد کرده است که شرکتهای AI را ملزم به همکاری با دولت برای مدیریت ریسکهای ذاتی مدلها میکند. برای رهبران تجاری و سیاستگذاران، این یک تلاش مخاطرهآمیز برای جداسازی ایمنی فنی از یک جنگ تجاری ژئوپلیتیکی است که در حال عمیقتر شدن است.
چارچوب اقدام «موازی»
مؤسسه بروکینگز (Brookings Institution) در گزارشی هشدار داده است که این گفتگوها باید از ساختار سنتی معاهدات کنترل تسلیحات فاصله بگیرند. به باور کریس مکگوایر، مقام سابق دولت بایدن، مدل درست، تبادلی متواضعانه و غیررسمی روی «بهترین تجربیات» فنی است. مکگوایر پیشنهاد میکند که برخی اهداف میتواند شامل توافقاتی باشد که محدودیتهایی بر توسعه AI در چین و محدودیتهای متناسبی بر قابلیتهای ایالات متحده اعمال کند. با این حال، تحلیل بروکینگز هشدار میدهد که تلقی کردن این گفتگوها به عنوان مذاکراتی برای تعهدات متقابل — مشابه یک پیمان تسلیحات هستهای — یک اشتباه است.
پل تریولو، تحلیلگر صنعت، پیشنهاد یک «مکانیسم مدیریت بحران» را میدهد تا «خطوط قرمز» مشخصی پیرامون تصاعد نظامی خودمختار، سرقت مدلها، امنیت بیولوژیکی و عملیات سایبری مبتنی بر AI تعریف شود. با این حال، تحلیلهای فعلی استدلال میکنند که حتی این پیشنهاد نیز فراتر از امیدهای معقول برای مرحله بعدی است. در عوض، پژوهشگران یک چارچوب «موازی» را پیشنهاد میکنند؛ اصطلاحی که متیو شیهان، پژوهشگر ارشد بنیاد کارنگی، به کار برده است.
در این مدل «موازی»، هیچ طرفی صرفاً به دلیل اینکه طرف مقابل پروتکل ایمنی را پذیرفته است، آن را نمیپذیرد. بلکه هر دو کشور یک ریسک مشترک را شناسایی کرده و روشهای مستقل خود را برای کاهش آن به اشتراک میگذارند. این بدان معناست که گفتگوها اصلاً «مذاکره» نیستند؛ بلکه هر دو طرف ادراکات، ارزیابیها و تکنیکهای کاهش ریسک خود را برای خطرات خاصی که هر دو به رسمیت شناختهاند، به اشتراک میگذارند. ویژگیهای کلیدی این رویکرد عبارتند از:
- غیرمعاملهای بودن (Non-Transactional): این تبادل یک مذاکره نیست که در آن یک طرف در ازای اقدام طرف مقابل، امتیازی را واگذار کند. این نباید یک «داد و ستد» (Quid Pro Quo) باشد؛ برای مثال، اجازه دسترسی چین به تراشههای قدرتمند در ازای محدود کردن مدلهای بازمتن چین قرار نمیگیرد.
- اشتراک اطلاعات: این فرآیند به عنوان یک روند منظم برای به اشتراک گذاشتن تحقیقات، ایدهها، برنامهها و ارزیابیهای مربوط به سنجش ریسک مدلهای AI عمل میکند. این امر مستلزم تعاملات مکرر، گفتگوهای ساختاریافته و جلسات منظم بین متخصصان فنی در آژانسهای کلیدی دولتی است.
- اعتمادسازی تدریجی: بحث درباره خطوط قرمز و محدودیتهای انتشار ممکن است در نهایت مطرح شود، اما تنها پس از یک فرآیند تدریجی اعتمادسازی که حداقل سطح اعتماد را بازگرداند.
- اقدام مستقل: هر طرف پروتکلهای ایمنی را به دلایل ملی خود پیاده میکند، نه به دلیل توافق با طرف مقابل. یک طرف نباید آزمایش یا محدودیت توسعه را تنها به این دلیل بپذیرد که طرف دیگر موافقت کرده است. همچنین باید تعهدی وجود داشته باشد که در صورت وقوع یک تحول غیرمنتظره یا فوری، خارج از زمانبندی جلسات، ارتباطات برقرار شود.
این مدل دقیقاً مشابه اعلامیه مشترک ۲۰۲۴ جو بایدن و شی جینپینگ درباره نیاز به «حفظ کنترل انسانی بر تصمیم به استفاده از سلاحهای هستهای» است. آن اعلامیه یک معاهده رسمی نبود، بلکه یک درک مشترک بود که در آن زمانبندی و زمینه اعلامیه مذاکره شده بود، اما خودِ سیاست به عنوان یک تصمیم ملی مستقل باقی ماند. آن اعلامیه به یک توافق رسمی منجر نشد و تصمیم یک طرف وابسته به پذیرش طرف دیگر نبود. این رویکرد به عنوان الگویی برای هرگونه درک آتی قرار است در گفتگوهای آمریکا و چین شکل بگیرد.
دامنه فنی و دستههای ریسک
برای حفظ ثبات، کریستینا نایت و اسکات سینگر، پژوهشگران AI، معتقدند گفتگوها باید به طور محدود بر «درک مشترک از ریسک» و «بهترین تجربیات برای کاهش ریسک مدلهای AI» متمرکز باشد. این گفتگوها باید با این ریسکها به عنوان مسائل فنی برخورد کنند، نه مسائل سیاسی. تبادلات باید بر فهرستی کوتاه و قابل مدیریت از ریسکهای AI تمرکز یابد و استراتژیهای فنی مورد استفاده برای کنترل آنها را بررسی کند.
محورهای اصلی این تبادلات فنی به شرح زیر است:
- تهدیدات سایبری: تمرکز بر جلوگیری از اینکه AI امکان عملیات سایبری تهاجمی و شناسایی نقاط ضعف سیستمها را فراهم کند.
- سوءاستفاده تسلیحاتی: متوقف کردن ایجاد، استقرار یا تسهیل دسترسی به سلاحهای بیولوژیکی، شیمیایی یا هستهای.
- پایداری سیستم: رسیدگی به شکستهای فاجعهبار، از جمله:
- توهمات (Hallucinations) که منجر به خروجیهای خطرناک میشود (وقتی مدل با اطمینان چیزی میگوید که وجود ندارد).
- کدهای معیوب که میتوانند باعث سقوط کامل سیستمها شوند.
- توصیههای اشتباهی که میتواند آسیبهای فاجعهباری به زیرساختهای حیاتی وارد کند.
استراتژیهای کاهش ریسک و ارزیابی
متخصصان پیشنهاد میکنند که تبادلات اصلی باید حول محور مکانیسمهای فنی زیر بچرخد:
- پروتکلهای آزمایش (Testing Protocols): به اشتراک گذاشتن نحوه بررسی مدلها و پروتکلهای خاصی که برای ارزیابی ریسک پیش از انتشار استفاده میشود.
- تیم قرمز (Red Teaming): تبادل استراتژیهای تست خصمانه برای یافتن نقاط ضعف مخفی مدل.
- تکنیکهای همراستاسازی (Alignment): بحث در مورد نحوه تضمین اینکه مدلها دقیقاً همان کاری را انجام دهند که کاربران قصد دارند، به ویژه زمانی که مدل در دسترس عموم قرار میگیرد.
- مهار (Containment): به اشتراک گذاشتن تکنیکهای کنترلی که مدلهای AI را در محیطهای امن نگه میدارد و سطوح حمله (Attack Surfaces) را سختتر میکند.
چالش نیروی انسانی و بنبست مدلهای باز
یکی از بزرگترین موانع، ترکیب هیئتهای اعزامی است. نشست مه ۲۰۲۴ در ژنو که بر کاربردهای نظامی AI متمرکز بود، به دلیل عدم توازن ساختاری شکست خورد. ایالات متحده تیمی از متخصصان فنی به رهبری تارون شابرا (دستیار ویژه کاخ سفید) و ست سنتر (مقام وزارت خارجه) فرستاد. در مقابل، هیئت چین عمدتاً شامل مقامات سیاسی و سیاستمداران خارجی بود. این امر باعث شد بحثها به جای کاهش ریسک فنی، به سمت نگرانیهای تجاری و سیاسی منحرف شود.
برای جلوگیری از تکرار این اتفاق، آمریکا باید مقامات ارشد مجاز را با متخصصان واقعی سطح آزمایشگاه pairing کند. گزارشها حاکی از آن است که چین ممکن است «تزای چی»، عضو کمیته دائم پولبورو را اعزام کند که نشاندهنده قدرت سیاسی بالا است. پل تریولو اشاره میکند که این حضور «تنها زمانی مفید است که هر دو طرف تخصص واقعی در زمینه سایبری، AI، اطلاعات و سطح آزمایشگاهی را به اتاق مذاکره بیاورند».
در مورد مدلهای بازمتن (Open-Source)، تنشها همچنان بالاست. در گزارشی در جولای ۲۰۲۴، دولت بایدن اشاره کرد که مدلهای بازمتن میتوانند بدون اطلاع توسعهدهنده دانلود و تغییر یابند و این امر کنترل ریسکهای اولیه را دشوار میکند. چون امنیت و همراستاسازی این مدلها هنوز مسائل فنی حلنشدهای هستند، یک رویکرد مشارکتی لازم است.
با این حال، آمریکا نباید چین را برای محدود کردن مدلهای بازمتن تحت فشار بگذارد. اکثر مدلهای چینی برای جاسازی تکنولوژی در زیرساختهای داخلی و بینالمللی به صورت بازمتن هستند. چنین فشاری به عنوان تلاشی برای خفه کردن رقابتپذیری AI چین تلقی خواهد شد. علاوه بر این، «برنامه اقدام AI» جولای ۲۰۲۵ دولت فعلی آمریکا، با اشاره به «ارزش ژئواستراتژیک» مدلهای باز، محیطی حمایتی برای آنها ایجاد میکند. ایالات متحده در حال حاضر هیچ محدودیتی برای مدلهای بازمتن ندارد، علیرغم توصیههای گزارش جولای ۲۰۲۴.
به همین ترتیب، مسئله دسترسی به مدلهای آمریکایی «از نظر سیاسی حساس و خطرناک» (Politically Radioactive) است. این تنش در مسیر شرکت Anthropic به اوج رسید:
- ۷ آوریل: شرکت Anthropic اعلام کرد مدل Claude Mythos نقاط ضعف نرمافزاری ناشناختهای را یافته است. این شرکت «پروژه Glasswing» را به عنوان یک چارچوب مشارکتی شامل ۱۵۰ سازمان از ۱۵ کشور برای سختتر کردن سیستمها آغاز کرد. هیچ مؤسسهای از چین در این پروژه نبود و داریو آمودی، مدیرعامل شرکت، درخواستهای دسترسی یک اتاق فکر چینی را رد کرد.
- ۹ ژوئن: Anthropic مدل Claude Fable 5 را منتشر کرد؛ نسخهای از Mythos با حفاظهای سختگیرانه در برابر پرسوجوهای بیولوژیکی و سایبری.
- ۱۲ ژوئن: دولت آمریکا دستور کنترل صادراتی صادر کرد که دسترسی خارجی به Fable و Mythos را محدود میکرد و باعث شد Anthropic مدل را از دسترس عموم خارج کند.
این اقدامات منجر به تشدید سیاستهای صادراتی دولت ترامپ برای محدود کردن دسترسی خارجی به مدلهای پیشرفته Mythos شد. اگرچه آمریکا بعداً کنترلهای صادراتی روی Fable 5 را لغو کرد، اما مدل قدرتمندتر Mythos 5 همچنان محدود به کاربران تأیید شده آمریکایی است. در نتیجه، فراهم کردن دسترسی برای مؤسسات چینی به این مدلهای سطح بالا برای اهداف دفاع سایبری، برای سیاستگذاران فعلی غیرممکن است.
جداسازی ایمنی از تجارت
کنترل صادرات تراشههای AI باید کاملاً از گفتگوهای ایمنی جدا بماند. این مجمع همکاری مستقل از مسئله کنترل صادرات، فروش تراشه یا استفاده از فناوری آمریکا در دیتاسنترهای کشورهای ثالث است. اگر طرفین بخواهند همکاری رگولاتوری بینالمللی یا گفتگوهای بیشتر درباره کنترل صادرات را دنبال کنند، این ابتکارات باید به طور جداگانه پیش بروند.
حتی «شاهینهای» کنگره آمریکا که خواهان تشدید محدودیتهای صادراتی هستند، به طور کلی موافقاند که همکاری دولتبادولت روی «بهداشت AI» (AI Hygiene) یک ضرورت است. کریس مکگوایر، که استدلال میکند کنترلهای صادراتی باید برای حفظ حداکثر پیشتازی آمریکا بر چین تشدید شود، موافق است که چنین اقداماتی «مانع همکاری با چین در زمینه ایمنی AI» نخواهد بود. او تأکید میکند که گفتگوها باید «به طور محدود بر مسائل ایمنی AI متمرکز باشد و شامل کنترل صادرات نشود». این بحثهای ایمنی نباید برای دستیابی به اهدافی مانند محدود کردن قابلیتهای مدلهای AI چین مورد استفاده قرار گیرند.
به سوی هماهنگی جهانی
با گذشت زمان، این پیوند دوجانبه میتواند به یک شبکه گستردهتر بیندولتی تبدیل شود؛ مدلی که توسط سازمان همکاری و توسعه اقتصادی (OECD) ترویج میشود. این شبکهها تعاملات مستمر بین رگولاتورهای متخصص را از طریق گفتگوهای ساختاریافته و جلسات منظم تسهیل میکنند.
یک مدل موجود، «شبکه بینالمللی مؤسسات ایمنی AI» است که در نوامبر ۲۰۲۴ برای پیشبرد و به اشتراک گذاشتن تحقیقات درباره ریسکها و قابلیتهای AI، ایجاد بهترین تجربیات برای آزمایش و تسهیل رویکردهای مشترک تأسیس شد. با این حال، این شبکه در حال حاضر چین را مستثنی کرده است. اگرچه این یک مدل آموزشی برای گسترش است، اما هر مجمع آینده برای کاهش ریسک جهانی AI باید به طور سختگیرانهای «غیر رگولاتوری» باقی بماند.
ابتکارات پیشنهادی — مانند پیشنهاد چین برای یک «سازمان همکاری جهانی AI» یا ایده G7 برای یک ائتلاف به رهبری آمریکا برای شکل دادن به قوانین AI — باید در مسیرهایی جدا از گفتگوهای فنی ایمنی پیش بروند. این رویکردها در حالی مطرح میشوند که برخی کشورهای عضو G7 نسبت به انحصار مدلهای پیشرفته در دستان آمریکا و احتمال قطع دسترسی جهانی هشدار دادهاند. هدف، شکل دادن به یک مجموعه قوانین جهانی AI، یک معاهده الزامآور یا هنجارهای مشترک نیست، بلکه ایجاد یک درک فنی مشترک در مورد نحوه جلوگیری از آسیبهای سیستماتیک مدلها است.
این رویکرد با ایمنی AI به عنوان یک مسئله فنی مشترک برخورد میکند، نه به عنوان یک ابزار دیپلماتیک. با تمرکز بر فهرستی کوتاه و قابل مدیریت از ریسکها و استراتژیهای کاهش فنی، ایالات متحده و چین ممکن است راهی برای همکاری بیابند، بدون اینکه منافع امنیت ملی خود را به خطر بیندازند یا وارد بازیهای خطرناک «داد و ستد» شوند.



گفتگو