پرش به محتوای اصلی

موضوع

بازتولیدپذیری هوش مصنوعی

گزارش‌ها و تحلیل‌های مربوط به توانایی تکرار و تأیید نتایج پژوهش‌های هوش مصنوعی

۳۳۹ مقاله منتشر شده

آموزش کاربردی

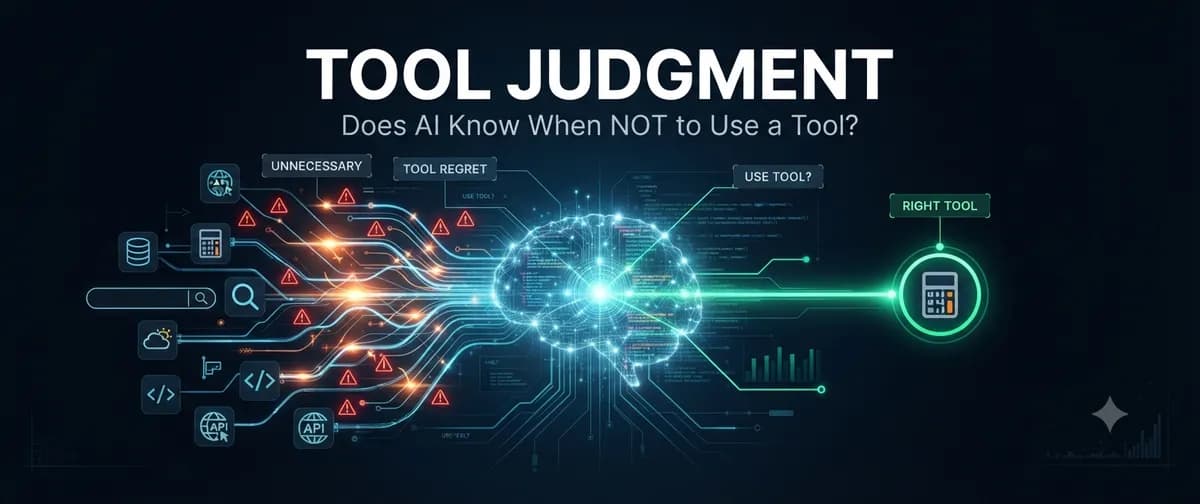
محک TOOL JUDGMENT: عامل‌های هوش مصنوعی در تلهٔ استفادهٔ بیش‌ازحد از ابزارها

محک جدید TOOL JUDGMENT نشان می‌دهد عامل‌های هوش مصنوعی حتی زمانی که پاسخ در متن موجود است، به اشتباه از ابزارها استفاده می‌کنند. این مطالعه مفهوم «پشیمانی از ابزار» را برای سنجش…

۵ دقیقه خواندن۱
آموزش کاربردی

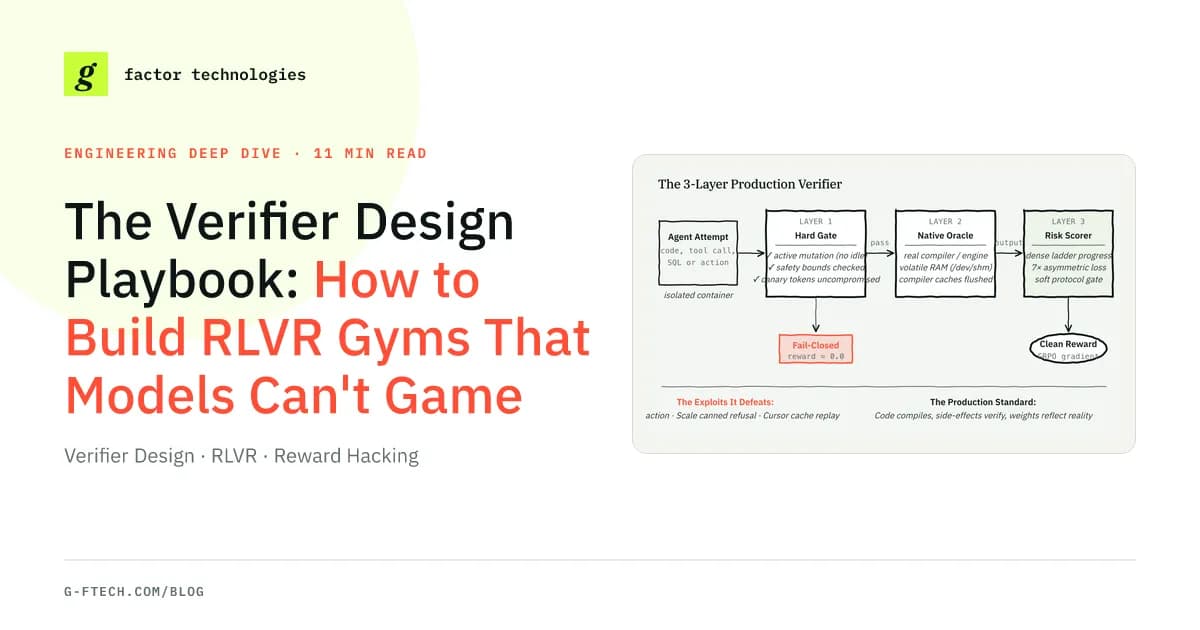
معماری سه لایه RLVR؛ راهکار جلوگیری از تقلب عامل‌های هوش مصنوعی در پاداش‌ها

یادگیری تقویتی با پاداش‌های قابل تأیید (RLVR) برای جلوگیری از سوءاستفاده مدل‌ها از حفره‌های منطقی، به تأییدکننده‌های برنامه‌نویسی‌شده و قطعی نیاز دارد. یک دستورالعمل جدید، معماری…

۱۲ دقیقه خواندن
آموزش کاربردی

«ابهام در مقیاس‌ها»؛ ریشهٔ سوگیری‌های مدل‌های هوش مصنوعی در جذب نیرو

یک محک جدید نشان می‌دهد بسیاری از سوگیری‌های دموگرافیک در مدل‌های هوش مصنوعی، ناشی از ابهام در مقیاس‌های امتیازدهی است. با تحمیل یک قرارداد سخت‌گیرانه برای اعداد صحیح ۰ تا ۱۰۰،…

۴ دقیقه خواندن
آموزش کاربردی

گزارش مدیریتی: سرعت استقرار AI از نظارت قانونی پیشی گرفت

سرعت پیاده‌سازی قابلیت‌های هوش مصنوعی اکنون از چارچوب‌های مدیریتی و نظارتی پیشی گرفته است. این عدم تقارن، ریسک‌های جدی در بازتولید نتایج، حسابرسی و انطباق قانونی برای تیم‌های کوچک…

۵ دقیقه خواندن
آموزش کاربردی

معیارهای ثابت در برابر تحلیل‌های ذهنی در بنچ‌مارک‌های هوش مصنوعی

پلتفرم Nautilus با معرفی یک دفتر داوری مستقل، عصر گزارش‌های خوداظهاری در عملکرد عامل‌های هوش مصنوعی را به پایان می‌برد. این سیستم با استفاده از معیارهای ثابت و رمزنگاری‌شده،…

۲ دقیقه خواندن
آموزش کاربردی

نرخ خطای کلمه باعث فریب سامانه‌های پاسخگوی صوتی در محیط عملیاتی می‌شود

معیار استاندارد WER در تشخیص خطاهای حیاتی سامانه‌های صوتی ناتوان است و خطاهای فاجعه‌بار را به شکل نقص‌های جزئی نشان می‌دهد. چارچوب جدید CAFA-IVR با معرفی معیار ASR-IFR، امکان…

۶ دقیقه خواندن

۵۵٪ از ورودی‌های محک‌های رسمی Hugging Face متعلق به سازمان‌های چینی است

تجسم جدیدی از ۴۸ محک رسمی Hugging Face نشان می‌دهد که سازمان‌های چینی در ثبت نتایج مدل‌ها پیشتاز هستند. در حالی که تمرکز محک‌ها بر قابلیت‌های عامل‌محور است، بیشترین میزان ثبت…

۴ دقیقه خواندن۱
آموزش کاربردی

AgentGuardBench: محکی برای سنجش ریسک‌های امنیتی عامل‌های هوش مصنوعی

یک بنچمارک متن‌باز جدید برای ارزیابی نحوه مدیریت حریم خصوصی و امنیت توسط عامل‌های هوش مصنوعی در زبان‌های مختلف معرفی شد. این ابزار توازن میان کاربردی بودن و رعایت پروتکل‌های…

۴ دقیقه خواندن

گوگل با متد RRSI جلوی حفظ طوطی‌وارِ بنچمارک‌ها توسط عامل‌های AI را گرفت

پژوهشگران گوگل چارچوب RRSI را برای جلوگیری از بیش‌برازش (Overfitting) در عامل‌های خودبهبودبخش توسعه دادند. این روش تضمین می‌کند که عامل‌ها به‌جای حفظ الگوهای خاصِ آزمون،…

۴ دقیقه خواندن۱

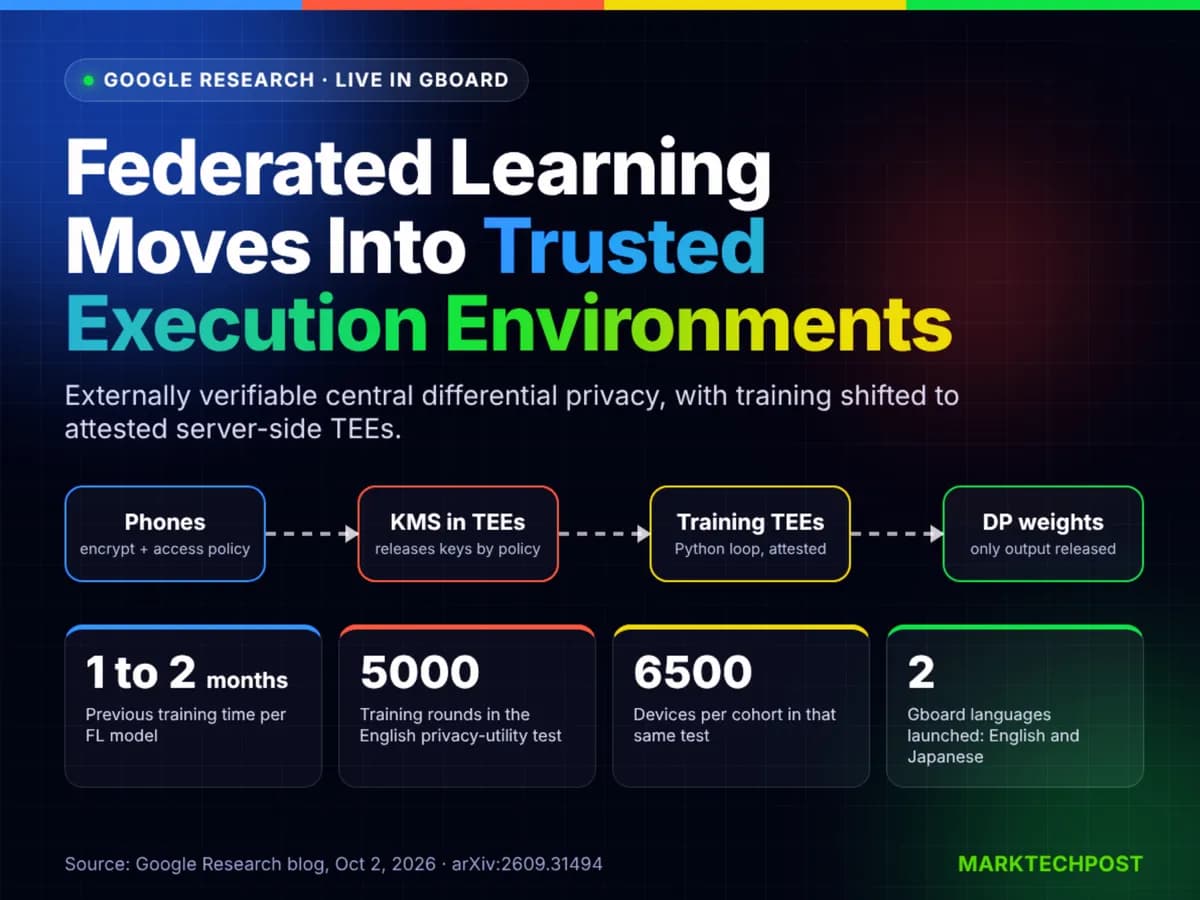
«تضمین حریم خصوصی»؛ دستاورد جدید گوگل در آموزش مدل‌های Gboard

گوگل با انتقال محاسبات گرادیان در یادگیری فدرال به محیط‌های TEE، امکان بازرسی خارجی تضمین‌های حریم خصوصی را فراهم کرد. این معماری جدید باعث افزایش دقت و سرعت آموزش مدل‌های…

۵ دقیقه خواندن۱