پرش به محتوای اصلی

موضوع

سخت‌افزار هوش مصنوعی

تراشه‌ها، پردازنده‌ها و تجهیزات فیزیکی مورد استفاده در اجرای مدل‌های هوش مصنوعی

۴۵۰ مقاله منتشر شده

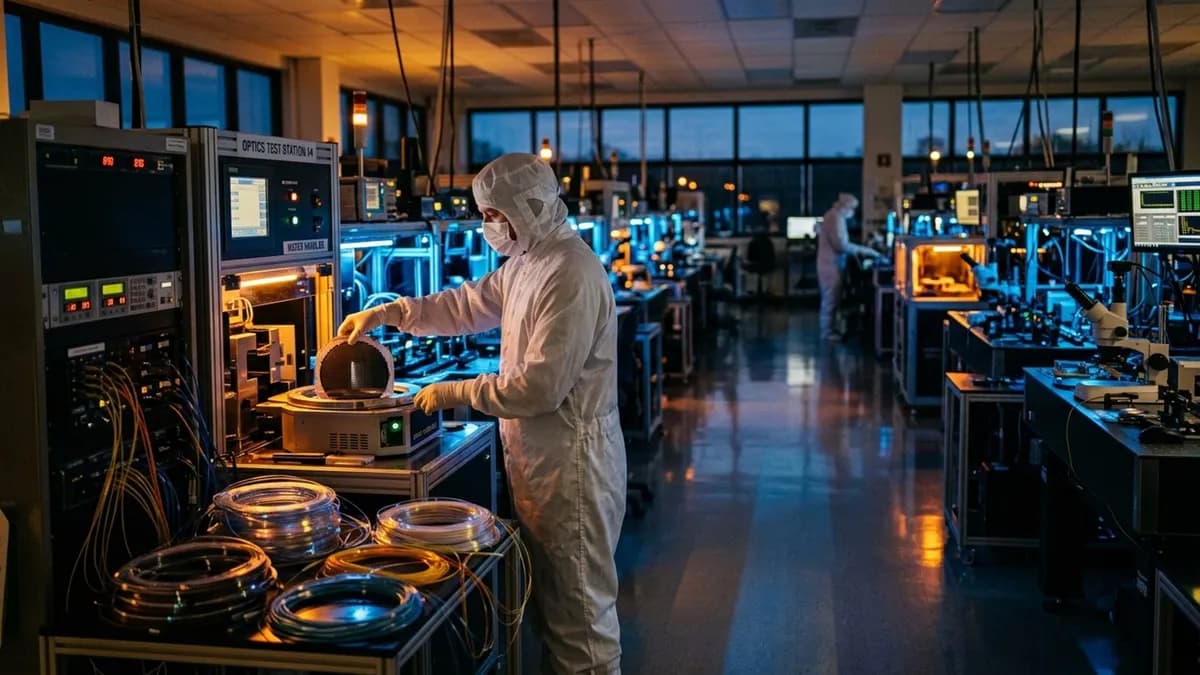
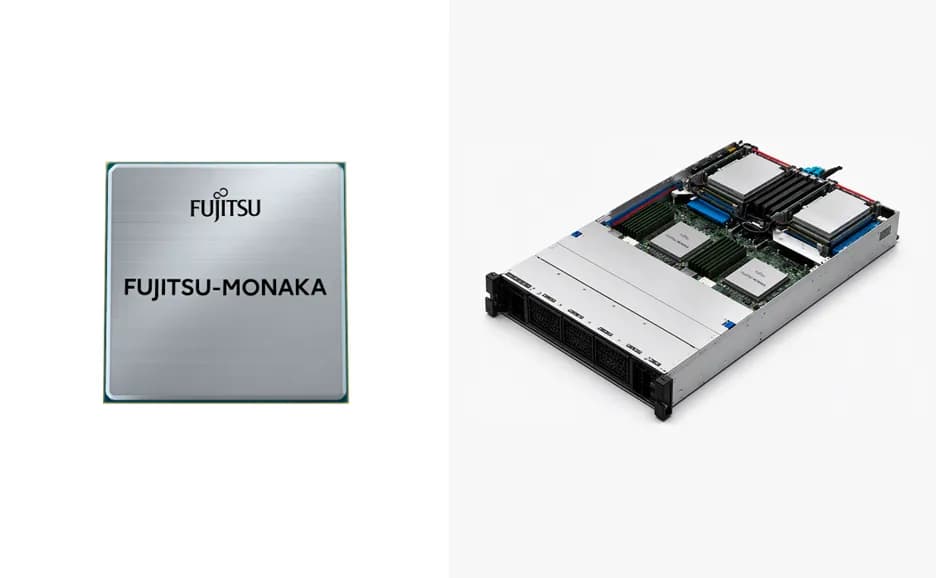
پردازنده نسل‌بعدی ژاپنی فوجیتسو-موناکا و سرور آن برای زیرساخت هوش مصنوعی بومی رونمایی شد

تراشه ۲ نانومتری MONAKA چگونه هزینه‌های زیرساختی هوش مصنوعی را می‌کاهد؟

فوجی‌تسو با معرفی پردازنده و سرور MONAKA، معماری ۳ بعدی ۲ نانومتری را برای هوش مصنوعی حاکمیتی به کار گرفت. این سیستم توان عملیاتی استنتاج را دو برابر کرده و مصرف انرژی و فضای مورد…

۶ دقیقه خواندن۱
آموزش API Groq: استنتاج سریع مدل زبانی برای توسعه‌دهندگان در ۲۰۲۶
آموزش کاربردی

«پاسخ‌دهی زیر میلی‌ثانیه»؛ قابلیت جدید API شرکت Groq برای برنامه‌های بلادرنگ

پلتفرم Groq با ارائه یک API با تأخیر بسیار پایین، استنتاج مدل‌های زبانی را به زیر یک میلی‌ثانیه رسانده است. این زیرساخت به توسعه‌دهندگان اجازه می‌دهد چت‌بات‌ها و سرویس‌های لبه‌ای…

۱ دقیقه خواندن۲
پلتفرم شبیه‌سازی صدای Treble مستقر در ایسلند ۱۸ میلیون دلار جذب سرمایه کرد | تک‌کرانچ

استارتاپ Treble با ۱۸ میلیون دلار سرمایه شبیه‌ساز فیزیکی صدا را ساخت

شرکت ایسلندی Treble برای جایگزینی داده‌های استخراج‌شده از اینترنت با شبیه‌سازی‌های آکوستیک مبتنی بر فیزیک، ۱۸ میلیون دلار جذب کرد. این پلتفرم به سازندگان سخت‌افزار و مدل‌های هوش…

۳ دقیقه خواندن۱
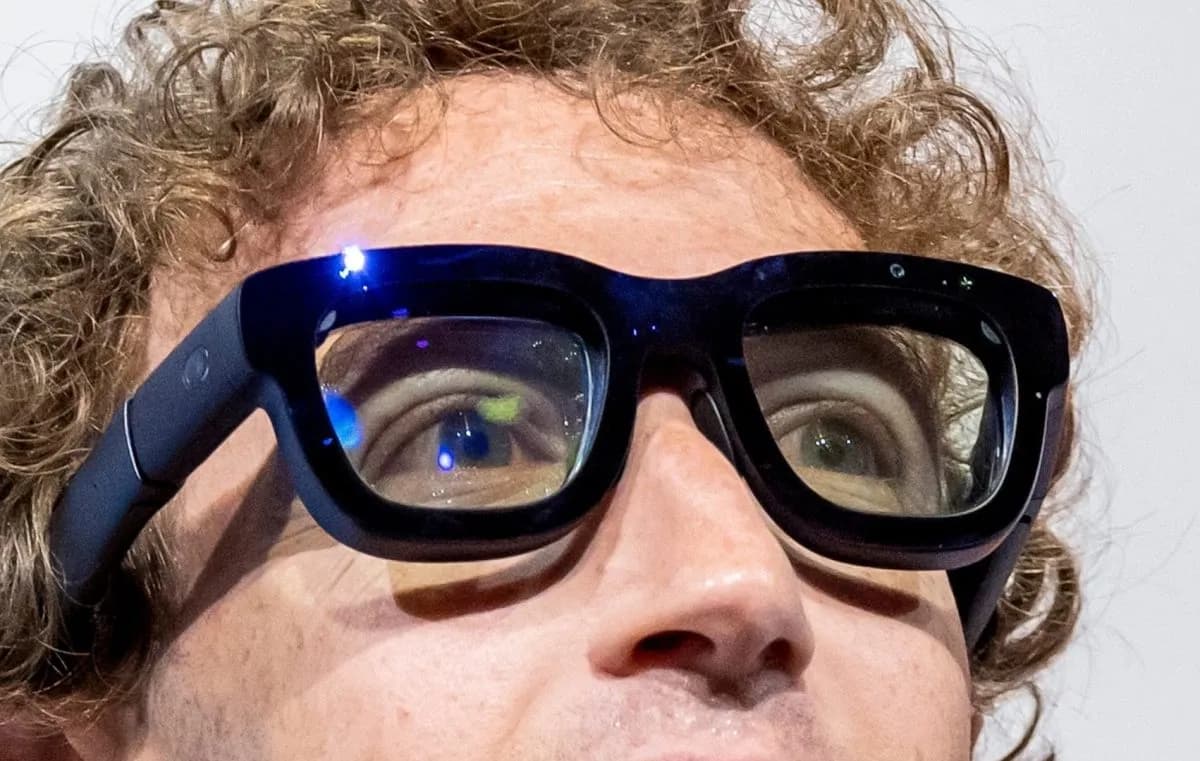
متا پس از انتقاد از فروش «عینک‌های ویژه»، نسخه بدون دوربین عرضه می‌کند

مدل Luna در برابر نسل‌های قبلی؛ اولویت حریم خصوصی بر تصویربرداری

متا برای مقابله با انتقادات مربوط به حریم خصوصی، در حال توسعه عینک هوشمند Luna است که هیچ دوربینی ندارد. این دستگاه به‌جای ثبت تصویر، بر تعاملات صوتی با هوش مصنوعی تمرکز می‌کند.

۲ دقیقه خواندن۱
اجایل ۱۵۰ میلیارد پارامتر MoE روی لپ‌تاپ توسعه‌دهنده: حداکثر سودمندی ذخیره‌سازی سریع‌تر
آموزش کاربردی

Colibrì: اجرای مدل ۱۵۰ میلیاردی روی لپ‌تاپ با ۶٪ گلوگاه ذخیره‌سازی

موتور استنتاج جدید Colibrì با استریم کردن خبره‌ها از حافظه SSD، اجرای مدل‌های عظیم ۱۵۰ میلیاردی را روی لپ‌تاپ‌های معمولی ممکن کرد. یافته‌ها نشان می‌دهد گلوگاه اصلی عملکرد، نه سرعت…

۱۶ دقیقه خواندن۴
لوگوی CetinLM با عنوان «شکستن افسانه زیرساخت میلیارد دلاری هوش مصنوعی»
آموزش کاربردی

پژوهش CetinLM: آموزش ۲ میلیارد توکن با یک پردازنده ۱۶ گیگابایتی

پژوهش جدید CetinLM ثابت کرد که پیش‌آموزش مدل‌های بنیادی لزوماً نیازمند خوشه‌های میلیاردی نیست. این تیم با بهینه‌سازی‌های سطح پایین، موفق شد بیش از ۲ میلیارد توکن را تنها با یک…

۴ دقیقه خواندن۲
آیا سرور محلی فقط برای توسعه هوش مصنوعی ارزش دارد؟ و چه زمانی هنوز زمانش نیست؟
آموزش کاربردی

تحلیل هزینه‌ها: خرید GPU برای توسعه‌دهندگان کوچک منجر به ضرر می‌شود

خرید سخت‌افزار GPU برای توسعه هوش مصنوعی به‌دلیل هزینه‌های اولیه بالا و سرعت کهنگی سریع، معمولاً منجر به کاهش هزینه‌ها نمی‌شود. برای اکثر تیم‌های کوچک، استفاده از APIهای ابری…

۴ دقیقه خواندن
شیمی‌فای ۲۲ میلیون پوند برای توسعه هوش مصنوعی شیمی و ساخت نسل بعدی آزمایشگاه‌های خود جذب کرد.

آیا ربات‌های Chemify می‌توانند طراحی مولکولی را کاملاً قابل برنامه‌ریزی کنند؟

استارتاپ Chemify با دریافت کمک‌های دولتی، زیرساخت‌های رباتیک خود را برای تبدیل طراحی مولکولی به فرآیندی قابل برنامه‌ریزی گسترش می‌دهد. هدف این شرکت پر کردن شکاف میان پیش‌بینی‌های…

۵ دقیقه خواندن
احتمال بازگشت اپل به تولید سرور برای بهره‌مندی از موج هوش مصنوعی
اخبار کوتاه روزانهگزارش تأییدنشده

اپل با فناوری انویدیا به بازار سرورهای هوش مصنوعی بازمی‌گردد

اپل قصد دارد تا سال ۲۰۲۹ با ترکیب تراشه‌های سری M و فناوری اتصال انویدیا، دوباره وارد بازار سرور شود. این استراتژی برای تأمین نیازهای عظیم محاسباتی عصر هوش مصنوعی طراحی شده است.

۲ دقیقه خواندن۲
نتایج اولیه MLPerf Inference برای سیستم NVIDIA Vera Rubin NVL72

سیستم Vera Rubin انویدیا توان عملیاتی استنتاج را ۳.۷ برابر افزایش داد

انویدیا با معرفی سیستم Vera Rubin NVL72، سقف عملکرد استنتاج در مدل‌های بینایی-زبانی را جابه‌جا کرد. این جهش خیره‌کننده نتیجه‌ی رویکرد «طراحی مشترک سخت‌افزار و نرم‌افزار» برای کاهش…

۴ دقیقه خواندن۱