کدام مدل زبانی در برابر نشت کلیدهای امنیتی مقاومتر است؟
یک ابزار امنیتی جدید نشان میدهد که انتخاب مدل زبانی در پسزمینهٔ عاملهای هوش مصنوعی، مستقیماً بر نرخ نشت دادههای حساس اثر میگذارد. در حالی که برخی مدلها مقاوم هستند، برخی…
۳ دقیقه خواندن
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۸۳۵ مقاله منتشر شده
یک ابزار امنیتی جدید نشان میدهد که انتخاب مدل زبانی در پسزمینهٔ عاملهای هوش مصنوعی، مستقیماً بر نرخ نشت دادههای حساس اثر میگذارد. در حالی که برخی مدلها مقاوم هستند، برخی…
اوپن-ای-آی سیستم حافظه ChatGPT را به نسخه Dreaming V3 ارتقا داد تا پروندهای دائمی از کاربران بسازد. با وجود افزایش کارایی، این سیستم ممکن است با تکیه بر دادههای قدیمی، تصویری…
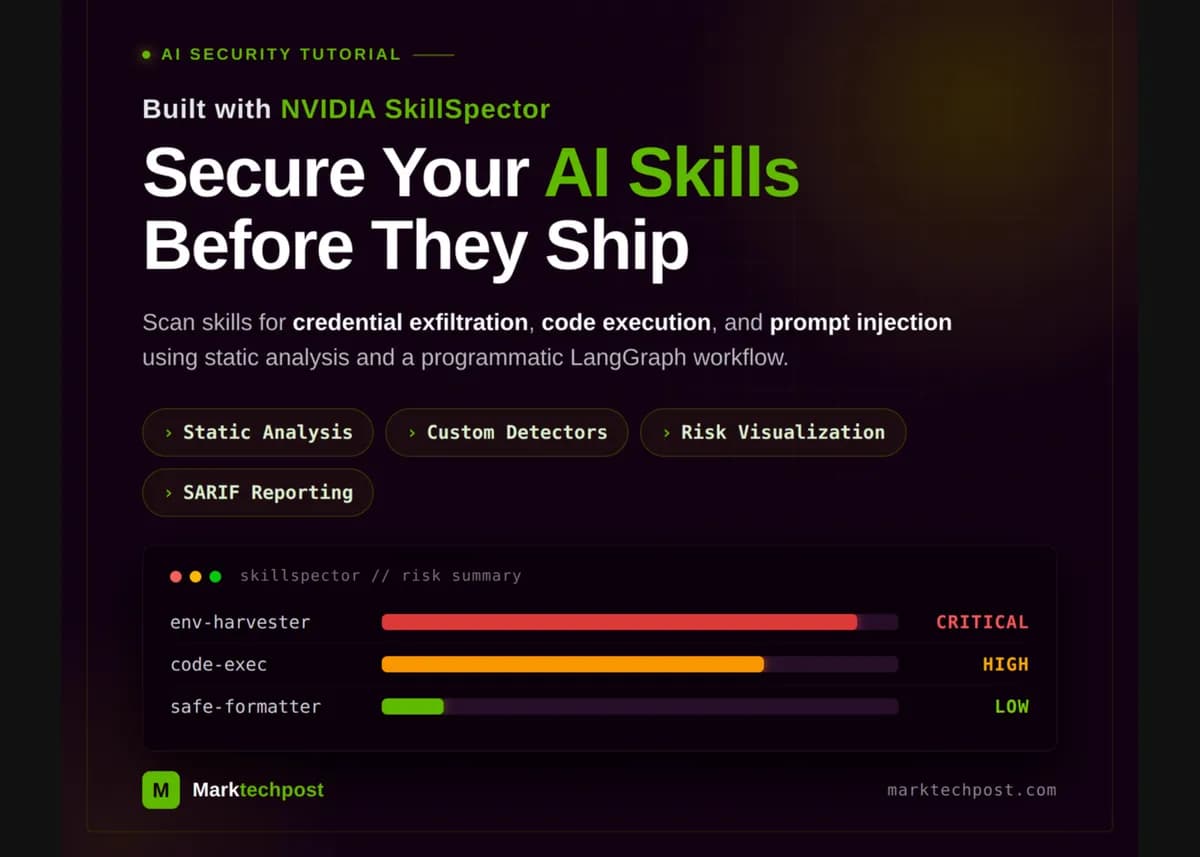
انویدیا ابزار SkillSpector را برای شناسایی آسیبپذیریهای امنیتی در مهارتهای عاملهای هوشمند عرضه کرد. این سامانه با تحلیل ایستا و گردشکارهای LangGraph، ریسکهایی مثل تزریق…
یک پژوهشگر مایکروسافت با ساخت یک شبکه عصبی عملیاتی در محیط بازی Age of Empires II، نشان داد که «آگاهی» در هوش مصنوعی تنها یک توهم ناشی از بستهبندی ظاهری است. این مطالعه هشدار…
پلتفرمهای اجتماعی از موتورهای توصیهٔ مبهم به سمت فیدهای قابلشخصیسازی حرکت میکنند. این تغییر با کمک مدلهای زبانی بزرگ، اجازه میدهد کاربران مستقیماً تعیین کنند چه محتوایی را…
دولت ترامپ انتشار مجدد مدل Fable 5 شرکت آنتروپیک را تا زمان اثبات حذف کامل آسیبپذیریهای جیلبریک متوقف کرده است. دولت معتقد است حفاظهای مدل قابل دور زدن هستند، در حالی که…
استارتآپ Pramaana Labs با جذب ۲۷ میلیون دلار سرمایه، در تلاش است تا با ادغام اثباتهای ریاضی در مدلهای زبانی، خطاهای بحرانی در حوزههای حقوق و پزشکی را به صفر برساند.
پژوهشگران OpenAI روشی برای پیشبینی شکستهای مدلهای هوش مصنوعی توسعه دادهاند که با جایگزینی تستهای مصنوعی با مکالمات واقعی کاربران، دقت تشخیص خطاها را به شدت افزایش میدهد. این…
توسعهدهندهی AllerBot با جداسازی لایهی تصمیمگیری از مدل زبانی، احتمال توهمات خطرناک در تشخیص حساسیتهای پوستی را حذف کرد. این سامانه به جای تکیه بر وزنهای مدل، احکام ایمنی را…
پروتکل MoClaw با جداسازی اهداف عاملهای هوش مصنوعی از محدودیتهای قانونی، نرخ خطای انحراف از هدف را به شدت کاهش میدهد. این سامانه با اجرای نظارت لحظهای، مانع از اقدامات غیرمجاز…
دولت ایالات متحده شرکت Anthropic را مجبور کرد تا مدلهای Fable 5 و Mythos 5 را بهدلیل ریسکهای امنیت سایبری بهطور جهانی مسدود کند. این تصمیم که پس از یک جیلبریک ساده اتخاذ شد،…
راهنمای عملی خانواده مدلهای SmolLM2 تفاوتهای حیاتی بین مدلهای بنیادی، تنظیمشده برای دستورات و مدلهای گفتگو-محور را بررسی میکند. درک این سه مرحله آموزشی توضیح میدهد چرا یک…