پرش به محتوای اصلی

موضوع

بازیابی‌افزا

RAG architectures, vector stores, grounding LLMs in private data

۱٬۱۱۲ مقاله منتشر شده

راهنمای جامع تولید مکمل بازیابی‌شده (RAG) و کاربردهای آن در هوش مصنوعی ۲۰۲۶
آموزش کاربردی

جست‌وجوی زنده در برابر حافظه ایستا؛ راهکار RAG برای توقف توهمات

معماری RAG با اتصال مدل‌های زبانی به پایگاه‌های داده خارجی، نیاز به بازآموزی گران‌قیمت مدل‌ها را حذف می‌کند. این رویکرد با جایگزینی حافظه ایستا با جست‌وجوی زنده، نرخ توهم در…

۵ دقیقه خواندن
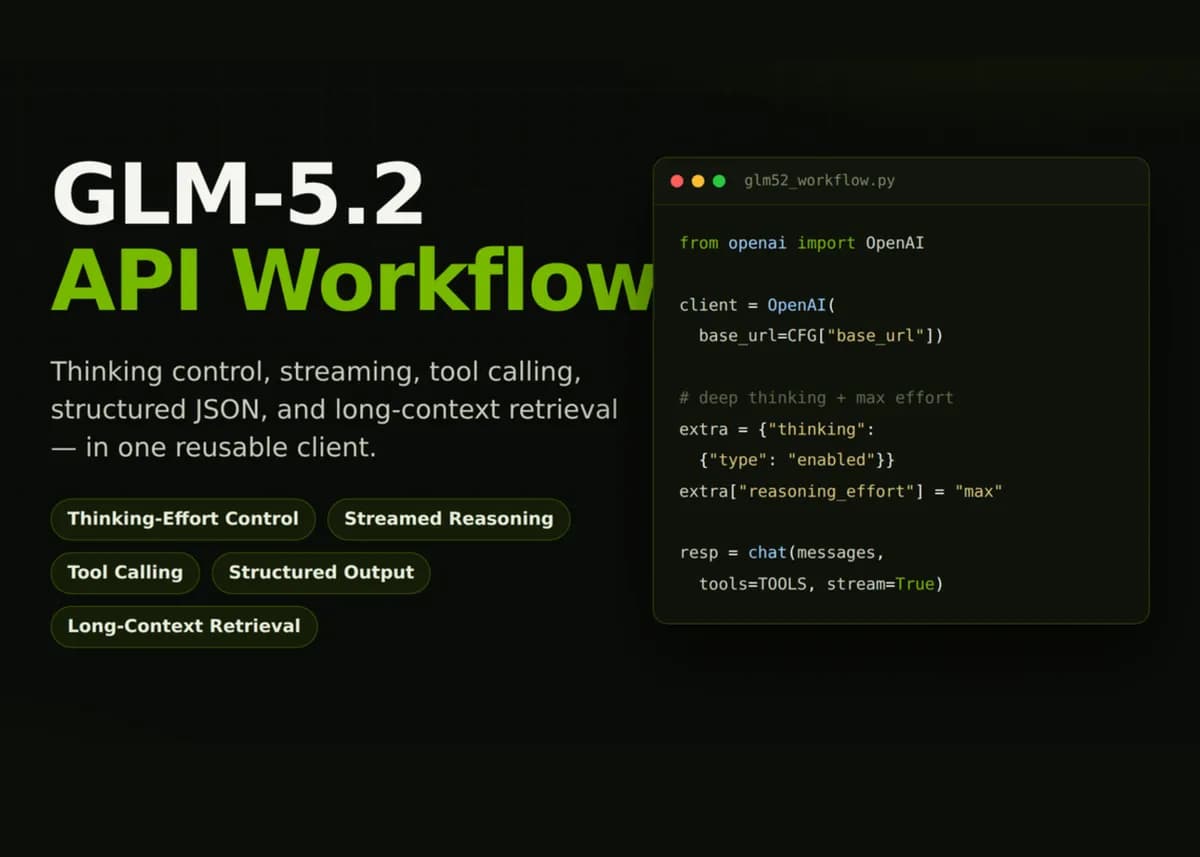
راهنمای عملی API سازگار با OpenAI در GLM-5.2: تلاش استدلالی، فراخوانی تابع و بازیابی متن طولانی
آموزش کاربردی

راهنمای عملی GLM-5.2: ادغام سه قابلیت کلیدی در جریان‌های کاری پایتون

راهنمای عملی جدیدی نحوه ادغام مدل GLM-5.2 در جریان‌های کاری پایتون را با استفاده از APIهای سازگار با OpenAI نشان می‌دهد. این پیاده‌سازی بر کنترل دقیق تلاش استدلالی، فراخوانی تابع…

۹ دقیقه خواندن
چرا Perplexity AI در حال تبدیل شدن به ابزار تحقیقاتی مورد علاقه من است
زندگی با AI

Perplexity AI چرخه جست‌وجوی سنتی گوگل را با پاسخ‌های مستقیم جایگزین می‌کند

تغییر رویکرد به سمت جست‌وجوی مبتنی بر هوش مصنوعی، نیاز به باز کردن تب‌های متعدد مرورگر را کاهش داده است. این روند باعث می‌شود اعتبار محتوا و تخصص نویسندگان، بیش از پیش برای جذب…

۲ دقیقه خواندن
راهنمای فنی ساخت سیستم‌های توصیه‌گر مبتنی بر مدل‌های زبانی بزرگ
آموزش کاربردی

سیستم‌های توصیه‌گر سبک با مدل‌های زبانی بدون نیاز به خط لوله بردار معنایی

یک راهنمای فنی جدید روشی را معرفی می‌کند که در آن مدل‌های زبانی برای رتبه‌بندی محصولات و ارائه پیشنهادات قابل‌توضیح استفاده می‌شوند. این رویکرد نیاز به مدل‌های پیچیده فیلترینگ…

۴ دقیقه خواندن۲
موتور تولید تیتر خبری پرسرعت: راهنمای سازندگان هوش مصنوعی
آموزش کاربردی

پایپ‌لاین MelodicMind استخراج داده‌های خبری را به ثانیه‌ها کاهش داد

عامل هوشمند MelodicMind معماری جدیدی برای جایگزینی کیوریتوری دستی اخبار با یک خط لوله خودکار معرفی کرد. این سیستم با استفاده از جست‌وجوی معنایی، نویز داده‌ها را حذف کرده و اطلاعات…

۶ دقیقه خواندن
سیناپس ردیت-ویکی‌پدیا: طراحی خطوط پردازش RAG با کیفیت بالا
آموزش کاربردی

ترکیب ردیت و ویکی‌پدیا؛ راهکار جدید برای حذف توهم در مدل‌های زبانی

یک خط لوله معماری جدید با ترکیب داده‌های لحظه‌ای ردیت و حقایق تأییدشده ویکی‌پدیا، مشکل مبنی‌سازی در مدل‌های زبانی را حل می‌کند. این سیستم هیبریدی RAG با متصل کردن سیگنال‌های…

۶ دقیقه خواندن
میز کمک هوش مصنوعی: چگونه از پاسخ تکراری هوش مصنوعی به یک سوال جلوگیری کنیم
آموزش کاربردی

چگونه حافظهٔ معنایی تأخیر در پاسخگویی مدل‌های زبانی را می‌گیرد؟

پیاده‌سازی لایه‌های مختلف حافظه موقت (Cache) از پاسخ‌های تکراری مدل‌های زبانی جلوگیری می‌کند. استفاده از حافظه معنایی، هزینه‌های API و تأخیر در پاسخگویی به پرسش‌های مشابه را…

۱۳ دقیقه خواندن