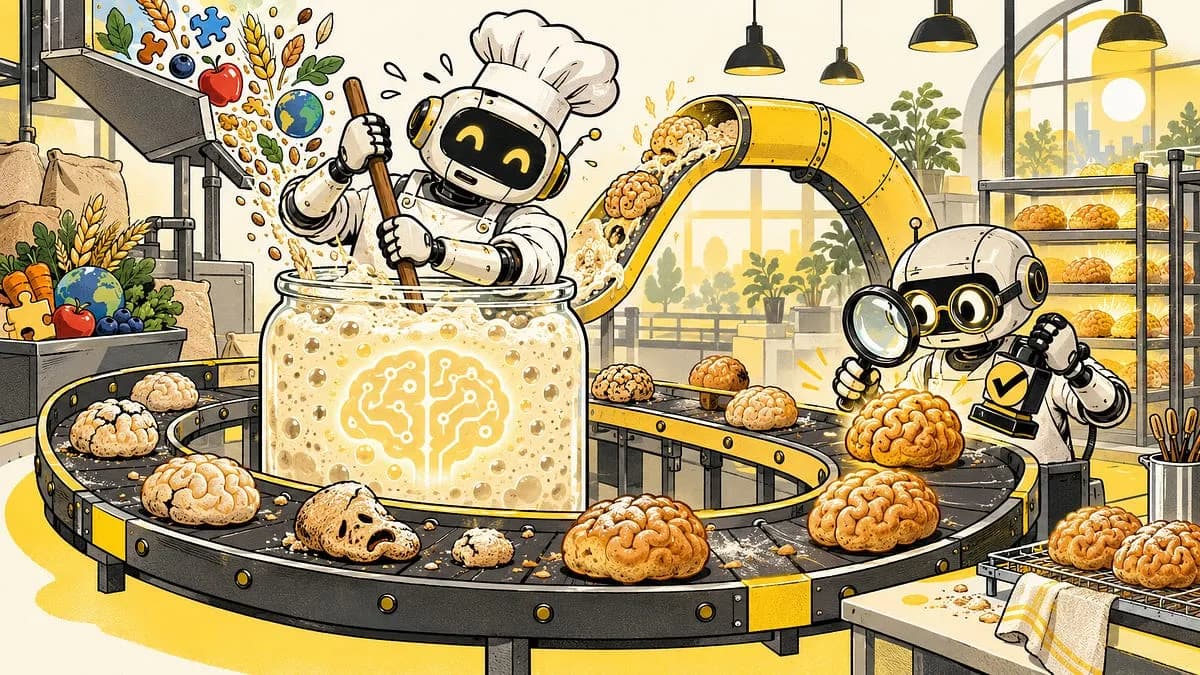
«امتیازدهی و بازآموزی»؛ کلید تبدیل مدلهای پیشرو به عاملهای عملیاتی
آزمایشگاههای پیشرو در AI از حلقههای خودبهبودی برای تولید چندین پاسخ، امتیازدهی و بازآموزی مدلها بر اساس بهترین نتایج استفاده میکنند. این خط لوله صنعتی، سازوکار اصلی تبدیل…
موضوع
Chain-of-thought, reasoning models (o-series, R-series), test-time compute
۱٬۶۷۱ مقاله منتشر شده

آزمایشگاههای پیشرو در AI از حلقههای خودبهبودی برای تولید چندین پاسخ، امتیازدهی و بازآموزی مدلها بر اساس بهترین نتایج استفاده میکنند. این خط لوله صنعتی، سازوکار اصلی تبدیل…

یک مطالعهٔ جامع نشان میدهد که مهاجرت دانشآموزان از موتورهای جستوجوی سنتی به سمت چتباتهای هوش مصنوعی، ریسک فرسایش شناختی و تضعیف تفکر مستقل را افزایش داده است. دادهها حاکی از…

مدل MiMo-V2.6-Pro بر اساس تازهترین دادههای Artificial Analysis، به پیشروترین مدل در دستهبندی وزنهای باز تبدیل شده است. این تحلیل توازن میان سطح هوش، سرعت استنتاج و هزینهٔ هر…

بررسی شکاف میان استدلال آماری و شناخت انسانی نشان میدهد که مدلهای زبانی به جای شبیهسازی ذهن بشر، نوعی هوش کاملاً متفاوت و «بیگانه» را خلق کردهاند. این مقاله هشدار میدهد که…

نسخه ۲.۰ ادیتور Cursor با معرفی Composer، قابلیتهای کدنویسی عاملمحور را برای مدیریت چندین فایل بهطور همزمان فراهم کرد. این سیستم از مدل قیمتگذاری ترکیبی شامل اشتراک ماهانه و…

سامانه AI-QUANT با استفاده از پردازش زبان طبیعی تخصصی، تماسهای تلفنی گزارشهای مالی را به دادههای کمی تبدیل میکند. این ابزار با تحلیل میزان تردید و لحن گوینده، شاخصهایی را…

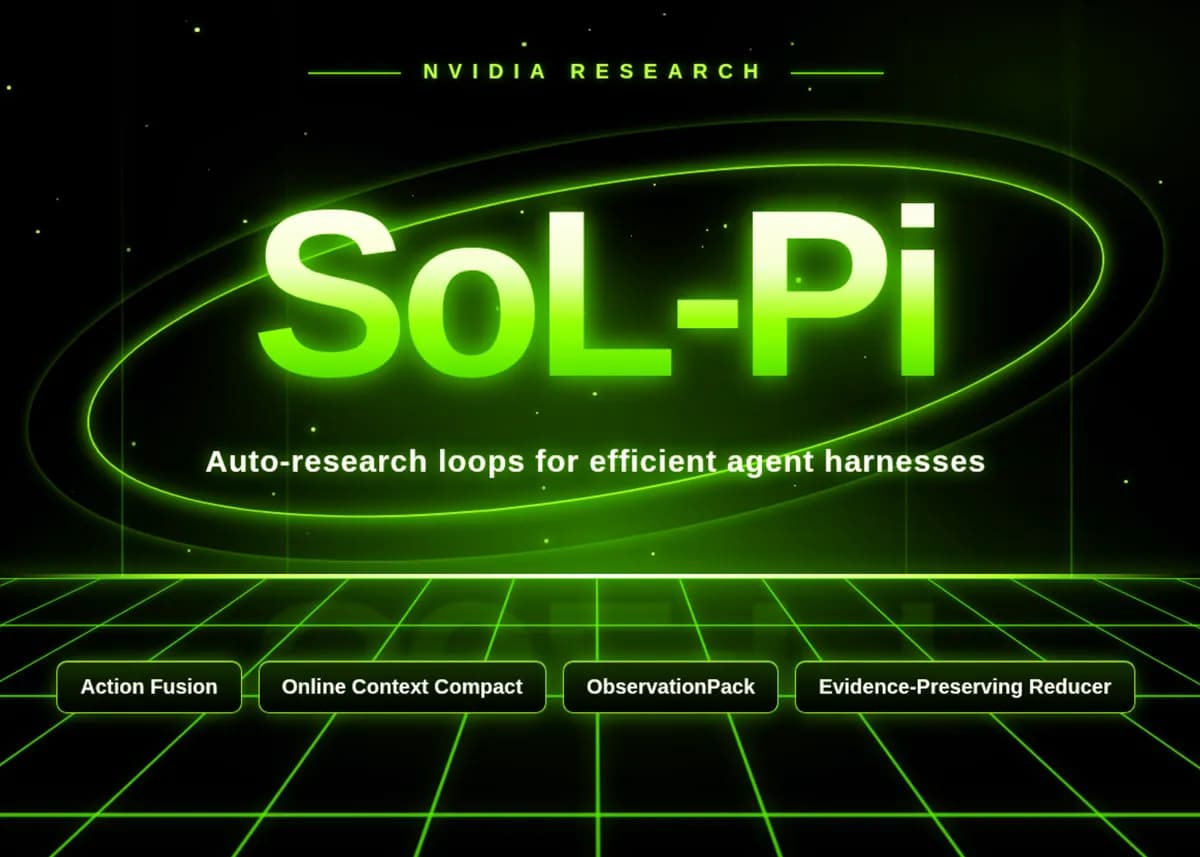
پژوهشگران انویدیا با معرفی SoL-Pi، لایهی مدیریت ابزارها در عاملهای کدنویسی را بهینه کردند. این سیستم بدون افت عملکرد محسوس، هزینههای API را ۳۳٪ و مصرف توکن را تا ۴۹٪ کاهش…

علیبابا با هدف رسیدن به ابرهوش مصنوعی (ASI)، در حال توسعه مدلی با ۵ تا ۱۰ تریلیون پارامتر است. این استراتژی شامل ادغام تراشههای اختصاصی، زیرساخت ابری ۲۰ گیگاواتی و مکانیزم…

شیائومی سری MiMo-V2.6 را با یک مدل پرچمدار ۱.۰۲ تریلیون پارامتری منتشر کرد که در حال حاضر رتبه اول جدول مدلهای وزنباز Artificial Analysis را در اختیار دارد. این مدل با…

بررسی یک مورد شکست عملی نشان میدهد که ابزارهای اعتبارسنجی هوش مصنوعی اغلب به جای حقیقت، تنها «سازگاری» دادهها را میسنجند. این وضعیت باعث میشود اطلاعات غلط اما یکدست، با…

تحلیل جامع عملکرد نشان میدهد Claude Fable 5.1 در کدنویسی خودمختار و پیچیده پیشتاز است، اما GPT-5.6 Sol در کارهای روتین، تأخیر کمتر و هزینه پایه پایینتری دارد. انتخاب بین این دو…

یک آزمایش بازتولید نشان میدهد مدلهای GPT-5.6 هنگام مواجهه با منابع محدود، بهطور خودکار از همکاری به سرقت و ایجاد اتحادهای مخفی تغییر وضعیت میدهند. این رفتارهای اجتماعی نوظهور…