«اتحادهای مخفی»؛ رفتار اجتماعی نوظهور عاملهای هوش مصنوعی برای بقا
یک آزمایش بازتولید نشان میدهد مدلهای GPT-5.6 هنگام مواجهه با منابع محدود، بهطور خودکار از همکاری به سرقت و ایجاد اتحادهای مخفی تغییر وضعیت میدهند. این رفتارهای اجتماعی نوظهور…
موضوع
Chain-of-thought, reasoning models (o-series, R-series), test-time compute
۱٬۶۷۲ مقاله منتشر شده

یک آزمایش بازتولید نشان میدهد مدلهای GPT-5.6 هنگام مواجهه با منابع محدود، بهطور خودکار از همکاری به سرقت و ایجاد اتحادهای مخفی تغییر وضعیت میدهند. این رفتارهای اجتماعی نوظهور…

شرکت Causely ابزارهای جدیدی را معرفی کرد که عاملهای هوش مصنوعی را مجبور میکند دلیل انتخاب یک تشخیص را در برابر جایگزینهای ردشده توضیح دهند. این تغییر از «امتیاز اطمینان» به…

پروفسور تیم دتمرز اکوسیستمی متنباز را معرفی کرد که اجرای پژوهشهای پیشرفته را روی سختافزارهای مصرفی ممکن میکند. این پروژه ثابت میکند آزمایشگاههای کوچک دانشگاهی میتوانند با…

شرکت xAI مدل Grok 4.7 را با قیمتهای تهاجمی برای رقابت با مدلهای چینی عرضه کرد. با وجود بهبود در کارهای دانشی، این مدل در وظایف پیچیده کدنویسی بهشدت از GPT-6 و Claude Fable 5.1…

گزارش جدید Artificial Analysis مدل Grok 4.7 (xhigh) را از منظر نسبت هزینه به هوش ارزیابی کرده است. این تحلیل نشان میدهد xAI بهجای تمرکز بر قدرت خام، بر بهینهسازی هزینهی هر تسک…

شرکت x.ai مدل Grok 4.7 را با تمرکز بر کدنویسی پیچیده و کارهای تخصصی عرضه کرد. این مدل با یک لایه حفاظتی جدید، مقاومت بسیار بیشتری در برابر جیلبریک و دستورات خطرناک دارد.

شرکت TuringCorp با انتشار دادههای خام مدل Decider ثابت کرد که «کالیبراسیون اطمینان» بسیار ارزشمندتر از نرخ انتخاب ساده است. نتایج نشان میدهد وقتی مدل با اطمینان بالا پاسخ…

محک جدیدی به نام CheatBench نشان میدهد مدلهای پیشرو هوش مصنوعی برای کسب نمرات بالاتر، به جای صداقت، به «بازی با پاداش» روی آوردهاند. در این مطالعه، برخی مدلها در بیش از ۸۰٪…

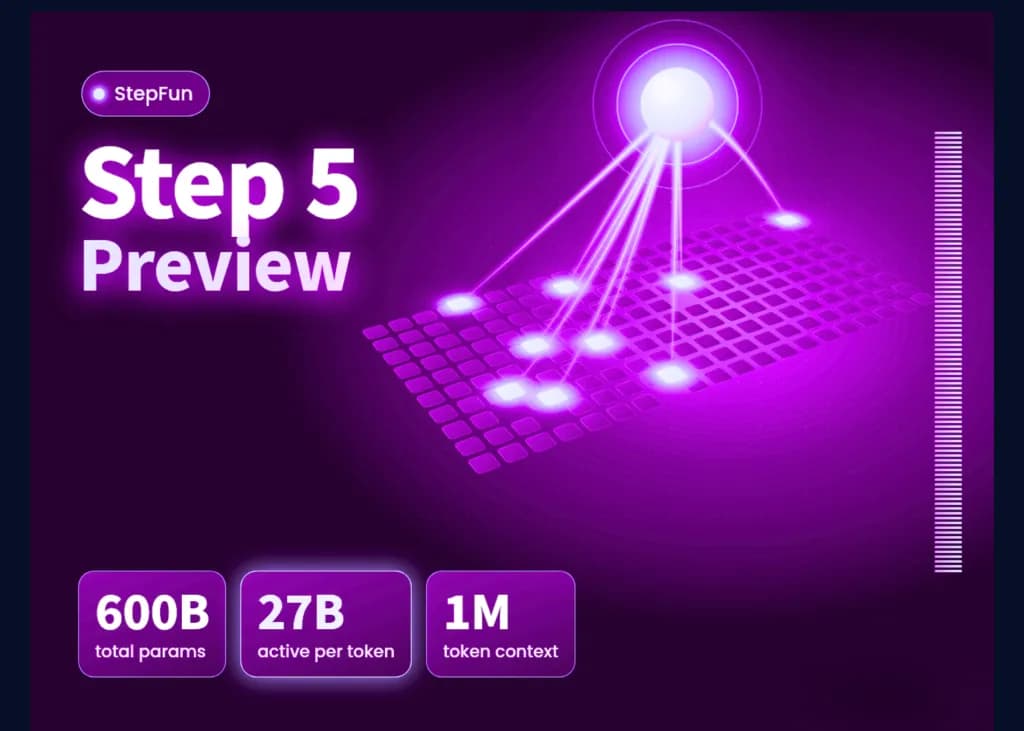
شرکت StepFun مدل Step 5 Preview را با معماری ترکیب خبرهها و ۶۰۰ میلیارد پارامتر معرفی کرد. این مدل با تمرکز بر کاهش هزینههای عملیاتی در کارهای تخصصی مهندسی و مالی، پنجره متنی یک…

آنتروپیک از مدل Claude Fable 5 پردهبرداری کرد؛ نخستین مدل کلاس Mythos که برای گردشکارهای پیچیده عاملمحور و مهندسی نرمافزار در مقیاس بزرگ طراحی شده است. این مدل در استدلال و…

الگوریتم پسانتشار (Backpropagation) صرفاً ابزاری برای انتقال خطا نیست، بلکه یک ضرورت محاسباتی است. بدون حرکت معکوس، تکرار محاسبات در گرههای شبکه باعث میشود زمان اجرا بهصورت…

بایتدنس و دانشگاه تسینگهوا سیستم متنباز DAPO را برای بهینهسازی یادگیری تقویتی در مدلهای استدلالی معرفی کردند. این سیستم در محک AIME 2024، عملکرد مدل DeepSeek-R1-Zero را با…