ویجای پاند روی ۵ شرکت بیوتکنولوژی در سال شرطبندی کرد
ویجای پاند، شریک سابق a16z، با تأسیس VZVC از مدل سرمایهگذاری انبوه فاصله گرفت تا روی تعداد محدودی شرکت با پیشبینیهای دقیق متمرکز شود. او معتقد است هوش مصنوعی در حال تبدیل…
۹ دقیقه خواندن
موضوع
دادههای تولیدشده به صورت مصنوعی با استفاده از الگوریتمهای هوش مصنوعی برای آموزش مدلها و حفظ حریم خصوصی
۱۴۲ مقاله منتشر شده
ویجای پاند، شریک سابق a16z، با تأسیس VZVC از مدل سرمایهگذاری انبوه فاصله گرفت تا روی تعداد محدودی شرکت با پیشبینیهای دقیق متمرکز شود. او معتقد است هوش مصنوعی در حال تبدیل…
پژوهشگران هوش مصنوعی بهدلیل اتمام متون باکیفیت انسانی با «دیوار داده» مواجه شدهاند. برای عبور از این بنبست، تیمهای مهندسی به دادههای مصنوعی روی آوردهاند، اما نبودِ بذرهای…
پروژه LAION یک مجموعه داده باز به نام LAION-BVD شامل ۸۰ میلیون ویدیو و ۱.۳ میلیارد URL منتشر کرد. این اقدام با هدف شکستن انحصار غولهای فناوری بر دادههای آموزشی مقیاسبزرگ برای…
استارتاپ Linum با جایگزینی فیلترهای ارزانقیمت CPU با سیستمهای شتابیافته GPU و یادگیری تقویتی (RLVR)، نویز دادههای پیشآموزش را حذف کرد. این چرخش راهبردی باعث شد مدلهای تولید…
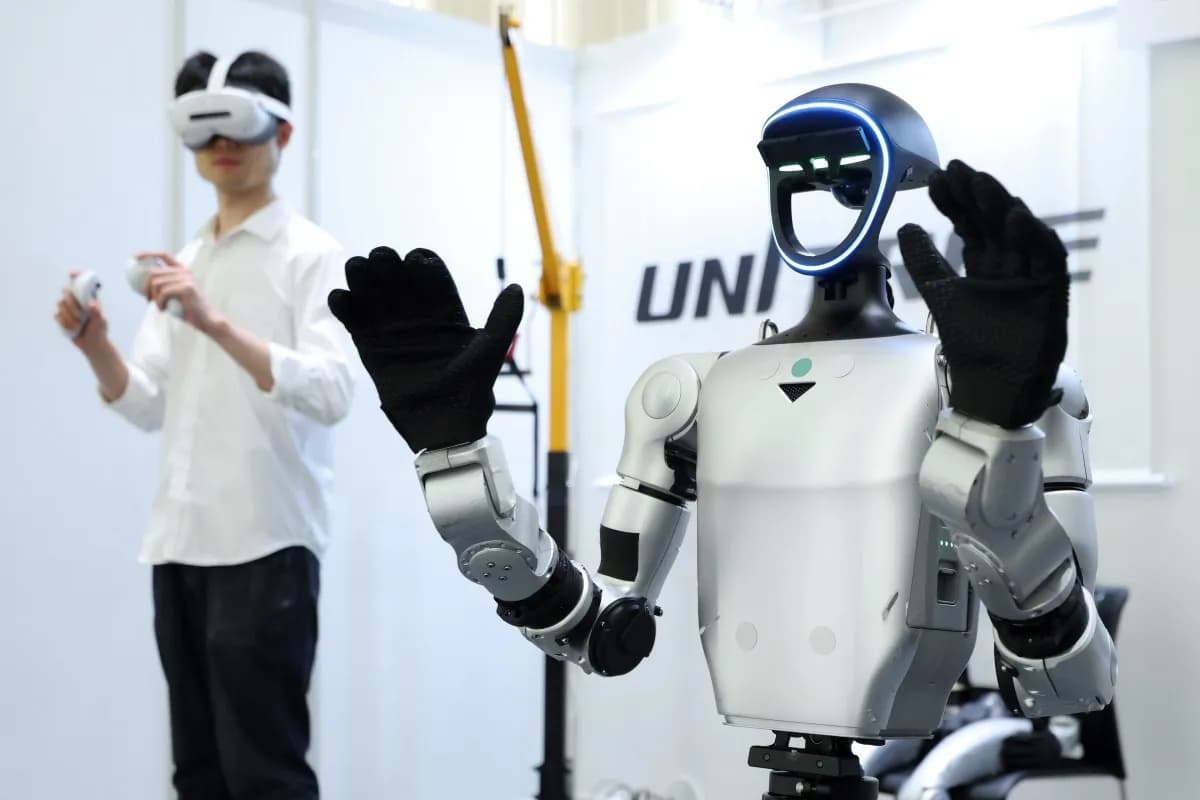
ارزش بازار Unitree، پیشرو رباتیک چین، پس از عرضه اولیه سهام تقریباً نصف شد. سرمایهگذاران دریافتهاند که هوش مصنوعی فیزیکی برای انجام کارهای سودآور، با کمبود شدید دادههای آموزشی…
آیبیام دو مدل فشرده برای بازشناسی گفتار منتشر کرد که سرعت پردازش آنها ۱۲ هزار برابر بیشتر از زمان واقعی است. این مدلها با حذف کامل لایه زبانی، توان عملیاتی عظیمی را برای…
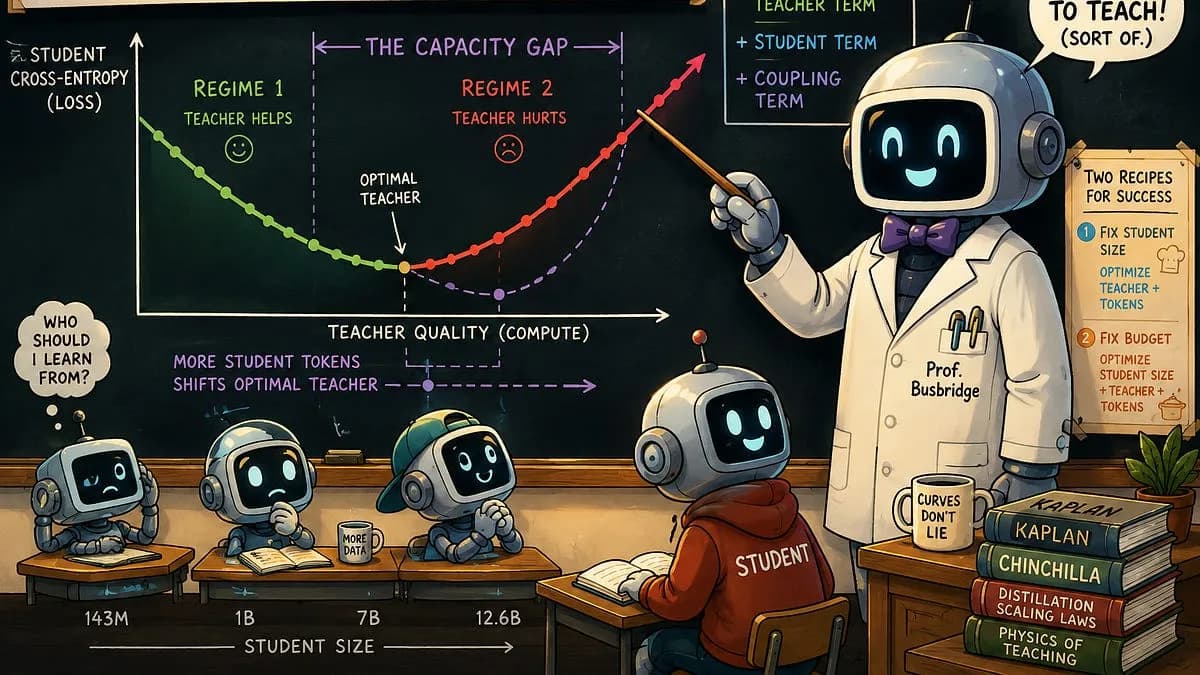
پژوهشگران اپل نخستین قوانین مقیاسپذیری پیشبینیپذیر برای تقطیر دانش را تدوین کردند. این دستاورد، آموزش مدلهای کوچک را از یک فرآیند آزمون و خطا به یک مسئله بهینهسازی ریاضی دقیق…
انتقال پرسشهای پیچیده از تالارهای گفتگو به محیطهای خصوصی هوش مصنوعی، باعث ایجاد «وارونگی دانش» شده است. این روند استدلالهای سطح بالا را در سیلوهای شرکتی حبس کرده و وب را با…
یک چارچوب معماری جدید برای خدمات مشتریان، با استفاده از «درگاههای بازبینی» و دادههای مصنوعی، از نشت اطلاعات شناسایی شخصی (PII) جلوگیری میکند. این روش اجازه میدهد شرکتها بدون…
شرکت Harvey پیشنمایش پژوهشی مدل Tenet را معرفی کرد که با بهینهسازی روی Kimi K3 و استفاده از یادگیری تقویتی، توانایی عاملهای هوش مصنوعی در مدیریت پروندههای پیچیده حقوقی را دو…

گزارشی جدید نشان میدهد بیش از یکسوم صفحات وب منتشرشده پس از عرضه ChatGPT، توسط هوش مصنوعی تولید یا ویرایش شدهاند. این روند در دامنههای .com بسیار شدیدتر است و نشان از تبدیل…

ریچارد ساتون، پیشگام یادگیری تقویتی، استدلال میکند که دادههای مصنوعی نمیتوانند گلوگاه مقیاسپذیری مدلهای زبانی را حل کنند زیرا جهان واقعی بینهایت پیچیدهتر از هر شبیهسازی…