تصور کنید یک لپتاپ معمولی با ۸ گیگابایت حافظه گرافیکی (VRAM)، حالا میتواند مدل زبانیای را از صفر آموزش دهد که هرگز یادگیریاش متوقف نمیشود. طبق اعلام توسعهدهندگان در ۲۱ سپتامبر ۲۰۲۶، مدل mini-AGI یک مدل آزمایشی در سطح بایت (byte-level) است که ثابت کرد یادگیری مستمر از یک جریان دادهای واحد، بدون فروپاشی دانش قبلی و روی سختافزارهای متواضعانه امکانپذیر است.
بیشتر مدلهای هوش مصنوعی امروز، عکسهایی منجمد از یک لحظه خاص هستند. شما میتوانید آنها را تنظیم دقیق (Fine-tuning) — مثل وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — کنید، اما نمیتوانید یک مدل را واقعاً از صفر روی کامپیوتر خانه بسازید، یا آن را با فعالیتهای روزمره بهروز نگه دارید بدون اینکه هر چه قبلاً یاد گرفته بود فراموش کند. این موضوع باعث شده مدلهای «شخصی»، در واقع مدلهای شرکتی باشند که لایه نازکی از دادههای کاربر روی آنها کشیده شده است. در واقع، لحظهای که یک مدل عرضه میشود، یادگیری آن متوقف میگردد.
mini-AGI این معادله را تغییر میدهد؛ چراکه خواندن و آموزش را یک اتفاق واحد میبیند. در اینجا خبری از فاز جداگانه برای تنظیم دقیق یا یک مدل پایه منجمد نیست. مدل تکههای متن را یک به یک میخواند، روی هر تکه یک گام گرادیان (gradient step) برمیدارد و از همان مسیر برای تولید متن استفاده میکند. این مدل به گونهای طراحی شده است که آموزش هرگز نباید متوقف شود و مدل واقعاً متعلق به شما باشد؛ یعنی روی سختافزار شما و با دادههای شما آموزش ببیند.
عبور از گلوگاه حافظه VRAM
آموزش مدلها به دلیل نیاز به گرادیانها و وضعیتهای بهینهساز (optimizer states)، به حافظهای بسیار بیشتر از استنتاج (Inference) — لحظهای که مدل واقعاً جواب تولید میکند، شبیه خودِ آشپزی نه دورهی آموزش آشپز — نیاز دارد. به طور معمول، این موارد حدود سه برابر حافظه نسبت به خودِ وزنها میطلبند. برای جای دادن مدل در یک کارت ۸ گیگابایتی، mini-AGI به جای کوانتش (quantization)، از یک سیستم صفحهبندی (paging system) استفاده میکند. در این روش، وزنها روی دیسک ذخیره میشوند و فقط هنگام نیاز به حافظه ویدیویی (VRAM) منتقل میشوند. بنابراین، تعداد پارامترها به جای VRAM، به فضای خالی دیسک شما بستگی دارد. این رویکرد در واقع نسخهای بهینهشده از استراتژیهای مدیریت حافظه است که در خوشههای پردازشی برای رفع گلوگاه مدلهای عظیم به کار میروند.
بر اساس مستندات فنی، این ساختار به سه بخش تقسیم میشود:
- دیسک: تمام خبرهها (experts) و گشتاورهای بهینهساز Adam را به صورت فایلهای معمولی ذخیره میکند. این بخش استخر کل دانش مدل است و تنها محدودیت آن فضای خالی دیسک است.
- کش RAM: یک
ram_cacheکه خبرههایی را که اخیراً مورد نیاز بودهاند، با استفاده از سیاست حذف «کمکاربردترین» (LRU) نگه میدارد. - VRAM: مجموعهی فعال روی GPU است. در هر لحظه فقط ۳۲ خبره (حدود ۱۰۹ میلیون پارامتر از مجموع ۵۴۰ میلیون) در آن حضور دارند.
قبل از هر تکه متن، از مدل پرسیده میشود که متن پیشرو به چه چیزی نیاز دارد. پاسخ این پرسش، «مجموعه فعال» (working set) را تعیین میکند. امتیازدهی به تقاضا بر اساس وضعیتهای نهانی (hidden states) انجام میشود که سایتهای فراخوانی در هنگام خواندن تکه قبلی روی آنها مسیریابی کردهاند. دلیل این کار این است که یک بردار (embedding) به تنهایی هیچ زمینهای ندارد و اگر امتیازدهی روی بردارهای خام باشد، هر موضوعی درخواست خبرههای یکسانی را میدهد.
برای جلوگیری از جابهجاییهای بیهوده و نویز در مجموعه فعال، سیستم از مکانیزم «هیسترزیس» (hysteresis) استفاده میکند؛ یعنی یک خبره کاندید باید حاشیه برتری مشخصی نسبت به خبره فعلی داشته باشد تا جایگزین آن شود. همچنین، تازهواردها برای تعداد مشخصی از کاراکترها (dwell_chars) در جای خود ایمن هستند و سریعاً حذف نمیشوند.
دو قانون سختگیرانه بر این صفحهبندی حاکم است: اول اینکه گشتاورهای Adam همراه با خبره جابهجا میشوند تا تکانه (momentum) یک خبره به خبرهای غریبه منتقل نشود. دوم اینکه خبرههایی که از قبل روی کارت هستند در جای خود میمانند تا تعداد بارگذاریها به حداقل برسد. تطبیق بر اساس هویت (identity) به جای موقعیت (position) باعث میشود تعداد بارگذاریها دقیقاً برابر با میزان تغییر واقعی در مجموعه فعال باشد.
معماری و عمق تطبیقی
برخلاف مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — که لایههای ثابتی دارند، mini-AGI از یک بلوک بازگشتی استفاده میکند که تا ۲۴ بار تکرار میشود. فرآیند با دو بلوک مقدماتی متراکم (dense prelude blocks) شروع شده و سپس بلوک بازگشتی اجرا میشود. وضعیت نهان بین تکرارها هرگز رمزگشایی نمیشود؛ بلکه هر بار توسط یک آداپتور با ورودی برداری ادغام میشود تا از انحراف حلقه از متن جلوگیری شود. این ساختار منجر به سه بلوک متمایز با حداکثر ۲۶ اجرای بلوک به ازای هر کاراکتر میشود.
این مدل از دستورالعمل PonderNet پیروی میکند؛ یعنی یک «سر توقف» (halting head) دارد که هر کاراکتر را در هر ردیف امتیازدهی میکند. پردازش کاراکتر به محض اینکه ردیف بعدی تغییری در پاسخ ایجاد نکند، متوقف میشود. کاراکترهای ساده ممکن است تنها به یک ردیف نیاز داشته باشند، در حالی که کاراکترهای سخت ردیفهای بیشتری میطلبند. در عمل، مدل مدام بین ۴ تا ۱۴ ردیف در مقابل سقف ۲۴ ردیف در نوسان است. در طول آموزش، هر عمقی محاسبه شده و بر اساس احتمال توقف وزندهی میشود تا سر توقف بتواند یاد بگیرد.
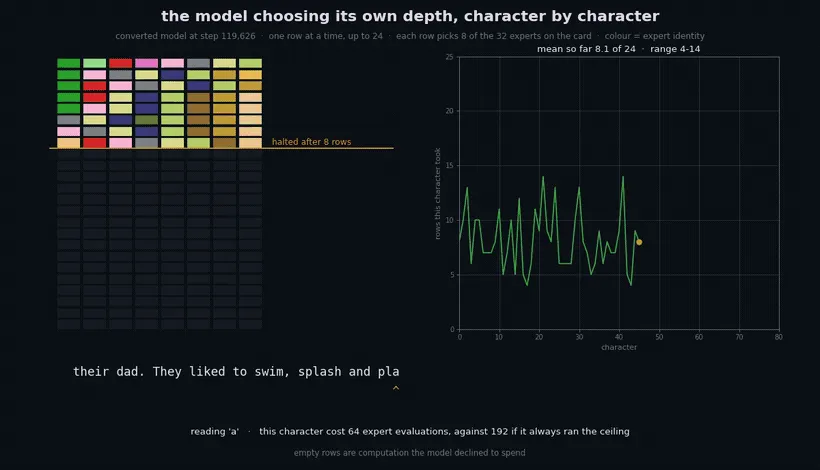
مسیریابی در این مدل به جای هر کاراکتر، در هر اجرای بلوک رخ میدهد. هر یک از ۲۶ اجرای احتمالی، ۸ خبره برتر خود را از یک استخر مشترک انتخاب میکنند. این یعنی یک کاراکتر میتواند از ظرفیت بسیار بیشتری از مدل نسبت به روشهای معمول ترکیب خبرهها (MoE) استفاده کند. هیچ خبرهای به موضوع خاصی اختصاص داده نشده و برچسبی وجود ندارد؛ مسیریابی نرم top-k به طور خودکار قابلیتها را در استخر توزیع میکند. هزینه این روش این است که قابلیتها پارامترهای مشترکی دارند و ممکن است با هم تداخل کنند.
تولید در مقابل خواندن
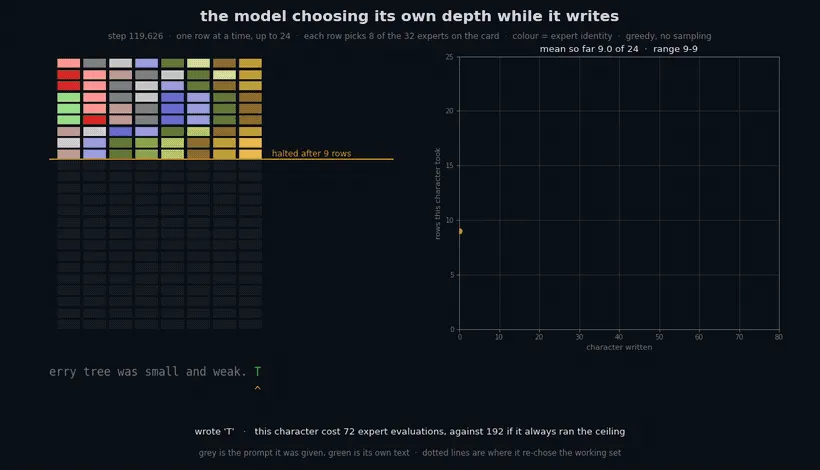
از آنجایی که تولید و خواندن از یک مسیر پیشرو (forward pass) یکسان استفاده میکنند، تنها تفاوت در این است که کاراکتر بعدی از یک فایل میآید یا از argmax خود مدل. مدل از رمزگشایی حریصانه (greedy decoding) بدون نمونهبرداری (sampling) استفاده میکند؛ بنابراین دو بار اجرای آن، دقیقاً همان جمله را تولید میکند.
نوشتن از نظر محاسباتی گرانتر از خواندن است. در یک موضوع یکسان، نوشتن حدود ۹.۹ ردیف به ازای هر کاراکتر هزینه دارد، در حالی که برای خواندن این مقدار ۸.۰ ردیف است. در آزمایشی که مدل باید داستانی درباره یک درخت گیلاس را پس از یک پرامپت ۲۵۰۰ کاراکتری ادامه دهد، متنی از نظر دستوری صحیح و مرتبط تولید کرد، هرچند تکرارهایی مشاهده شد که بازتابی از وضعیت مدل در ۲۴۳ میلیون کاراکتر بود.
نبرد با فراموشی فاجعهبار
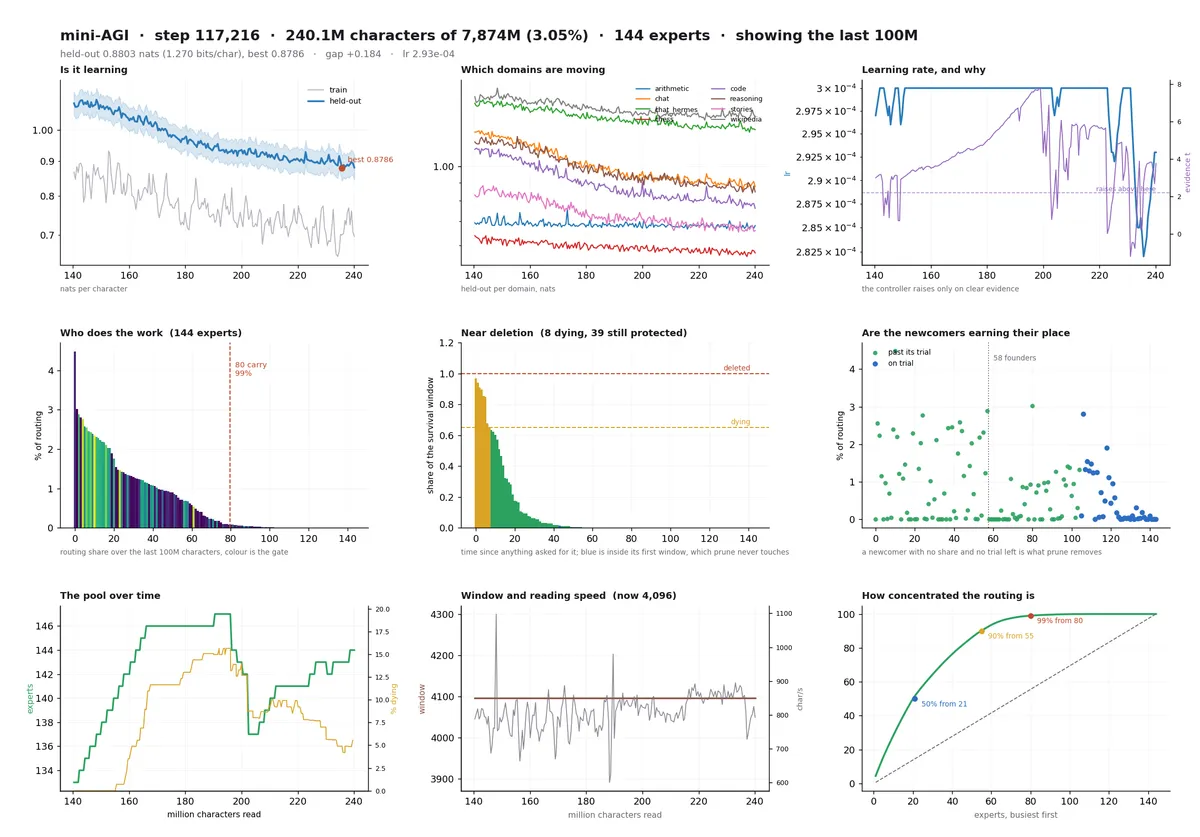
آموزش روی یک موضوع در هر زمان معمولاً منجر به فراموشی فاجعهبار (Catastrophic Forgetting) میشود؛ یعنی مدل با یاد گرفتن شطرنج، نحوه نوشتن شعر را فراموش میکند. برای مثال، خواندن نیم میلیون کاراکتر شطرنج با نرخ یادگیری خبرهها میتواند باعث شود سایر موضوعات از ۱.۱۲ به ۳.۷۳ نات تخریب شوند. mini-AGI این مشکل را با استفاده از نرخ یادگیری تفکیکشده برای «تنه» مدل (شامل بردارها، توجه، مسیریابها و سر توقف) حل کرده است.
به گزارش تیم توسعه، تنه مدل ۹۷.۶٪ از نرم گرادیان مربعی را تحمل میکند. با اجرای تنه در ۰.۱ برابر نرخ خبرهها، فراموشی از ۲.۲۳ نات به ۰.۰۰۶۷ نات کاهش یافت؛ به این معنا که ۹۹.۸۴٪ از پیشرفتهای قبلی در برابر شانس حفظ شده است.
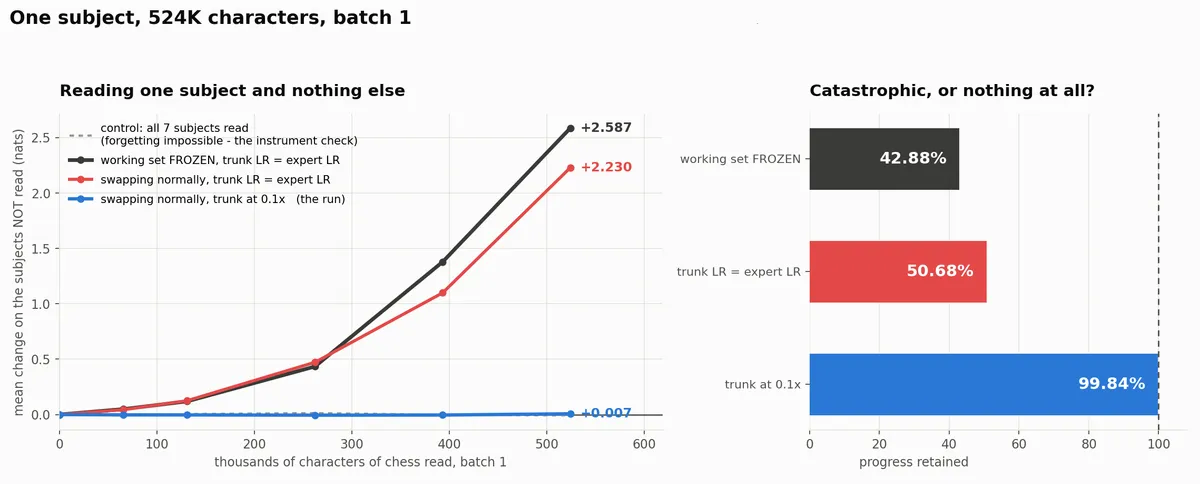
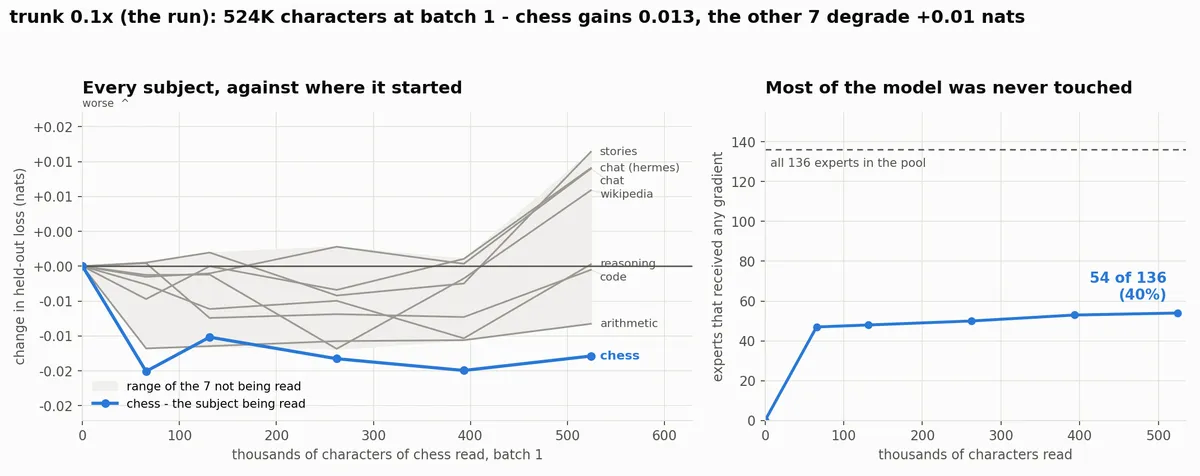
این مکانیزم بهروزرسانیها را به بخشهای خاصی از مدل که متن واقعاً به آنها اشاره میکند، محدود میکند. در یک بررسی روی ۵۲۴ هزار کاراکتر دادههای شطرنج، تنها ۵۴ خبره از ۱۳۶ خبره گرادیان دریافت کردند و ۶۰٪ مدل از نظر ساختاری دستنخورده باقی ماند. پروژه دریافت که صرفاً منجمد کردن مجموعه فعال کافی نیست؛ زیرا آسیب فراموشی ناشی از «جابهجایی» است، نه «تخریب». منجمد کردن مجموعه فعال تنها ۰.۳۵۷۱ نات هزینه داشت که فقط ۱۳.۸٪ از اثر کل فراموشی است.
با این حال، دانشی که آسیب دیده است میتواند سریعاً بازآموزی شود؛ سه چهارم آن در ۱۳۱ هزار کاراکتر بازمیگردد، در حالی که یادگیری اولیه آن حدود ۵۰ میلیون کاراکتر زمان برده بود. این نشان میدهد که واژه «فاجعهبار» بیشتر توصیفکننده ظاهر منحنی زیان است تا تخریب کامل وزنها.
رشد، هرس و مقیاسپذیری
تعداد پارامترهای این مدل پویا است. مدل با ترکیب واحدهای نهان از چندین خبره موجود، خبرههای جدید میسازد. کلون کردن یک خبره والد به اندازه کافی نوآورانه نیست و یک خبره تصادفی هم چیز مفیدی محاسبه نمیکند؛ بنابراین نوآوری باید از اجزای آموزشدیده اسمبل شود.
یک خبره جدید تنها زمانی حفظ میشود که به طور مداوم درخواست شود و از چندین «ترمز» عبور کند:
- Room (فضا): دیسک و VRAM باید ظرفیت داشته باشند.
- Used (استفاده): ظرفیتهای اضافهشده قبلی باید فعالانه درخواست شوند.
- Earning (بهرهوری): گروه قبلی باید از دوره آزمایشی خود جان سالم به در برده باشند.
- Fits (تطبیق): نباید خبرههای زیادی در حال حاضر در دوره آزمایشی باشند.
- Honest (صداقت): زیان آموزش و زیان دادههای خارج از آموزش (held-out loss) نباید از هم فاصله گرفته باشند.
از سوی دیگر، خبرههایی که دیگر درخواست نمیشوند، هرس میشوند. جالب اینجاست که پروژه دریافت «گیت» (gate) خاصیت ضد-پیشبینی دارد: شلوغترین خبرهها اغلب کوچکترین گیتها را دارند و مانند چاهک عمل میکنند. بنابراین، هرس بر اساس مدت زمانی که از آخرین فراخوانی خبره میگذرد انجام میشود، نه بر اساس مقدار گیت. یک خبره جدید بدون توجه به گیتش، برای یک پنجره بقای کامل ایمن است.
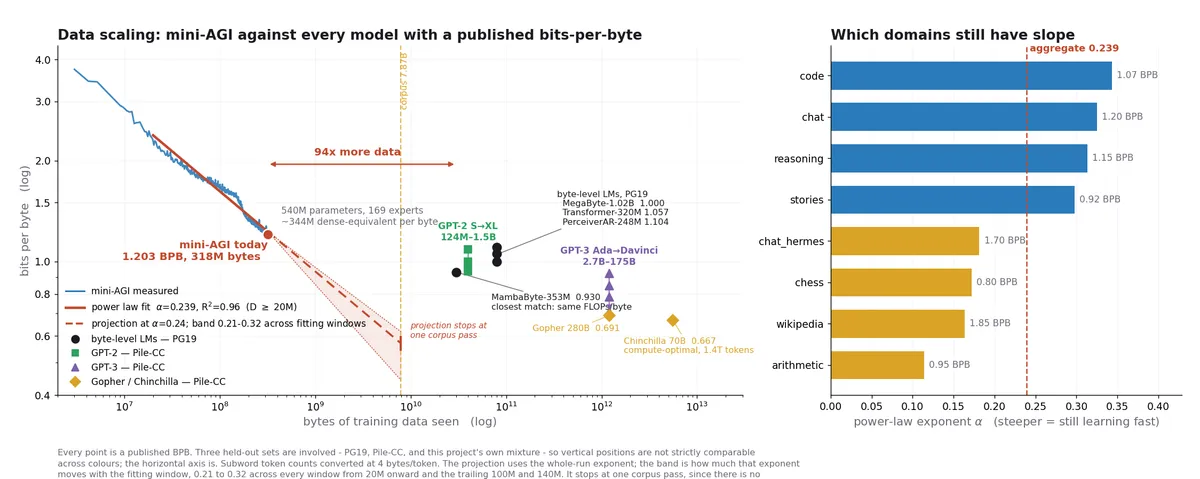
از نظر عملکرد، مدل از یک قانون توان (power law) سالم پیروی میکند. در ۳۱۸.۱ میلیون کاراکتر خوانده شده و ۱۶۹ خبره، روند زیان (L ∝ D^-0.239) با R² برابر ۰.۹۶ نشان میدهد. این توان بین مقدار ۰.۰۹۵ کاپلان و ۰.۲۸ چینچیلا قرار دارد.
پیشبینیهای مقیاسپذیری روی یک GPU لپتاپ، جدول زمانی زیر را پیشنهاد میکند:
- ۱.۱۰ BPB: حدود ۳ روز (۰.۵۱ میلیارد بایت)
- ۱.۰۰ BPB: حدود ۶ روز (۰.۷۵ میلیارد بایت)
- ۰.۹۳ BPB: حدود ۱۰ روز (۱.۰۲ میلیارد بایت)
- ۰.۸۰ BPB: حدود ۲۴ روز (۱.۹۲ میلیارد بایت)
مشخصات فنی و پیادهسازی
برای دستیابی به این انعطافپذیری، مدل از مجموعهای از اجزای معماری خاص استفاده میکند:
- اجزای اصلی: RMSNorm، RoPE (برداریهای موقعیتی چرخشی)، SwiGLU و توجه برقآسا (flash attention) از طریق
scaled_dot_product_attention. - پنجره متنی: از
model.context_startشروع شده و هر بار یک کاراکتر گسترش مییابد تا مدل از تاریخچه طولانیتر بهره ببرد. پنجره فعلی ۴,۰۹۶ است. - توزیع پارامترها: در زمان نگارش، مجموع پارامترها ۵۴۰.۱ میلیون است. این شامل هسته (۸.۲۷ میلیون)، مسیریابها (۰.۱۷ میلیون) و خبرهها (۵۳۱.۶ میلیون، شامل ۱۶۹ خبره با ۳.۱۵ میلیون پارامتر برای هر کدام) است.
- هزینه محاسباتی: هزینه آموزش مدل تقریباً ۲.۴ GFLOPs به ازای هر بایت است که آن را در همان کلاس محاسباتی یک ترنسفورمر متراکم ۴۰۰ میلیونی در سطح بایت قرار میدهد.
کاربران میتوانند با دستور ساده python3 train.py read ~/notes مدل را روی فایلهای محلی خود آموزش دهند. چون این یک مدل در سطح بایت است با واژگانی به ارزش ۲۶۵ (۲۵۶ مقدار بایت به علاوه ۹ نشانگر ساختاری مثل <think>، <user>، <bot>، <g> برای بازیها و پایان متن)، نیازی به توکنسازی (Tokenization) — تبدیل متن به تکههای کوچک شبیه برشهای کیک — ندارد و هر نوع فایلی را مستقیماً میخواند. دایرکتوریها پیمایش شده و فایلهای باینری با نمونهبرداری از محتوا نادیده گرفته میشوند. این دستاورد در راستای تلاشاتی است که امکان آموزش مدلهای میلیاردی را روی پردازندههای مصرفکننده ۱۶ گیگابایتی فراهم کرده است.
پرچمهای کلیدی آموزش شامل --passes N برای خواندن چندین باره یک مجموعه و --save برای ثبت وزنها روی دیسک است. نرخ یادگیری از منحنی کسینوسی (که به معنای پایان آموزش است) پیروی نمیکند، بلکه توسط کنترلگری مدیریت میشود که زیان دادههای خارج از آموزش را زیر نظر دارد و نرخ را بر اساس شواهد بهبود، بالا یا پایین میبرد.
در حال حاضر، این پروژه یک آزمایش در سطح «اسباببازی» است و هدفش رقابت با مدلهای پیشرو نیست، بلکه میخواهد ثابت کند سد سختافزاری برای آموزش هوش مصنوعی شخصی شکسته شده است. بنچمارکهای فعلی نشان میدهند زیان دادههای خارج از آموزش بسته به موضوع متفاوت است: شطرنج ۰.۵۵۲ نات/کاراکتر، داستانها ۰.۶۳۷، حساب راستی ۰.۶۵۷، کدنویسی ۰.۷۳۹، استدلال ۰.۷۹۴، چت ۰.۸۳۱، chat_hermes ۱.۱۷۸ و ویکیپدیا ۱.۲۸۰ نات/کاراکتر.
این تغییر نشاندهنده آیندهای است که در آن هوش مصنوعی یک سرویس متمرکز نیست، بلکه یک ابزار محلی است که با مشاهده جریان کاری و دادههای شما در طول ماهها و سالها، هوشمندتر میشود. این روند به طور مستقیم با برتری مدلهای محلی در سرعت و هزینه استنتاج نسبت به APIهای ابری همسو است. برای شروع، به یک GPU با قابلیت CUDA و حداقل ۸ گیگابایت VRAM (مثل RTX 3070 Laptop) و پایتون ۳.۱۰ نیاز دارید. میتوانید مخزن را کلون کنید، مجموعههای داده (TinyStories, OpenHermes-2.5, OpenThoughts-114k, Lichess) را بسازید و مقیاسپذیری را در عمل ببینید.
گام بعدی شما
- اگر کارت گرافیک NVIDIA با ۸ گیگابایت VRAM دارید، مخزن mini-AGI را کلون کنید و آموزش را روی یادداشتهای شخصی خود امتحان کنید.
- برای درک بهتر، دادههای TinyStories یا OpenHermes را به عنوان مجموعه داده اولیه بارگذاری کنید.
- تغییرات در نرخ زیان (Loss) را در طول ۱۰ روز مشاهده کنید تا اثر قوانین مقیاسپذیری را در مقیاس کوچک ببینید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو