تصور کنید یک سیستم اتوماسیون در شرکت شما با اطمینان ۹۰٪ ادعا میکند که یک ایمیل مشتری مربوط به بخش «فروش» است، اما در واقعیت، این مدل تنها در ۶۰٪ موارد درست میگوید. این شکاف میان «اعتماد به نفس مدل» و «صحت واقعی»، بزرگترین مانع برای سپردن کارهای حساس به هوش مصنوعی است.
برای حل این مشکل، شرکت TypeSafe AI در ۱۵ سپتامبر ۲۰۲۶ مدل Jev را عرضه کرد؛ مدلی که صرفاً برای تصمیمگیری طراحی شده و از متدی اختصاصی به نام RLCD برای کالیبره کردن امتیازات اطمینان استفاده میکند.
بسیاری از مدلهای عمومی بر پایه RLHF (یادگیری تقویتی با بازخورد انسانی) — شبیه به دانشآموزی که یاد میگیرد جوابهایی بدهد که معلم دوست دارد، نه لزوماً جوابهای درست — آموزش میبینند. این رویکرد منجر به «توهمِ اطمینان» میشود؛ وضعیتی که مدل با لحنی قاطع، اطلاعات غلط ارائه میدهد. همانطور که در تحلیل قبلی ما دربارهی چالشهای مدلهای زبانی کوچک در مواجهه با دادههای نامنظم اشاره کردیم، صنعت اکنون به سمت کالیبراسیون تخصصی برای اتوماسیونهای حساس حرکت میکند. این تلاشها در راستای کاهش توهمات است، مشابه آنچه در رویکرد مدلهای LLM-JEPA برای شبیهسازی واقعیت و کاهش نرخ توهم مشاهده کردیم.
تعریف RLCD: ابزاری اختصاصی یا استاندارد صنعتی؟
اصطلاح RLCD یا «یادگیری تقویتی برای تصمیمات کالیبره شده»، توسط TypeSafe AI ابداع شده است. اگرچه این نام شبیه به تکنیکهای آکادمیک سال ۲۰۲۳ مانند PPO به نظر میرسد، اما طبق گزارشهای منتشر شده، این یک متد اختصاصی است که تا زمان نگارش این گزارش، تنها هشت روز است که به صورت عمومی معرفی شده است.
لنس الیوت، نویسنده فوربز، اشاره کرده است که RLCD یک تکنیک استاندارد در صنعت نیست. هرچند این روش با مفاهیمی مثل RLCR و RLVR همخانواده است، اما همچنان یک راز تجاری برای TypeSafe AI باقی مانده است.
به نقل از وبسایت dev.to، هدف RLCD بهینهسازی توزیع احتمالات بهگونهای است که با نتایج واقعی مطابقت داشته باشد. به این معنا که اگر Jev برای یک تصمیم احتمال ۶۴٪ قائل شود، آن تصمیم باید دقیقاً در ۶۴٪ موارد درست باشد.
سازوکار کالیبراسیون در Jev
برخلاف مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — مدل Jev برای هر تصمیم دو سیگنال مجزا صادر میکند:
- توزیع احتمال (Probability Distribution): تفکیک پاسخهای ممکن. مثلاً برای یک پیام پشتیبانی: فنی ۶۴٪، فروش ۲۳٪، صورتحساب ۱۳٪ و لغو اشتراک ۰٪.
- امتیاز اطمینان (Confidence Score): معیاری مجزا (مثلاً ۵۳٪) که نشان میدهد آیا کل این فراخوان برای اقدام خودکار قابل اعتماد است یا خیر.
این ساختار به توسعهدهندگان اجازه میدهد موارد با اطمینان بالا را به اتوماسیون و موارد با اطمینان پایین را به بازبینهای انسانی ارجاع دهند. مدلی که ۵۳٪ اطمینان گزارش میکند، باید در واقعیت نزدیک به نیمی از دفعات اشتباه کند تا «کالیبره» محسوب شود.
مقایسه اهداف آموزشی
برای درک این چرخش، تفاوت RLCD با متدهای رایج را بررسی کنیم:
- RLHF: بر خروجیهایی که ارزیابان انسانی میپسندند تمرکز دارد. نقطه شکست آن، ترجیح دادن «پاسخ محبوب» بر «پاسخ درست» است.
- RLVR (پاداشهای قابل تایید): بر خروجیهایی تمرکز دارد که یک برنامه میتواند آنها را تایید کند (معمولاً در قالب JSON). این روش فقط جایی کار میکند که «درستی» با کد قابل بررسی باشد.
- RLCD: بر احتمالات منطبق با نتایج واقعی تمرکز دارد. نقطه شکست آن، احتمال انتخاب پاسخی است که با اطمینان بالا غلط، اما از نظر ساختاری معتبر باشد.
جنجال بر سر سرعت
شرکت TypeSafe AI ادعا میکند Jev بین ۴۰ تا ۲۰۰ برابر سریعتر از مدلهای استاندارد است، اما منشأ این سرعت مورد بحث است. یک پروژه بازمتن به نام openjev، رابط کاربری موازیِ تایپشده را با استفاده از مدل Qwen3.5-4B روی یک پردازنده گرافیکی (GPU) RTX 3090 آزمایش کرد.
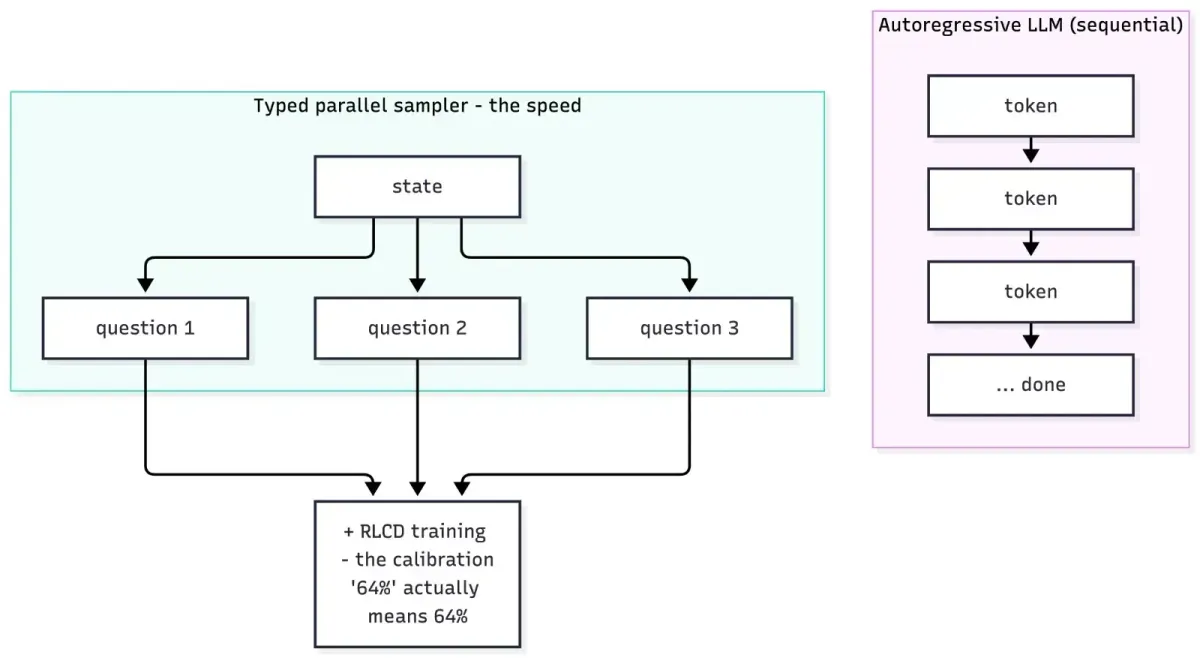
نتایج نشان داد که خواندن مستقیم لاجیتها (Logits) — بهجای تولید یک آرایه JSON — منجر به افزایش ۵ برابری سرعت شد (۱.۰۲ ثانیه در مقابل ۵.۳۳ ثانیه برای ۲۱ پرسش). در ۱۰۲ مورد آزمایشی، openjev امتیاز ۰.۸۴۵ در توافق مدال کسب کرد، در حالی که این عدد برای Jev برابر ۰.۸۸۳ بود.
این دادهها نشان میدهند که بخش بزرگی از کاهش تأخیر (Latency) ناشی از معماری رابط کاربری است، نه لزوماً آموزش RLCD. این یافتهها با تحلیل ما دربارهی جایگزینی تولید متن با تصمیمگیری مستقیم برای رفع موانع سرعت در معماریهای فعلی همسو است. دیوگو آلمیدا در شبکه X پاسخ داد که گلوگاه واقعی، دادههای آموزشی برای کالیبراسیون است، نه خودِ معماری.
برای یک توسعهدهنده، ارزش واقعی RLCD در سرعت خام نیست، بلکه در قابلیت اطمینان است. وقتی مدلی صادقانه میگوید «من فقط ۵۳٪ مطمئنم»، تبدیل به قطعهای امن در خط تولید نرمافزاری میشود، نه یک ریسک.
با این حال، TypeSafe AI تعداد پارامترها، معماری یا ترکیب دادههای آموزشی را فاش نکرده است. این عدم شفافیت باعث میشود تشخیص این موضوع دشوار باشد که آیا RLCD یک پیشرفت الگوریتمی بنیادین است یا صرفاً بازبرندینگ ایدههای RLCR روی یک معماری جدید.
گام بعدی شما
- اگر از مدلهای تصمیمگیر در خط تولید استفاده میکنید، خروجیهای مدل را با نرخ خطای واقعی مقایسه کنید تا میزان «بیشاطمینانی» (Overconfidence) را بسنجید.
- برای کاهش تأخیر در استنتاج، بهجای تولید متن (Generation)، خواندن مستقیم لاجیتها را در مدلهای کوچکتر امتحان کنید.
- منتظر انتشار بنچمارکهای بازمتن برای کالیبراسیون باشید تا ادعاهای شرکتها را بهصورت مستقل بسنجید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو