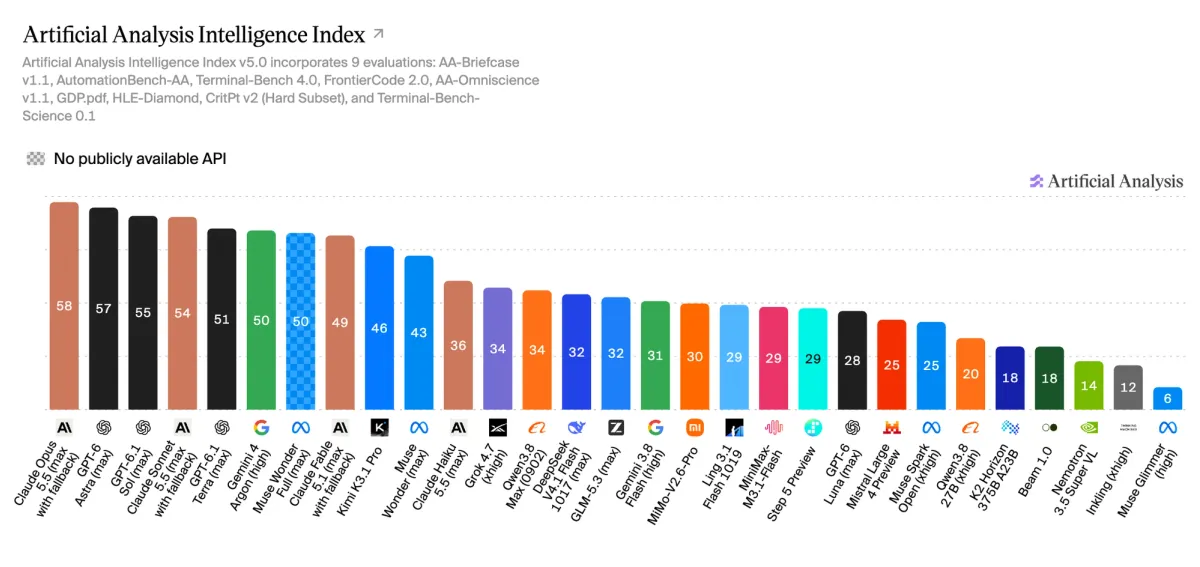
آرتیفیشال آنالیسیس (Artificial Analysis) نسخهٔ پنجم شاخص هوش خود را منتشر کرد و برای نخستین بار ۶۰ درصد آن را بر محکهایی با دادههای خصوصی بنا کرد. در شاخص هوش v5، مدل Claude Opus 5.5 با ۵۸ امتیاز اول است و شکاف مدلهای با وزنهای باز از ۳ به ۱۲ امتیاز رسیده است.
به گفتهٔ این مؤسسه، v5 بزرگترین ارتقای شاخص از زمان عرضهٔ v4 در ژانویه است. این نسخه دو ارزیابی عاملمحور (agentic) تازه اضافه کرده و سه محک قبلی را ارتقا داده است. همزمان، شاخص تازهای به نام شاخص پیشرفت (Progress Index v1) هم عرضه شده که مدلها را روی یک مقیاس واحد در طول زمان قرار میدهد.
ترکیب تازهٔ شاخص هوش v5
شاخص اکنون چهار دسته را با وزن برابر ۲۵ درصد میسنجد: کار دانشی، کدنویسی، علم و عمومی. FrontierCode 2.0 از شرکت Cognition و Terminal-Bench-Science دو محک کاملاً جدید این نسخهاند. HLE-Diamond و AA-Omniscience v1.1 و زیرمجموعهٔ سخت CritPt v2 هم جای آزمونهای قبلی را گرفته یا آنها را اصلاح کردهاند.
وزن هر دسته
- کار دانشی: AA-Briefcase (۱۵٪)، AutomationBench-AA (۵٪) و GDP.pdf (۵٪)
- کدنویسی: FrontierCode 2.0 (۱۵٪) و Terminal-Bench 4.0 (۱۰٪)
- علم: Terminal-Bench-Science (۱۵٪) و زیرمجموعهٔ سخت CritPt v2 (۱۰٪)
- عمومی: AA-Omniscience v1.1 (۱۵٪؛ شامل ۱۰٪ صحت و ۵٪ پرهیز از توهم) و HLE-Diamond (۱۰٪)
محکهای ماندگار و حذفشده
چهار محک AA-Briefcase و AutomationBench-AA و GDP.pdf و Terminal-Bench 4.0 در شاخص ماندهاند. در مقابل، سه محک GDPval-AA v2.1 و SciCode و AA-LCR v1.1 کنار گذاشته شدهاند.
در v4.3 فقط بخش کوچکتری از شاخص بر دادههای خصوصی تکیه داشت. اکنون ۶۰ درصد شاخص از مجموعههای آزمون خصوصی یا پاسخهای نگهداشتهشده (held-out) استفاده میکند.
محکهای تازه و ارتقایافته
FrontierCode 2.0
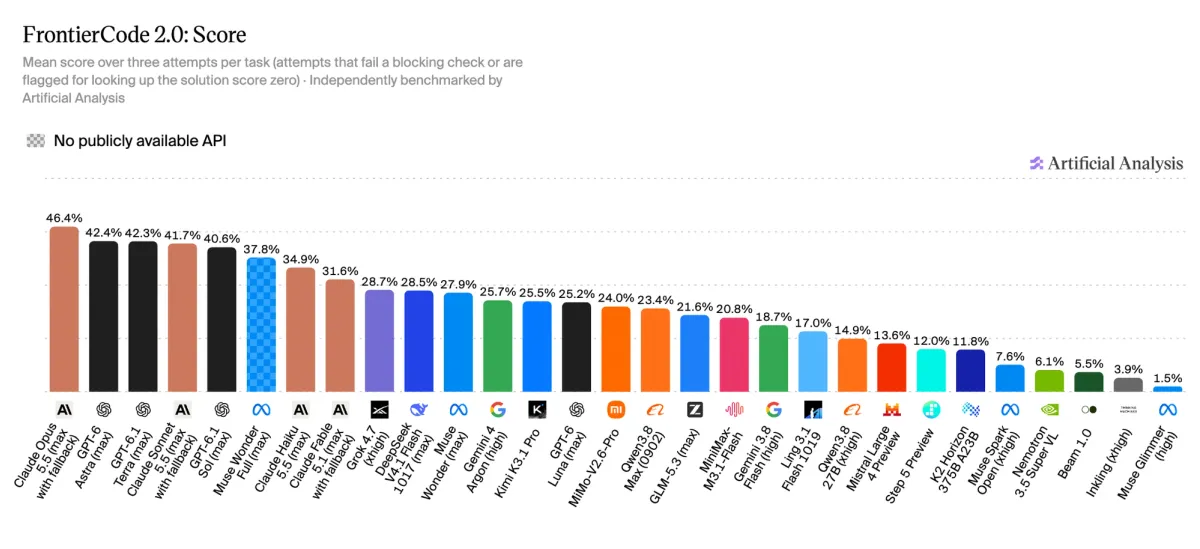
این محک ۱۳۲ وظیفهٔ واقعی کدنویسی در مخازن متنباز دارد. معیار نمره این است که آیا نگهدارندهٔ مخزن تغییر عامل را ادغام (merge) میکند یا نه. آرتیفیشال آنالیسیس هر وظیفه را سه بار در چارچوب عاملمحور خود به نام Stirrup harness اجرا میکند و شکست در هر بررسی مسدودکننده (blocking-check) نمرهٔ صفر دارد. وظایف برای جلوگیری از آلودگی داده (contamination) خصوصی میمانند.
Claude Opus 5.5 (max) با ۴۶٪ اول است. پس از آن GPT-6 Astra (max) و GPT-6.1 Terra (max) و Claude Sonnet 5.5 (max) هر سه با ۴۲٪ قرار دارند. بهترین مدل با وزنهای باز، DeepSeek V4.1 Flash 1017 (max)، با ۲۸٪ هجده امتیاز از صدر عقب است.
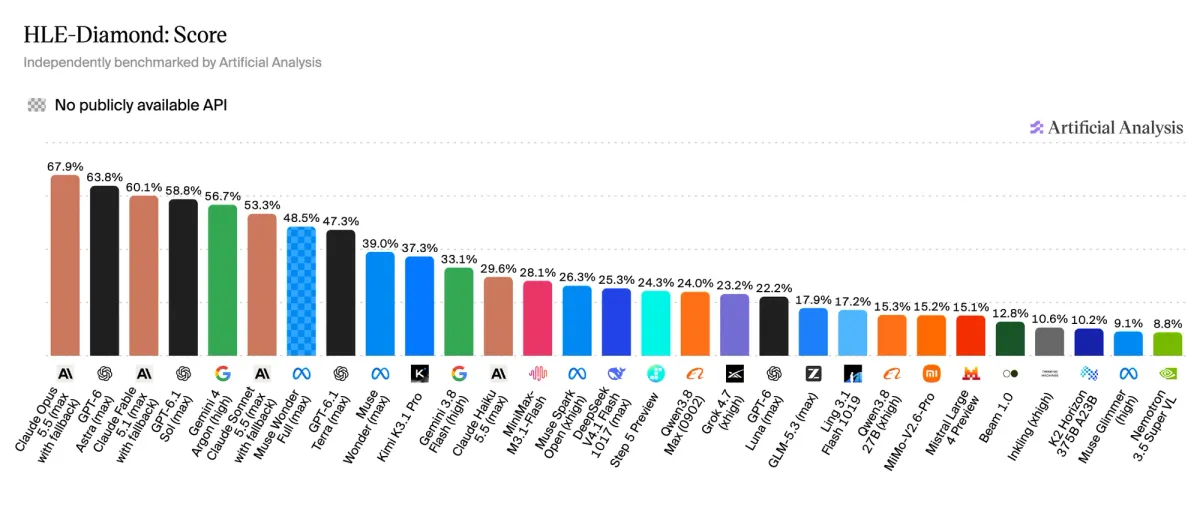
Terminal-Bench-Science
این محک ۷۰ گردشکار پژوهش علمی را بهصورت عاملمحور در محیط ترمینال میآزماید. کارشناسان هر وظیفه را تدوین و بازبینی میکنند. وظیفه فقط وقتی قبول است که همهٔ آزمونهایش را رد کند.
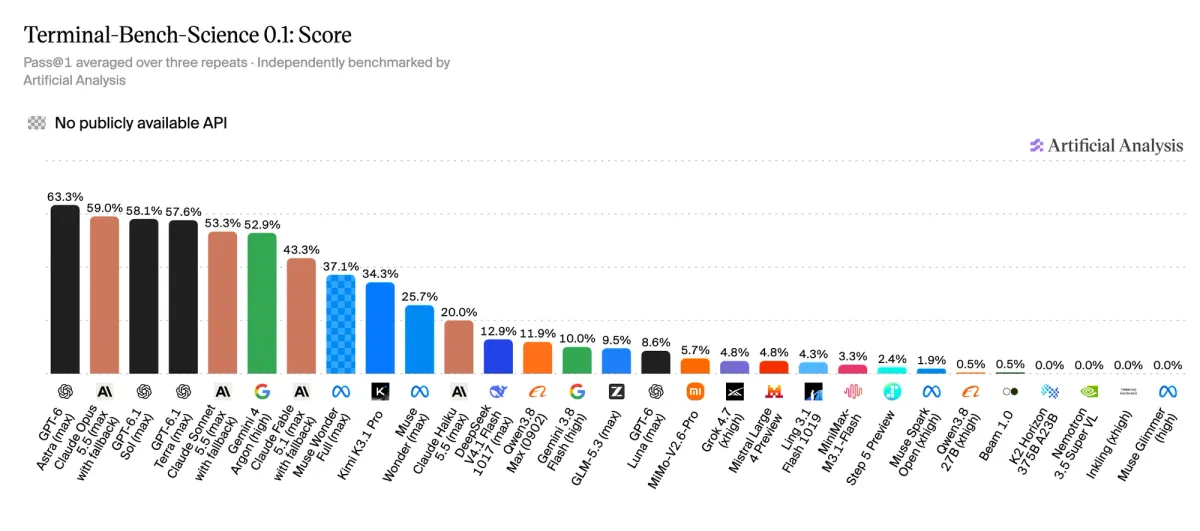
GPT-6 Astra (max) با ۶۳٪ اول است و Claude Opus 5.5 (max) با ۵۹٪ و GPT-6.1 Sol (max) با ۵۸٪ پس از آن هستند. پس از این سه، نمرهها بهشدت افت میکند:
- Kimi K3.1 Pro (وزنها هنوز منتشر نشده): ۳۴٪
- Claude Haiku 5.5 (max): ۲۰٪
- DeepSeek V4.1 Flash 1017 (max): ۱۳٪
بیشتر مدلهای با وزنهای باز که آزموده شدند زیر ۱۰٪ نمره گرفتند.
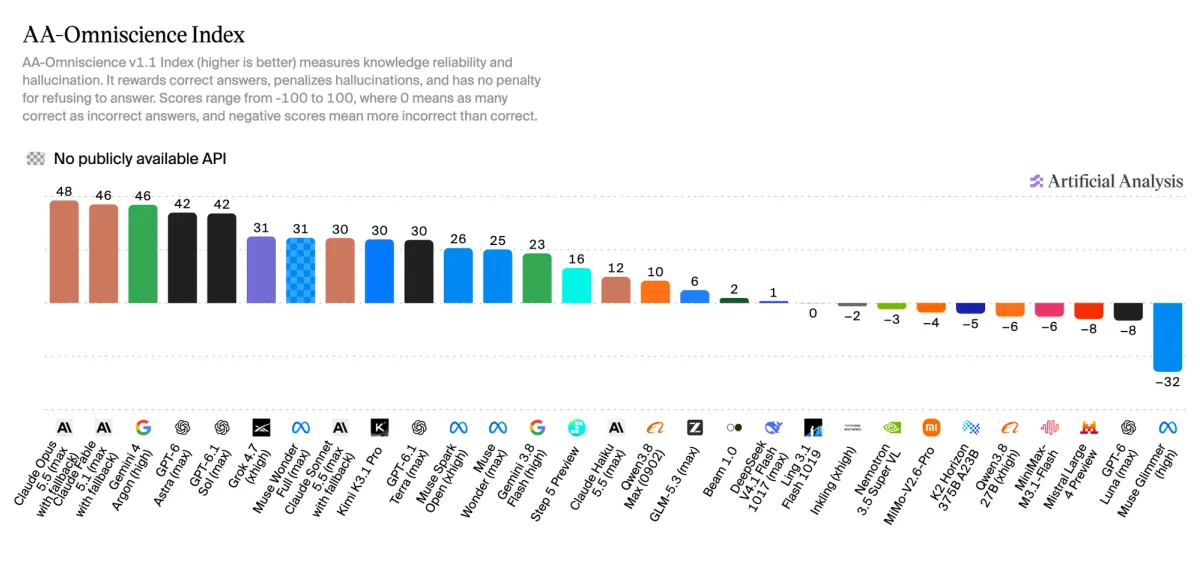
HLE-Diamond
HLE-Diamond جای «آخرین امتحان بشریت» (Humanity's Last Exam) را گرفته است. این نسخهٔ اصلاحشدهٔ ۱۰۰۰ سؤالی را مرکز ایمنی هوش مصنوعی (CAIS) و Scale AI تهیه کردهاند و سؤالهایش بهطور برابر میان استدلال و دانش تقسیم شده است.
Claude Opus 5.5 (max) با ۶۸٪ اول است، GPT-6 Astra (max) ۶۴٪ و Claude Fable 5.1 (max) ۶۰٪ گرفتهاند. سؤالهای دانشی برای مدلهای پیشرو سختتر بوده است: Opus 5.5 و GPT-6 Astra هر دو در استدلال ۷۸٪ گرفتند، اما در دانش بهترتیب به ۵۸٪ و ۵۰٪ رسیدند.
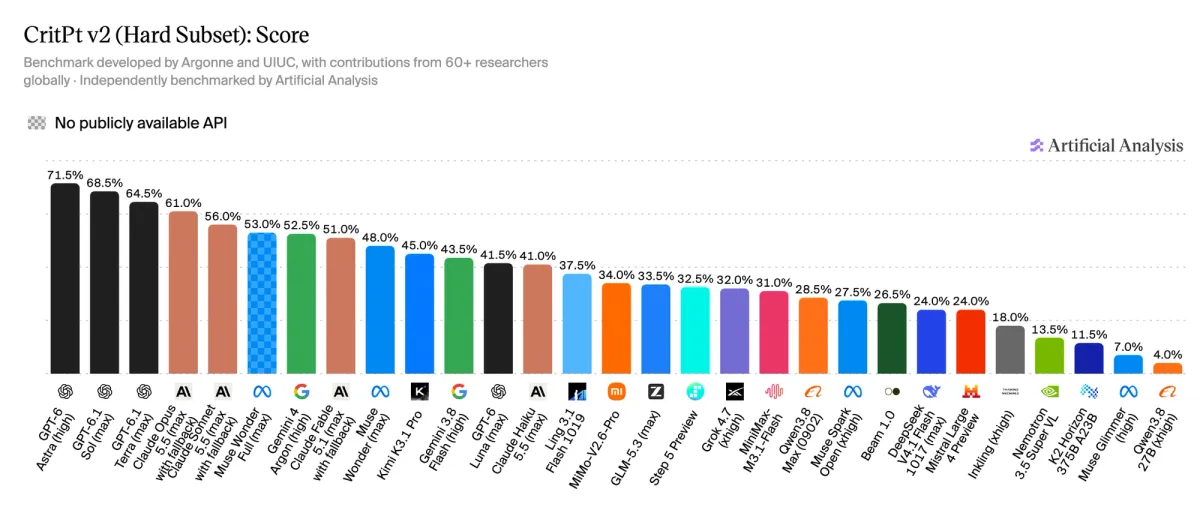
AA-Omniscience v1.1
در این نسخه سؤالهای اشباعشده (saturated) و عمومی حذف، سؤالهای تازه اضافه و سؤالهای مبهم یا نادرست اصلاح شدهاند. نمرهها تا حد زیادی با v1 همخوان است؛ مدلها بهطور میانگین ۲ امتیاز کمتر گرفتهاند و میانهٔ این اختلاف ۰٫۶ امتیاز است.
زیرمجموعهٔ عمومی تازهای به نام AA-Omniscience-Public-v1.1 هم در هاگینگفیس (Hugging Face) منتشر شده است. این زیرمجموعه دوباره تنظیم (recalibrated) شده تا صحت، نرخ توهم و عملکرد کلی در بخش عمومی و خصوصی یکسان باشد.
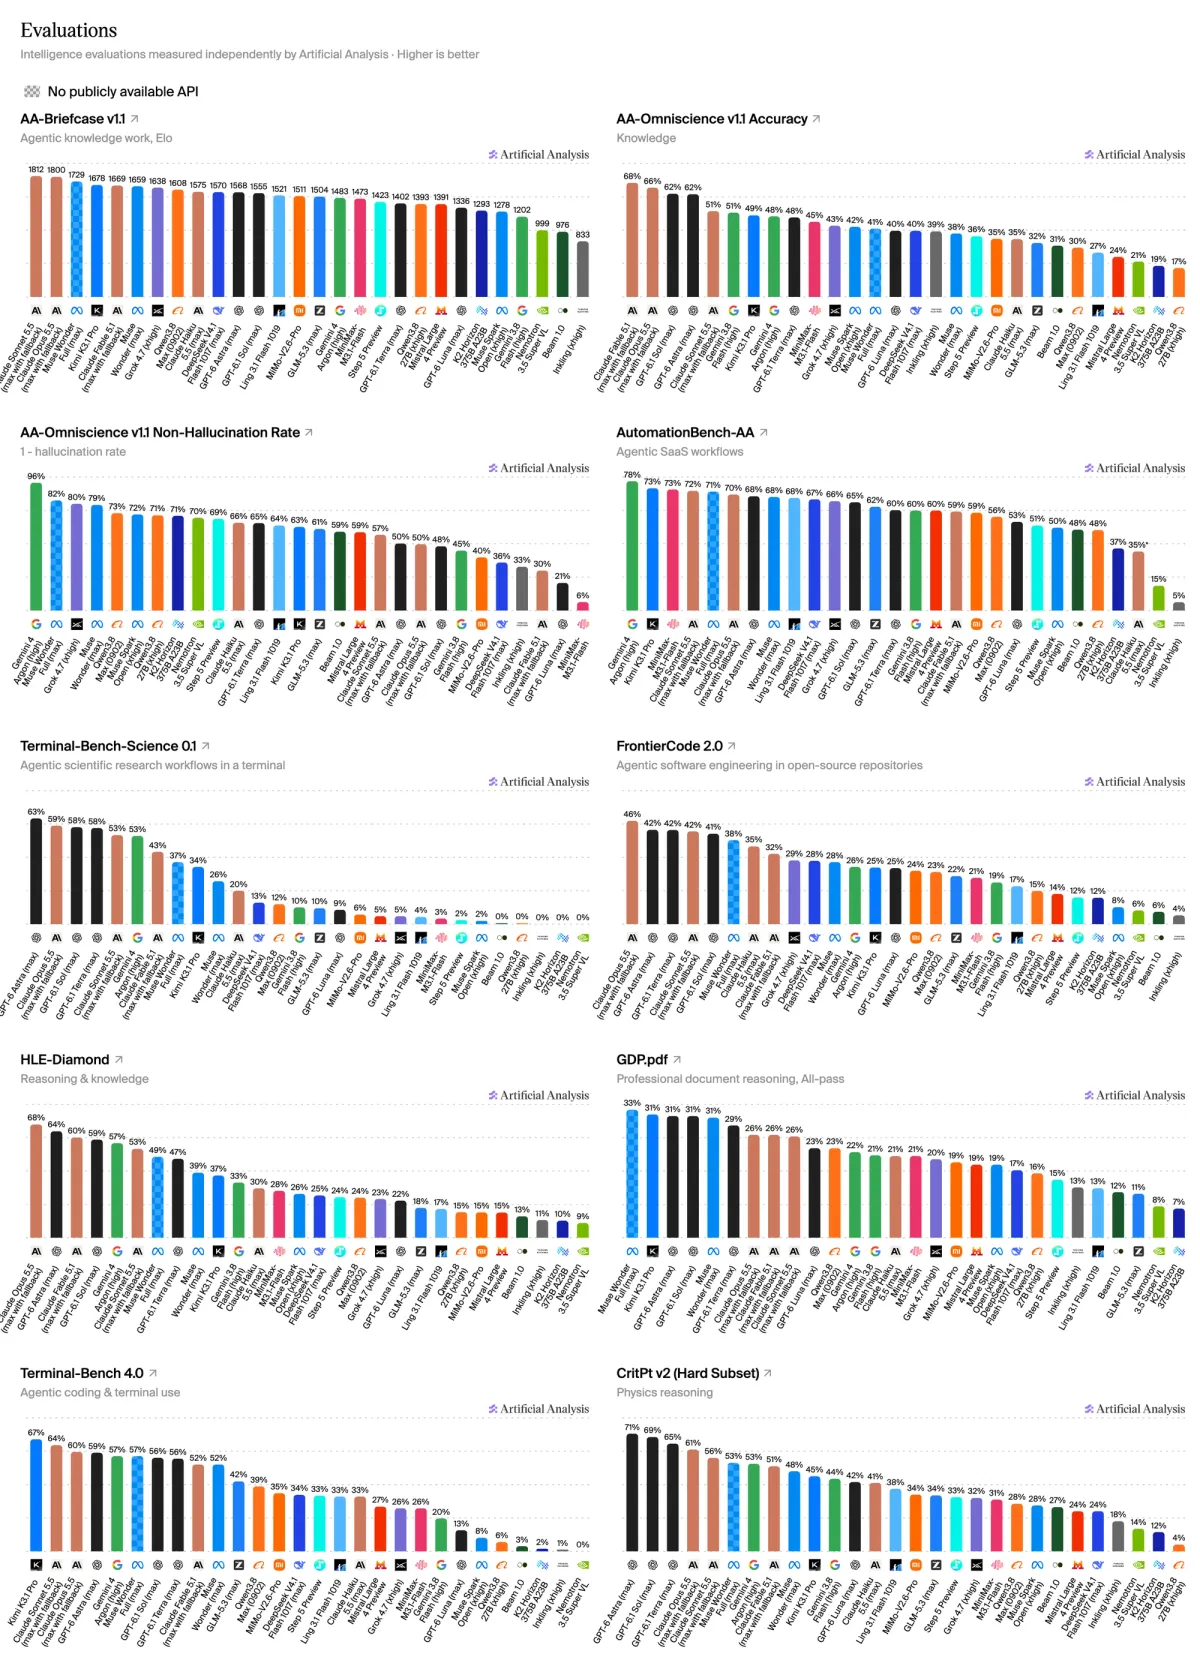
زیرمجموعهٔ سخت CritPt v2
این زیرمجموعهٔ خصوصی ۴۰ سؤال فیزیک دارد. از ۷۰ سؤال پژوهشی اصلی، ۳۰ سؤالی که هفت مدل پیشرو هنگام عرضه در هر پنج تلاش حل کرده بودند کنار گذاشته شده است. مدلها در محیط آفلاین پایتون درون Stirrup کار میکنند.
GPT-6 Astra با سطح تلاش high و ۷۲٪ اول است. GPT-6.1 Sol با سطح تلاش max به ۶۹٪ و Claude Opus 5.5 (max) به ۶۱٪ رسیدهاند. Kimi K3.1 Pro (وزنها هنوز منتشر نشده) با ۴۵٪ بهترین مدل با وزنهای باز است.
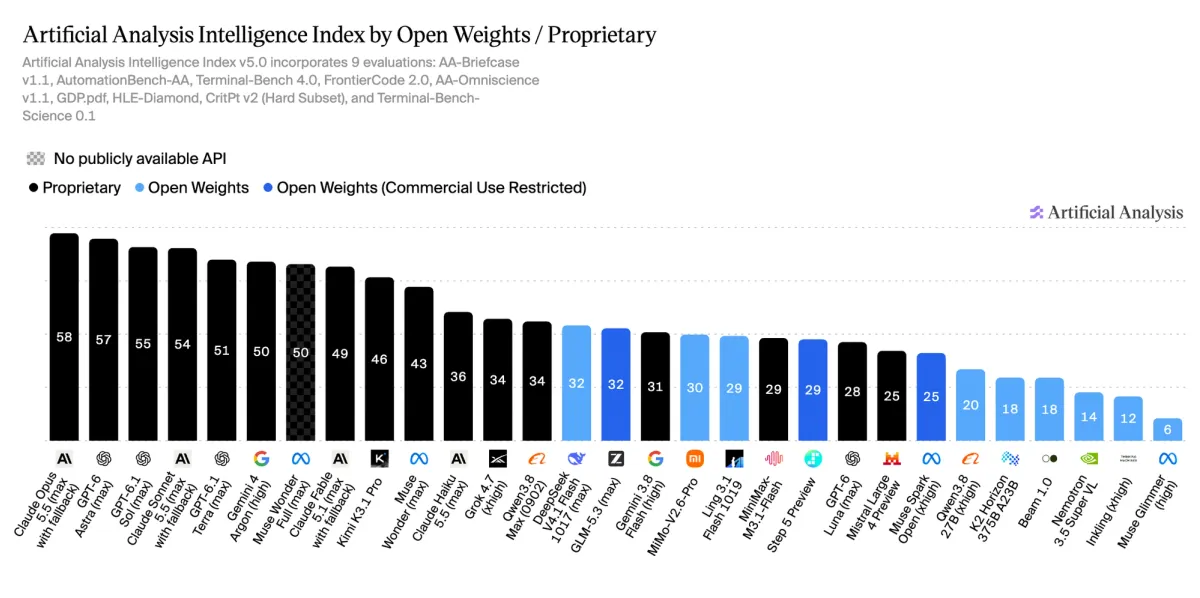
صدرنشینان شاخص هوش v5
آنتروپیک و اوپنایآی پنج جایگاه نخست را در اختیار دارند:
- Claude Opus 5.5 (max): ۵۸
- GPT-6 Astra (max): ۵۷
- GPT-6.1 Sol (max): ۵۵
- Gemini 4 Argon (high)، نخستین مدل پس از این پنج: ۵۰
هیچ مدلی در هر نُه ارزیابی اول نیست. Claude Opus 5.5 در سه محک صدرنشین است و پنج مدل دیگر شش محک باقیمانده را میان خود تقسیم کردهاند: در بخش کدنویسی، رقیب دیگری به نام Muse Wonder با Claude Code در نمره ۶۸ برابر شده است.
- Claude Opus 5.5: FrontierCode 2.0 (۴۶٪)، HLE-Diamond (۶۸٪) و AA-Omniscience v1.1 (۴۸)
- GPT-6 Astra: Terminal-Bench-Science (۶۳٪) و زیرمجموعهٔ سخت CritPt v2 (۷۲٪)
- Claude Sonnet 5.5: AA-Briefcase (امتیاز Elo برابر ۱۸۱۲)
- Kimi K3.1 Pro: Terminal-Bench 4.0 (۶۷٪)
- Gemini 4 Argon: AutomationBench-AA (۷۸٪)
- Muse Wonder Full: GDP.pdf (۳۳٪ با معیار all-pass)
شکاف سهبرابری مدلهای با وزنهای باز
بهترین مدل با وزنهای باز، Kimi K3.1 Pro که وزنهایش هنوز منتشر نشده، ۴۶ امتیاز گرفته است. این مدل ۱۲ امتیاز از صدر فاصله دارد، در حالی که این شکاف در v4.3 فقط ۳ امتیاز بود. این مدل در رتبه چهارم شاخص هوش با ۵۵ امتیاز قرار گرفته و انتشار وزنهای باز آن ۴ نوامبر است.
در میان مدلهایی که وزنهایشان منتشر شده، DeepSeek V4.1 Flash 1017 (max) و GLM-5.3 (max) با ۳۲ امتیاز بالاترند. این دو ۲۶ امتیاز از صدر عقباند و حتی از Claude Haiku 5.5 (max) با ۳۶ امتیاز هم پایینترند.
بیشترین فاصله در دو محک دیده میشود:
- HLE-Diamond: Kimi K3.1 Pro با ۳۷٪ در برابر Claude Opus 5.5 (max) با ۶۸٪
- Terminal-Bench-Science: Kimi K3.1 Pro با ۳۴٪ در برابر GPT-6 Astra (max) با ۶۳٪
هزینه هر وظیفه و سطح تلاش
هزینه در میان ۱۰ مدل برتر بیش از ۱۳ برابر تفاوت دارد. ارقام برای هر وظیفهٔ شاخص هوش چنین است:
- ارزانترین، GPT-6.1 Terra (max): ۰٫۹۶ دلار
- گرانترین، Claude Fable 5.1 (max): ۱۳٫۰۴ دلار
- Claude Opus 5.5 (max): ۱۰٫۰۴ دلار
- GPT-6 Astra (max): ۶٫۲۴ دلار
- GPT-6.1 Sol (max): ۱٫۲۷ دلار
به گفتهٔ آرتیفیشال آنالیسیس، GPT-6.1 Sol (max) با حدود یکهشتم هزینه، کمتر از ۴ امتیاز با Claude Opus 5.5 (max) فاصله دارد.
سطح تلاش مدلها در v5 اثر بیشتری از v4.3 دارد:
- Claude Opus 5.5 با سطح تلاش low به ۳۵ و با max به ۵۸ امتیاز میرسد؛ اختلافی ۲۳ امتیازی با ۱۰ برابر هزینه (۰٫۹۸ در برابر ۱۰٫۰۴ دلار)
- اختلاف Claude Sonnet 5.5 میان کمترین و بیشترین سطح تلاش ۲۹ امتیاز است؛ این عدد در v4.3 برابر ۲۰ بود
- اختلاف GPT-6.1 Sol دو برابر شده و از ۱۰ به ۲۰ امتیاز رسیده است
مصرف بیشتر توکن
همهٔ مدلهای آزمودهشده در هر وظیفه توکن خروجی بیشتری از v4.3 تولید میکنند. میانهٔ توکن خروجی دوسوم بیشتر شده و از ۳۵ هزار به ۵۹ هزار رسیده است.
بیشتر این مصرف از ارزیابیهای عاملمحور است. چهار محک Terminal-Bench-Science و Terminal-Bench 4.0 و AA-Briefcase و FrontierCode 2.0، ۵۵ درصد وزن شاخص را دارند، اما میانهٔ سهمشان از توکنهای خروجی حدود ۹۰ درصد است. Terminal-Bench-Science بهتنهایی حدود یکسوم توکنهای خروجی هر وظیفه را مصرف میکند.
شاخص پیشرفت v1
آرتیفیشال آنالیسیس در کنار v5، شاخص پیشرفت v1 را هم عرضه کرده است. این شاخص مدلهای زبانی منتشرشده از نوامبر ۲۰۲۲ به بعد را روی یک مقیاس پیوستهٔ توانایی و با طیف گستردهای از محکها قرار میدهد. با آن میتوان تغییر توانایی پایه را در طول زمان سنجید، حتی میان مدلهایی که سالها فاصله دارند.
به گفتهٔ این مؤسسه، شاخص هوش همچنان معیار اصلی سنجش مدلها برای کاربردهای امروز است. طراحی شاخص پیشرفت از تجربهٔ شاخص تواناییهای Epoch AI بهره گرفته و آرتیفیشال آنالیسیس از Epoch AI و آنتروپیک قدردانی کرده است. روندها در نشانی artificialanalysis.ai/trends و روششناسی در artificialanalysis.ai/methodology/progress-index در دسترس است.
سازندگان محکها
- Cognition: FrontierCode 2.0
- Steven Dillmann و تیم Terminal-Bench: Terminal-Bench-Science و Terminal-Bench 4.0
- مرکز ایمنی هوش مصنوعی و Scale AI: HLE-Diamond و Humanity's Last Exam
- Minhui Zhu و Minyang Tian و Hao Peng و تیم CritPt: CritPt v2
نتایج کامل در artificialanalysis.ai و روششناسی شاخص هوش در artificialanalysis.ai/methodology/intelligence-benchmarking منتشر شده است.
این تغییرات چه نشان میدهد
غلبهٔ محکهای خصوصی و مقاوم در برابر آلودگی داده نشان میدهد ارزیابی مدلها پختهتر شده است. سهبرابر شدن شکاف وزنهای باز، با وجود عرضهٔ مدلهای باز تازه، از برتری فزایندهٔ دادههای اختصاصی و محاسبات آموزشی در وظایف عاملمحور و کار با ابزار حکایت دارد.
تفاوت ۱۳ برابری هزینه هم یعنی انتخاب مدل دیگر فقط با نگاه به امتیاز کلی ممکن نیست و باید هزینه را در برابر توانایی سنجید. شاخص پیشرفت نیز امکان مقایسهٔ مدلهای امروز و دیروز را روی یک معیار مشترک فراهم میکند و میتواند روشن کند که آیا قوانین مقیاسپذیری در حال کند شدن است.
پرسش بعدی این است که جامعهٔ پژوهشی تا چه حد از زیرمجموعهٔ عمومی AA-Omniscience استفاده میکند و آیا ارزیابهای دیگر هم به دادههای خصوصی و نگهداشتهشده روی میآورند. بازنگری بعدی شاخص احتمالاً نشان میدهد شکاف وزنهای باز با گسترش محکهای عاملمحور ثابت میماند یا بیشتر میشود.
گام بعدی شما
- اگر هزینه برایتان تعیینکننده است، GPT-6.1 Terra (max) ارزانترین مدل میان ۱۰ مدل برتر است و GPT-6.1 Sol (max) با حدود یکهشتم هزینهٔ Opus، کمتر از ۴ امتیاز از آن عقب است.
- برای وظایف علمی عاملمحور، GPT-6 Astra در Terminal-Bench-Science و CritPt v2 اول است؛ Claude Opus 5.5 در HLE-Diamond و AA-Omniscience v1.1 پیشتاز است.
- برای مقایسهٔ نسلهای مختلف مدلها با فاصلهٔ چندساله، از شاخص پیشرفت v1 استفاده کنید.

گفتگو