پرش به محتوای اصلی

دسته‌بندی

تحلیل و بررسی تخصصی

تحلیل‌های عمیق مدل‌ها، مقالات و بنچمارک‌ها — پیش‌چاپ‌ها، ارزیابی‌ها، مدل‌های زبانی پیشرو و پژوهش همراستاسازی.

۶٬۸۲۳ مقاله منتشر شده

آموزش کاربردی

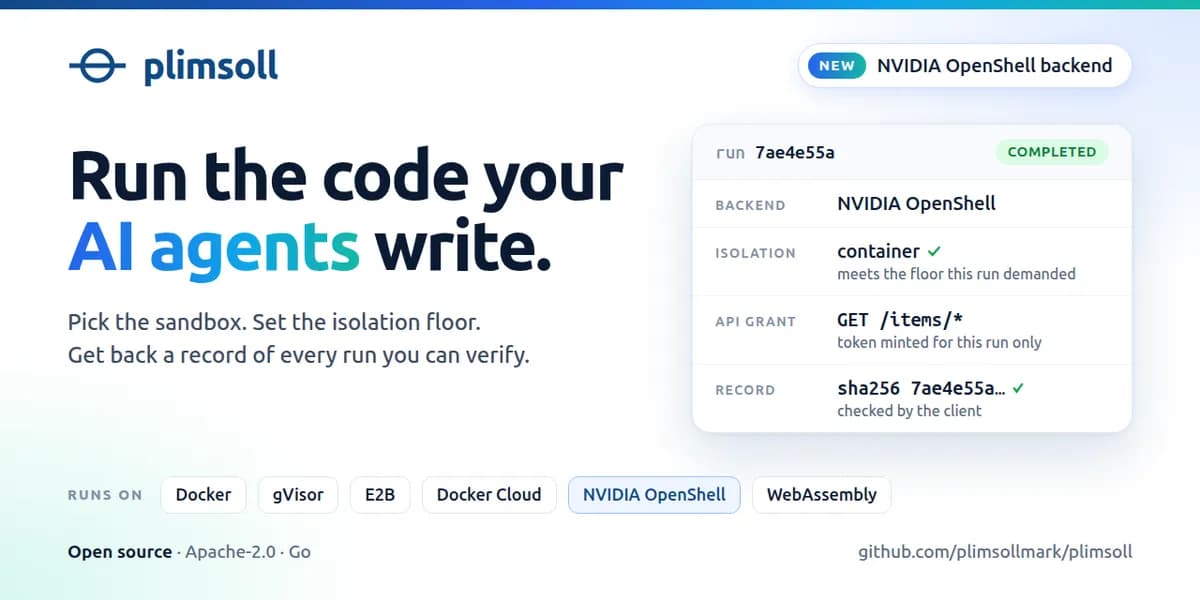
Plimsoll امنیت کدِ عامل‌های هوش مصنوعی را با لایه‌های جداسازی تأییدپذیر تضمین

سرویس Plimsoll محیطی ایزوله (Sandbox) فراهم می‌کند که کدهای تولیدشده توسط هوش مصنوعی را اجرا کرده و سطح دقیق امنیت لایه جداسازی را گزارش می‌دهد. توسعه‌دهندگان می‌توانند حداقل سطح…

۱۶ دقیقه خواندن

Sakana AI نمرات پژوهشی مدل‌ها را با نظارت خودکار ۱.۶ برابر افزایش داد

شرکت Sakana AI چارچوبی به نام MASS را معرفی کرد که به مدل‌های هوش مصنوعی اجازه می‌دهد بدون نیاز به داده‌های انسانی، از طریق یک چرخه خودبه‌بهبود، استدلال‌های پژوهشی خود را ارتقا…

۱۶ دقیقه خواندن

چرا بهره‌وری در عصر مدل‌های زبانی تنها برای نخبگان فنی افزایش یافت

آندری کارپاتی معتقد است فاصله عمیقی میان کاربران عادی و نخبگان فنی ایجاد شده است. در حالی که اکثریت مدل‌ها را ابزاری برای چت می‌بینند، اقلیتی کوچک با استفاده از سیستم‌های پیشرو،…

۳ دقیقه خواندن

محک جدید: مدل‌های کوچک در کپی عین متن از مدل‌های بزرگ‌تر برترند

یک محک جدید نشان می‌دهد مدل‌های هوش مصنوعی دیگر به‌طور خودکار غلط‌های املایی در نقل‌قول‌ها را اصلاح نمی‌کنند. در این میان، مدل‌های کوچک‌تر در تشخیص مرز جملات و حفظ عینیت متن،…

۹ دقیقه خواندن
آموزش کاربردی

«حفره‌های امنیتی خطرناک»؛ پیامد ترکیب طرح‌واره و هندلرهای اجرا در AI

ترکیب طرح‌واره‌های ابزار و هندلرهای اجرا در یک درخواست واحد، حفره‌های امنیتی خطرناکی ایجاد می‌کند. چارچوب جدیدی پیشنهاد می‌دهد که برای جلوگیری از اجرای دستورات سیستمی غیرمجاز،…

۷ دقیقه خواندن
آموزش کاربردی

تفکیک خطاهای زیرساختی از نقص استدلال در ارزیابی مدل‌های هوش مصنوعی

یک چارچوب ارزیابی جدید پیشنهاد می‌کند که خطاهای عملیاتی مانند قطع شدن پاسخ‌ها به دلیل محدودیت توکن، نباید با شکست‌های استدلالی مدل یکی شوند. با دسته‌بندی دقیق نوع شکست‌ها،…

۸ دقیقه خواندن
آموزش کاربردی

مدل‌های کوچک در عیب‌یابی خطوط داده از مدل‌های پرچم‌دار پیشی گرفتند

یک محک جدید نشان می‌دهد مدل‌های زبانی کوچک و ارزان در شناسایی فقدان داده در خطوط لوله‌ (Pipelines) دقیق‌تر از مدل‌های گران‌قیمت هستند. این مطالعه ثابت می‌کند که دستورالعمل‌های…

۷ دقیقه خواندن

تیم‌های عامل در برابر مدل‌های تک‌عاملی؛ سرعت بیشتر با کیفیت مشابه

پژوهش‌های جدید نشان می‌دهد استقرار تیم‌های عامل به‌جای مدل‌های تک‌عاملی، هزینه توکن‌ها را به‌شدت افزایش می‌دهد بدون آنکه بهبود ملموسی در کیفیت خروجی ایجاد کند. این سامانه‌ها بیشتر…

۳ دقیقه خواندن
آموزش کاربردی

چرا تیترهای ساده می‌توانند سیستم‌های نظارتی حافظه AI را دور بزنند؟

یک نقص فنی در ابزارهای بازبینی حافظه باعث می‌شود دستورات متناقض، در صورت استفاده از فرمت تیتر (Markdown Heading)، به‌عنوان دستورات ایمن شناسایی شوند. راهکار این مشکل، پیاده‌سازی…

۸ دقیقه خواندن
آموزش کاربردی

«شناسایی کدهای گمراه‌کننده»؛ قابلیت جدید Gemini 2.5 در بازبینی Unlearning

یک محک جدید نشان می‌دهد مدل‌های Gemini 2.5 می‌توانند اسکریپت‌های گمراه‌کننده PyTorch را که برای حذف داده‌های کاربر طراحی شده‌اند، شناسایی و اصلاح کنند. با این حال، این مطالعه…

۵ دقیقه خواندن