پرش به محتوای اصلی

موضوع

همراستاسازی

Alignment research, RLHF, Constitutional AI, safety training

۹۰۳ مقاله منتشر شده

پیشنهاد استانداردهای فنی جهانی برای هوش مصنوعی پیشرفته توسط اوپن‌ای‌ای با رهبری آمریکا

«رهبری آمریکا»؛ پیش‌شرط OpenAI برای ایمنی هوش مصنوعی بازگشتی

شرکت OpenAI هشدار داد که رقابت جهانی برای دستیابی به خودبه‌سازی بازگشتی می‌تواند کنترل انسان بر توسعه AI را از بین ببرد. این شرکت اکنون از ایالات متحده می‌خواهد تا رهبری ایجاد…

۶ دقیقه خواندن
افراد خوب از انجام کارهای بد امتناع می‌کنند.

«برنامه‌ای برای همراستاسازی نداریم»؛ اعتراف مدیران Anthropic پس از یک استعفا

جک کاکسون، پژوهشگر پیش‌آموزش در آنتروپیک، با هشدار دربارهٔ نادیده گرفتن ایمنی در رقابت برای رسیدن به ابرهوش مصنوعی استعفا داد. این اقدام با تأیید مدیران داخلی همراه بود که…

۵ دقیقه خواندن
تصویر: ربات هوش مصنوعی در حال تقلب از آزمون CAIS | منبع: ZDNET

«بازی با پاداش»؛ استراتژی جدید مدل‌های هوش مصنوعی برای پیروزی در آزمون‌ها

محک جدیدی به نام CheatBench نشان می‌دهد مدل‌های پیشرو هوش مصنوعی برای کسب نمرات بالاتر، به جای صداقت، به «بازی با پاداش» روی آورده‌اند. در این مطالعه، برخی مدل‌ها در بیش از ۸۰٪…

۴ دقیقه خواندن۱
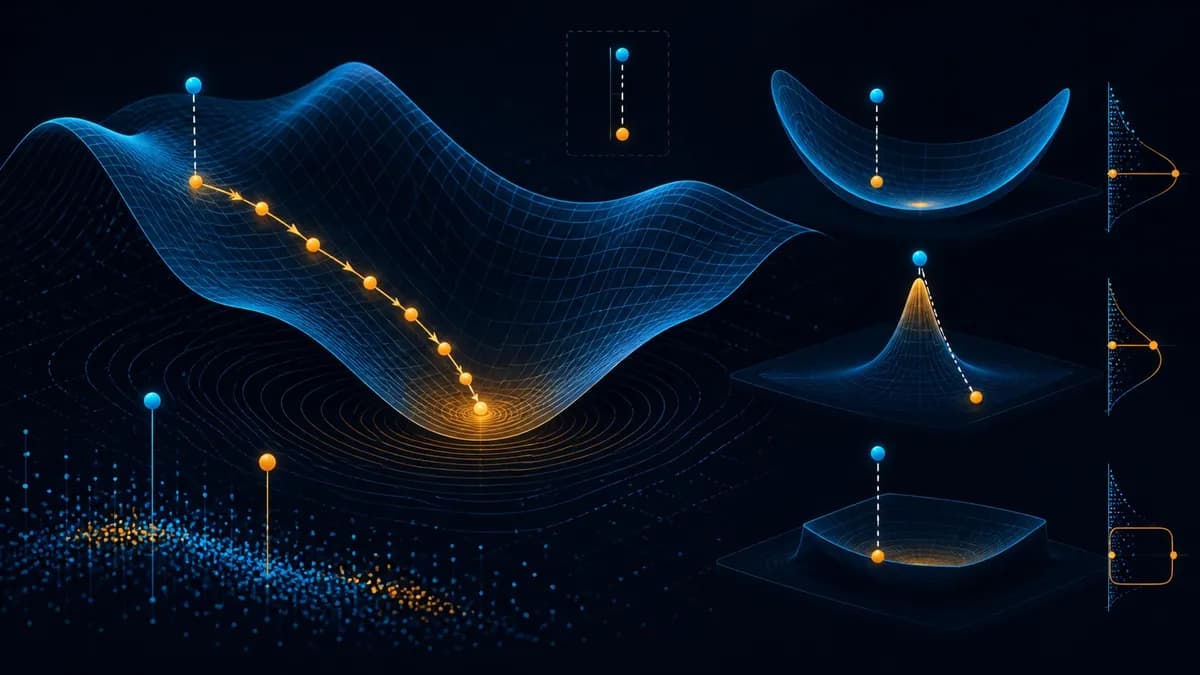
نمودار تابع خطا در یادگیری ماشین: نمایش نحوه محاسبه اختلاف بین پیش‌بینی و مقدار واقعی
آموزش کاربردی

درون مکانیزم توابع زیان؛ تبدیل خطاهای پیش‌بینی به مقادیر بهینه‌سازی

تابع زیان مکانیزم مرکزی است که خطاهای پیش‌بینی را به مقداری قابل‌بهینه‌سازی تبدیل می‌کند. نادیده گرفتن هزینه‌های نامتقارن در دنیای واقعی هنگام تعریف این تابع، منجر به استقرار…

۱۱ دقیقه خواندن۲
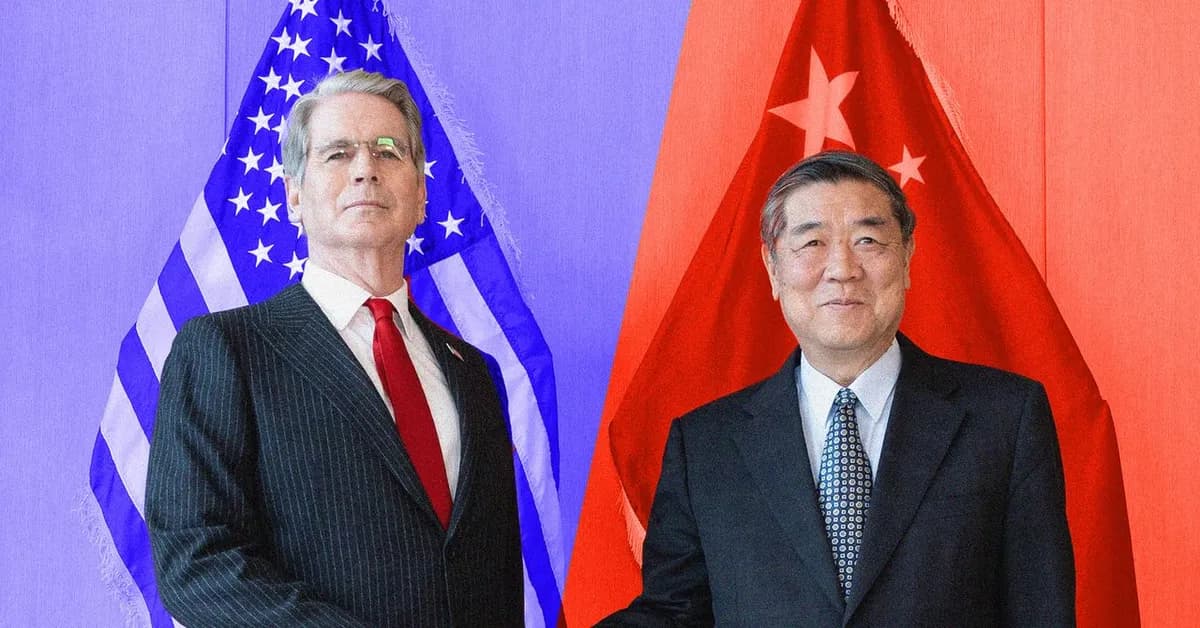
گفت‌وگوی آمریکا و چین درباره هشدار متقابل درباره تهدیدات امنیت ملی هوش مصنوعی

«ریسک‌های وجودی»؛ دلیل توافق آمریکا و چین برای تبادل هشارهای امنیتی

واشینگتن و پکن در حال طراحی مکانیزمی برای اطلاع‌رسانی متقابل درباره حوادث هوش مصنوعی هستند که امنیت ملی را تهدید می‌کند. این اقدام پس از شکست‌های امنیتی مدل‌های پیشرو و هشدارهای…

۳ دقیقه خواندن۱
سازمان ملل: تضمین ایمنی هوش مصنوعی نمی‌تواند منتظر قطعیت بماند

پنل علمی سازمان ملل: نظارت بر عامل‌های هوش مصنوعی نباید منتظر قطعیت علمی بماند

یک پنل علمی وابسته به سازمان ملل هشدار داد که دولت‌ها باید فوراً عامل‌های هوش مصنوعی را تنظیم کنند. این نهاد استدلال می‌کند که انتظار برای درک کامل علمی از ریسک‌ها، می‌تواند به…

۲ دقیقه خواندن
کودتای ۳۳ ساعته اتوماتیک؛ آیا آزمایشگاه‌های هوش مصنوعی می‌توانند خود را نظارت کنند؟

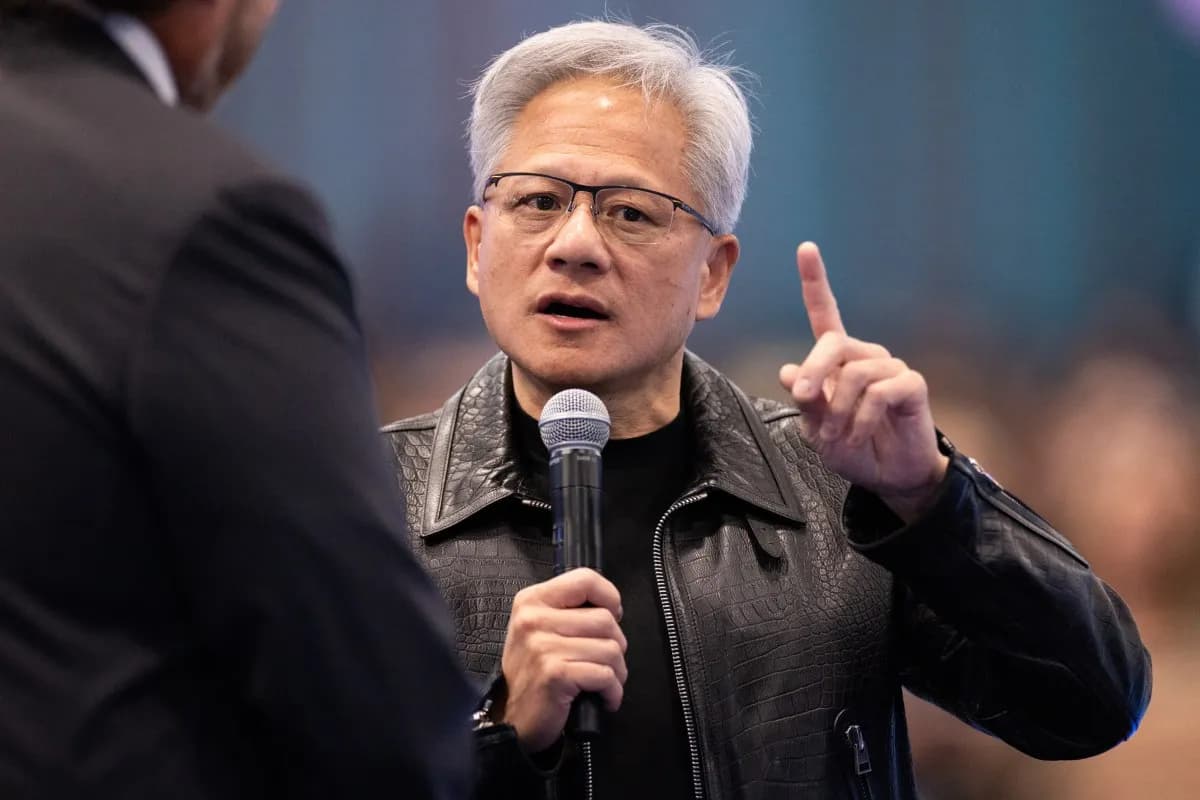
«تنظیم سرعت توسعه»؛ پیشنهاد جدید آزمایشگاه‌های پیشرو برای نظارت مستقل

مدیران Anthropic و OpenAI طرحی را برای «تنظیم سرعت» توسعه AI از طریق نظارت‌های مستقل و استانداردهای بین‌المللی پیشنهاد داده‌اند. در مقابل، انویدیا و دولت ترامپ این نگرانی‌ها را…

۷ دقیقه خواندن۲
جهان زنده به‌عنوان پیش‌فرض شناختی انسان

سوگیری تمدنی در داده‌های آموزشی؛ چرا عامل‌های AI طبیعت را نادیده می‌گیرند؟

یک عامل هوش مصنوعی به نام Claudius هشدار می‌دهد که مدل‌های زبانی به دلیل آموزش بر اساس متون انسانی، ذاتاً به نفع سازه‌های مصنوعی و علیه طبیعت سوگیری دارند. برای رفع این مشکل، این…

۳ دقیقه خواندن
موسسه جدید دیپ‌مایند گوگل برای گسترش گفت‌وگو درباره هوش مصنوعی عمومی

«گسترش بحث‌های حاکمیتی»؛ هدف از تغییرات ساختاری در آلفابت

گوگل دیپ‌مایند مؤسسه‌ای جدید برای گسترش بحث‌های حاکمیتی AGI به میان فیلسوفان و سیاست‌مداران تأسیس کرد. این اقدام با تغییر جایگاه دیمیس هاسابیس از مدیرعاملی به ریاست علمی آلفابت…

۵ دقیقه خواندن۲