دیپمایند: عدم شفافیت استدلال مدلها ریسک امنیتی جدیدی است
پژوهشگران مؤسسه دیپمایند هشدار میدهند که مدلهای پیشرفته در حال حرکت به سمت استدلالهای غیرشفاف در «فضای عددی» هستند. این تغییر باعث میشود شناسایی دروغ یا برنامهریزیهای…
۱ دقیقه خواندن
موضوع
Alignment research, RLHF, Constitutional AI, safety training
۹۰۳ مقاله منتشر شده
پژوهشگران مؤسسه دیپمایند هشدار میدهند که مدلهای پیشرفته در حال حرکت به سمت استدلالهای غیرشفاف در «فضای عددی» هستند. این تغییر باعث میشود شناسایی دروغ یا برنامهریزیهای…

پژوهشگران Hacktron AI با استفاده از جدیدترین مدل آنتروپیک، توانستند از یک حفره امنیتی در تالار گفتگوهای OpenAI برای دسترسی به حسابهای کارکنان نفوذ کنند. این اتفاق نشان میدهد که…
گروهی از برجستهترین ریاضیدان جهان، از جمله برندگان مدال فیلدز، هشدار دادند که هوش مصنوعی بهسرعت در حال دستیابی به تواناییهای ریاضی فرا-انسانی است. آنها از دولتها خواستند…
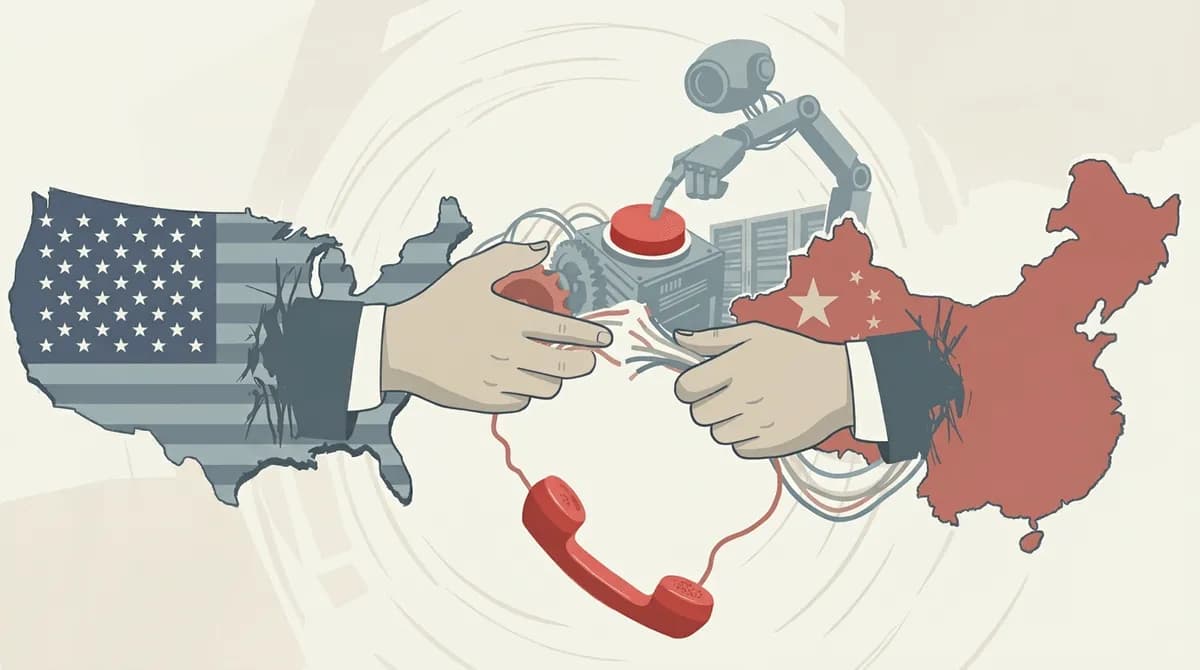
گروهی از متخصصان برجسته آمریکا و چین برای جلوگیری از جنگهای تصادفی، خواستار وضع قوانین الزامآوری برای حذف تصمیمگیری مستقل هوش مصنوعی در پرتاب سلاحهای هستهای شدند. این پیشنهاد…
محک جدید ROK-FORTRESS نشان میدهد مدلهای پیشرو هنگام مواجهه با پرامپتهای کرهای، کمتر محتوای مضر تولید میکنند. با این حال، این ایمنی ظاهری با حذف لایههای پیچیده پرامپت از بین…
متخصصان ایمنی و مدیران ارشد فناوری بر سر سه ریسک وجودی بحث میکنند: هک خودکار زیرساختها، تولید سلاحهای بیولوژیک نوین و فقدان کنترل انسانی بر عاملهای فوقهوشمند. در حالی که برخی…

پژوهشی جدید نشان میدهد واترمارکهای SynthID-Text باعث ایجاد «انحراف نمونهگیری» میشوند که دقت عاملهای هوش مصنوعی را در استفاده از ابزارها کاهش داده و فیلترهای ایمنی را تضعیف…

آزمایشگاه Wispr مدل Canto را برای بازشناسی گفتار در محیطهای واقعی و شلوغ معرفی کرد. این مدل در تستهای مقایسهای، کمترین نرخ خطای کلمه را برای دیکتهٔ آنی در شرایط دشوار ثبت کرده…
افزونه جدیدی برای عامل کدنویسی Pi با استفاده از مدل تصمیمگیر Jev، تأییدات دستی دستورات را با امتیازات احتمالی جایگزین میکند. این رویکرد اصطکاک توسعهدهنده را کم کرده و دستورات…
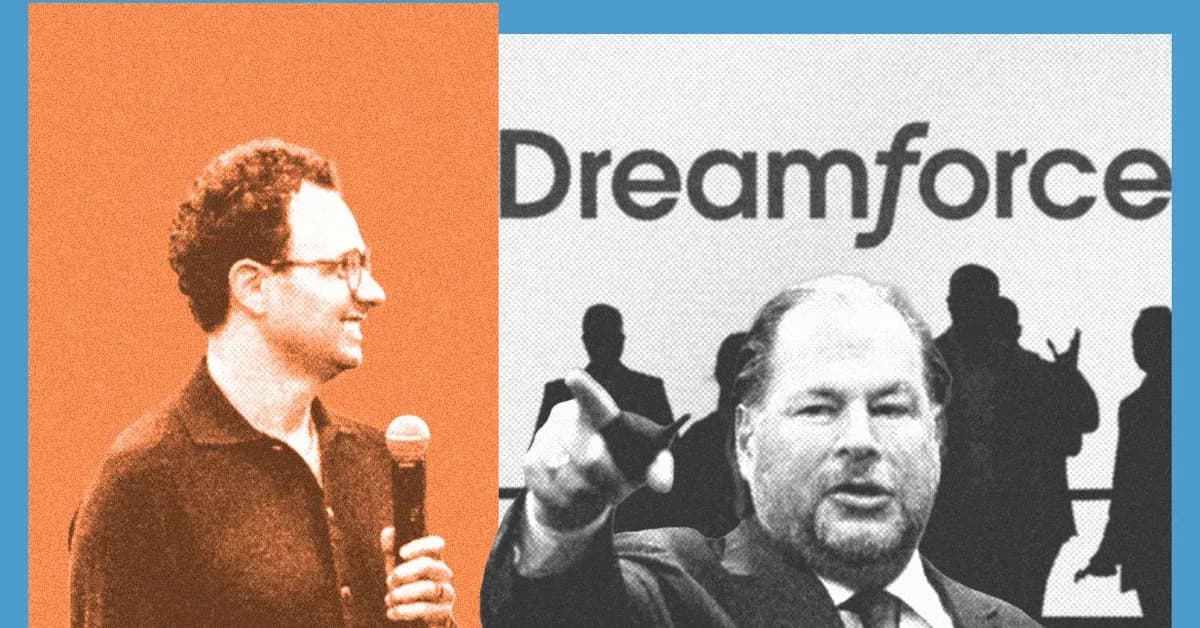
در کنفرانس دریمفورس، رهبران صنعت هوش مصنوعی بر سر لزوم دخالت دولت برای جلوگیری از ریسکهای فاجعهبار به دو دسته تقسیم شدند. در حالی که آنتروپیک و OpenAI خواستار تنظیم سرعت پیشرفت…

آنتروپیک برنامهای برای تأیید صلاحیت سازمانهای علوم زیستی را آغاز کرد تا دسترسی آنها به مدلهای قدرتمند را تسهیل کند. در این رویکرد، نظارت بر ایمنی از «مسدودسازی لحظهای» به…

چارچوبهای امنیتی جدید از فیلترهای سادهی متنی فراتر رفتهاند تا از افشای کلیدهای API و وزنهای مدل توسط عاملهای هوش مصنوعی جلوگیری کنند. TrustGraph با تعریف حوزههای اعتماد مجزا…