پرش به محتوای اصلی

موضوع

بازیابی‌افزا

RAG architectures, vector stores, grounding LLMs in private data

۱٬۱۱۲ مقاله منتشر شده

سلامت داده‌محور: کنترل ضروری مدل زبانی بزرگ
آموزش کاربردی

استقرار درون‌سازمانی مدل‌های زبانی؛ راهکار مقابله با نشت داده‌های پزشکی

سازمان‌های بهداشتی برای حفظ حاکمیت داده‌های حساس بیماران، از استنتاج محلی هوش مصنوعی استفاده می‌کنند. این رویکرد اجازه می‌دهد جریان‌های کاری بالینی بدون ریسک انتقال داده به…

۴ دقیقه خواندن۳
استفاده از مدل‌های زبانی بزرگ چینی در پردازش زبان فارسی
آموزش کاربردی

درگاه‌های سازگار با OpenAI دسترسی به مدل‌های چینی را تسهیل کردند

توسعه‌دهندگان خارج از چین اکنون می‌توانند با استفاده از درگاه‌های واسط و یک API واحد، محدودیت‌های سخت‌گیرانهٔ احراز هویت و پرداخت مدل‌های برتر چینی را دور بزنند. این سازوکار…

۲ دقیقه خواندن۱
راهنمای توسعه‌دهندگان خارجی برای انتخاب بهترین API مدل زبانی چینی در سیستم‌های RAG
آموزش کاربردی

«جایگزین‌های اقتصادی»؛ نقش مدل‌های چینی در بهینه‌سازی هزینه‌های توسعه

مدل‌های Qwen و DeepSeek با ارائه کیفیت دوزبانه بالا و قیمت بسیار پایین، جایگزین‌های اقتصادی برای سیستم‌های RAG شده‌اند. توسعه‌دهندگان اکنون می‌توانند از طریق نقاط اتصال یکپارچه،…

۱ دقیقه خواندن۱
دستیار هوشمند JD AI در مرکز عملیات جان دیر راه‌اندازی شد

دستیار هوش مصنوعی جان دیر داده‌های خصوصی مزارع را برای بهینه‌سازی برداشت تحلیل

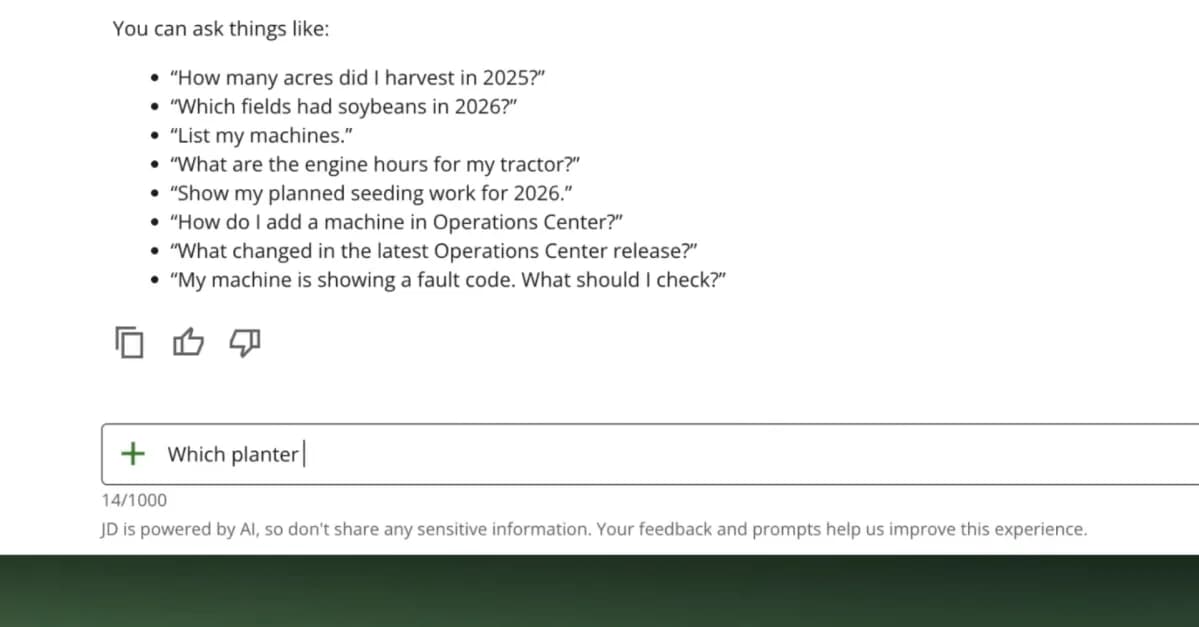
شرکت جان دیر دستیار هوش مصنوعی JD را معرفی کرد تا کشاورزان بتوانند به‌جای تحلیل دستی جداول پیچیده، با زبان طبیعی از داده‌های ماشین‌آلات خود تحلیل بگیرند. این ابزار هدفش تبدیل…

۴ دقیقه خواندن
ربات گفتگوی هوش مصنوعی جان دیر برای کشاورزان

دستیار هوش مصنوعی جان دیر داده‌های خصوصی مزارع را برای بهینه‌سازی برداشت تحلیل

شرکت جان دیر آزمایش دستیار هوش مصنوعی JD را آغاز کرد تا با تحلیل داده‌های عملیاتی هر مزرعه، توصیه‌های تجاری شخصی‌سازی‌شده ارائه دهد. هدف این ابزار افزایش سودآوری از طریق…

۲ دقیقه خواندن
کیفیت RAG شما به خوبی شواهدی بستگی دارد که نمایه برداری برداری بازیابی می‌کند.
آموزش کاربردی

انتخاب اشتباه ایندکس برداری باعث شکست RAG در مقیاس بالا می‌شود

بسیاری از توهمات در سامانه‌های RAG نه به دلیل ضعف مدل زبانی، بلکه ناشی از شکست ایندکس برداری در بازیابی شواهد درست هنگام رشد داده‌هاست. انتخاب استراتژی نادرست ایندکسینگ منجر به…

۲ دقیقه خواندن۱
ادغام ChatGPT Health با سیستم Epic برای دسترسی پزشکان به اطلاعات بیماران

دسترسی ChatGPT به پرونده‌های ۳۲۵ میلیون بیمار در سامانه Epic

اوپن‌ای‌آی با ادغام ChatGPT Health در سامانه پرونده‌های الکترونیک Epic، امکان تحلیل تاریخچه پزشکی و خلاصه‌سازی داده‌های بیماران را برای پزشکان فراهم کرد. این سیستم برای جلوگیری از…

۲ دقیقه خواندن۱
پرپلکسیی محاسبات ترکیبی را با حریم خصوصی محلی روی مک راه‌اندازی کرد

«دروازه حریم خصوصی»؛ رویکرد جدید پراپلسیتی برای مدیریت داده‌های حساس

پراپلسیتی قابلیتی را برای مک معرفی کرد که داده‌های حساس را به‌صورت محلی پردازش می‌کند و تنها برای استدلال و جست‌وجو از ابر استفاده می‌کند. این سامانه با یک «دروازه حریم خصوصی»…

۴ دقیقه خواندن۱
زمینه کسب‌وکار باید زیرساخت باشد، نه متن پرامپت
آموزش کاربردی

Evidensiq: تبدیل بستر کسب‌وکار از متنِ پرامپت به زیرساختِ قابل‌ردیابی

مشخصات متن‌باز Evidensiq با هدف انتقال دانش کسب‌وکار از پرامپت‌ها به یک زیرساخت قابل‌حمل و مبتنی بر شواهد معرفی شده است. این استاندارد مشکل تضاد در منابع داده و نبود قابلیت ردیابی…

۴ دقیقه خواندن۲
بازده سرمایه‌گذاری مغز سازمانی: شواهد واقعی برای مدیران اجرایی
آموزش کاربردی

درون استراتژی Cipla برای جایگزینی حذف کارکنان با سرعت در پاسخ‌دهی

داده‌های جدید نشان می‌دهد ارزش واقعی هوش مصنوعی در سازمان‌ها، نه در کاهش تعداد کارکنان، بلکه در حذف فاصله زمانی بین پرسش و پاسخ‌های قابل‌اتکا است. در شرکت Cipla، استقرار این…

۲ دقیقه خواندن۲